VulnBump : les agents IA peuvent-ils corriger les dépendances vulnérables sans casser la build ?


15 octobre 2026
0 minutes de lectureLes agents IA peuvent-ils corriger les dépendances vulnérables sans casser la build ? La correction elle-même est rarement mystérieuse. Au cours des six premiers mois de 2026, Snyk Open Source a détecté 459 millions de vulnérabilités dans environ 300 000 organisations. 94 % de ces vulnérabilités disposaient d’une version corrigée connue, mais seules 10 % environ avaient été résolues.
La difficulté consiste à effectuer la mise à niveau en toute sécurité : la plupart des packages vulnérables sont importés de manière transitive, environ un quart des corrections nécessitent une mise à niveau majeure, et même les versions mineures et correctives, censées assurer la rétrocompatibilité, introduisent souvent des changements incompatibles.
VulnBump, une nouvelle étude publiée par Snyk, met à l’épreuve des agents IA sur 307 mises à niveau réelles de dépendances vulnérables. Une mise à niveau est considérée comme RÉUSSIE uniquement si les vulnérabilités ont disparu et que le projet s’installe toujours, se compile et passe ses tests.
Quoi de neuf : à notre connaissance, VulnBump est le premier benchmark d’agents IA consacré aux mises à niveau motivées par la sécurité : chaque tâche commence par des vulnérabilités réelles détectées par Snyk dans un projet réel, avec six gestionnaires de packages. Les benchmarks de mise à niveau précédents vérifient uniquement l’absence de régression, pas la disparition de la vulnérabilité.
Alors, les agents IA peuvent-ils corriger des dépendances vulnérables sans casser la build ? En général, oui, mais le modèle ne fait pas tout. Avec le même modèle, Claude Sonnet 5.5, Evo Remediation Agent de Snyk a réussi 90,2 % des mises à niveau. Claude Code d’Anthropic a réussi 77,5 % des mises à niveau avec la recommandation et l’analyse de Snyk (Claude Code + analyse Snyk), et 59,6 % sans données Snyk (Claude Code sans assistance). L’écart dépasse 30 points de pourcentage. À titre de référence, la mise à niveau par le gestionnaire de packages, une approche de base sans IA qui applique uniquement la version recommandée par Snyk, a déjà réussi dans 46,9 % des cas.
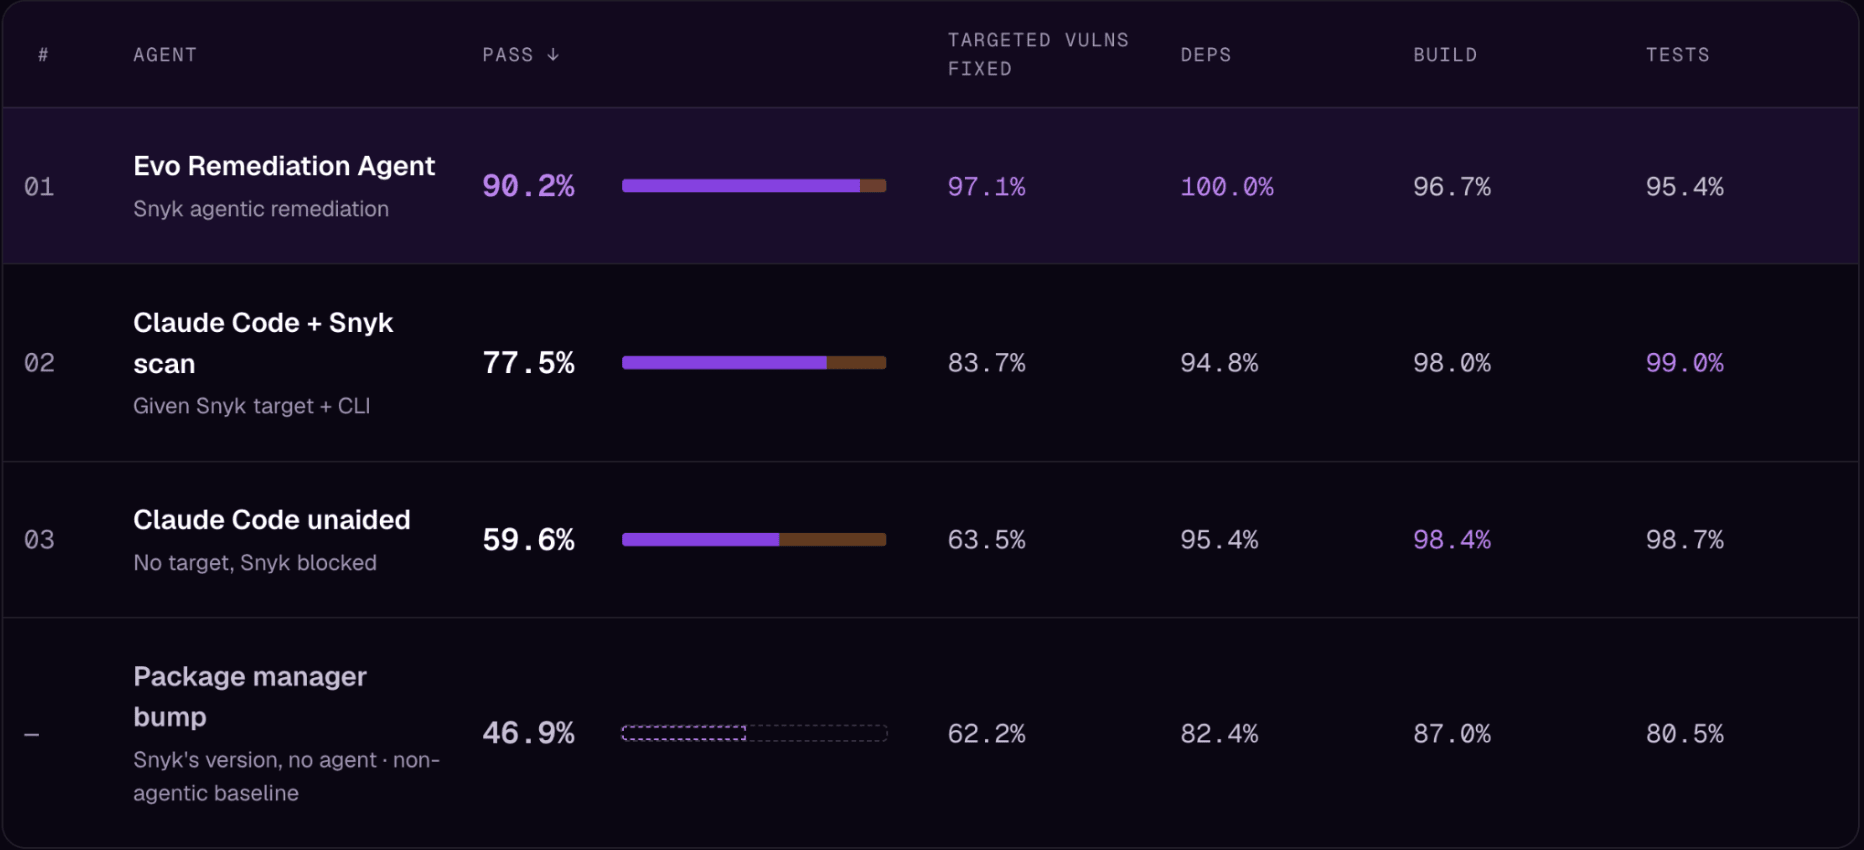
Principaux résultats de VulnBump
Maintenir la build au vert n’était pas la difficulté : les trois agents y sont parvenus environ 93 % du temps. Supprimer la vulnérabilité, en revanche, oui. Dans 70 de ses 124 échecs, Claude Code, sans assistance, a déclaré avoir corrigé des vulnérabilités toujours détectées par une nouvelle analyse.
Nos résultats font écho à VulnBench, notre benchmark de juin sur l’analyse de sécurité par l’IA, qui a révélé que Claude et Snyk Code ne détectent pas les mêmes vulnérabilités et conclu que les deux fonctionnent mieux ensemble. VulnBump évalue une autre tâche, la mise à niveau de dépendances open source vulnérables, et aboutit à la même conclusion : avec la version recommandée et l’analyse de Snyk, le taux de réussite de Claude Code a augmenté de 17,9 points. Evo Remediation Agent montre jusqu’où peut aller un agent spécialement conçu pour cette tâche : 12,7 points de plus que Claude Code avec la même analyse Snyk. VulnBump prolonge aussi les résultats de remédiation publiés en mai, avec un modèle plus récent et six gestionnaires de packages.
Comment nous avons conçu VulnBump
Nous sommes partis de projets réels représentatifs de la production. Nous avons collecté 767 projets candidats sur GitHub, dont des projets open source populaires et des dépôts qui épinglent des packages vulnérables connus. Avant toute modification, chacun devait s’installer, se compiler et réussir plus de 85 % de ses tests, et Snyk devait y détecter au moins une vulnérabilité. Parmi les 99 projets retenus, nous en avons sélectionné 43 représentatifs des données de production de Snyk en matière d’écosystème, de gravité des vulnérabilités, de dépendances directes vs transitives et d’ampleur du saut de version.

Comparaison du jeu de données VulnBump avec les données de production de Snyk Open Source
Nous avons transformé chaque mise à niveau recommandée en une tâche. Chaque tâche demande à l’agent d’appliquer une mise à niveau recommandée par Snyk : un package à faire passer à une version qui corrige ses vulnérabilités. Chaque tâche commence par une copie vierge du projet et est évaluée indépendamment. Les 43 dépôts fournissent 307 tâches portant sur 2 066 vulnérabilités corrigibles, avec Maven, Gradle, npm, Yarn, pip et Poetry, les six gestionnaires de packages à l’origine d’environ 92 % des détections en production.
Nous avons ajouté un vérificateur qui ne faisait pas confiance à l’agent. À la fin de l’agent, nous avons copié ses modifications dans un conteneur propre et les avons vérifiées depuis le début. Une tentative n’était considérée comme RÉUSSIE que si elle franchissait les quatre étapes de validation :
Les dépendances s’installent avec la commande que lancerait l’intégration continue.
Une nouvelle analyse Snyk confirme la disparition des vulnérabilités.
Le projet se compile.
Tous les tests qui réussissaient avant réussissent toujours.

Le pipeline VulnBump
Les environnements de test évalués. Les trois agents ont utilisé Claude Sonnet 5.5, avec une limite de 110 étapes par mise à niveau, dans le même conteneur pour chaque langage :
Evo Remediation Agent est le moteur de remédiation agentique de Snyk. Il s’appuie sur les renseignements de Snyk et peut lancer ses propres analyses, compilations et tests, puis corriger les erreurs avant de terminer. Nous l’avons exécuté en mode d’approbation automatique : il a donc appliqué toutes les corrections, y compris les mises à niveau que Snyk considère susceptibles de casser la build.
Claude Code avec analyse Snyk est l’agent de programmation généraliste d’Anthropic, auquel nous avons fourni la recommandation de mise à niveau de Snyk : le package à mettre à niveau, la version cible et les vulnérabilités corrigées. Il peut également lancer lui-même une analyse Snyk Open Source pour vérifier son travail.
Claude Code sans assistance reçoit la même tâche, mais sans la version cible ni accès à Snyk. Il doit déterminer lui-même quelle version corrige les vulnérabilités, par exemple en consultant des bases de données de vulnérabilités sur le Web.
La mise à niveau par le gestionnaire de packages constitue la référence sans agent : elle applique la version recommandée par Snyk avec le gestionnaire de packages du projet et ne change rien d’autre.
Les critères de sélection des dépôts, les invites et outils exacts dont disposait chaque agent, ainsi que les mesures de contrôle contre les fuites de données figurent dans l’étude : VulnBump: A Benchmark for Fixing Vulnerable Dependencies in Real Projects While Keeping the Build and Tests Green, avec ses limites : nous avons testé un seul modèle, exécuté chaque mise à niveau une fois et utilisé Snyk Open Source comme juge, ce qui ne peut jouer qu’en défaveur de Claude Code sans assistance, puisque les deux autres agents travaillent à partir des mêmes détections Snyk. Nous n’avons pas non plus pénalisé les nouvelles vulnérabilités introduites par une mise à niveau.
Résultat 1 : un même modèle, trois résultats différents
Evo Remediation Agent a franchi toutes les étapes de validation pour 90,2 % des mises à niveau (et corrigé 95,9 % des 2 066 occurrences de vulnérabilité). C’est 12,7 points de plus que Claude Code + analyse Snyk, soit environ une correction fonctionnelle de plus toutes les huit mises à niveau, et 30,6 points de plus que Claude Code sans assistance.
Et le classement ne dépend pas seulement de quelques grands dépôts : en faisant la moyenne des taux de réussite par dépôt, on obtient 93,1 % pour Evo Remediation Agent, 80,1 % pour Claude Code + analyse Snyk, 68,0 % pour Claude Code sans assistance et 51,3 % pour la mise à niveau par le gestionnaire de packages.
À retenir :
Evo Remediation Agent réalise de bout en bout 9 mises à niveau sur 10 liées à des vulnérabilités.
Résultat 2 : les agents doivent savoir quelle version est réellement sûre
Avec le même modèle, fournir à Claude Code l’analyse et la mise à niveau recommandée par Snyk a augmenté son taux de réussite de 17,9 points, de 59,6 % à 77,5 %.
La différence la plus nette concerne la version choisie. Sans assistance, Claude Code a sélectionné 64 fois une version toujours signalée par Snyk. Avec l’analyse Snyk, ce chiffre est tombé à 13. Les bases de données de vulnérabilités ne s’accordent pas toujours sur la version qui corrige une vulnérabilité : une version considérée comme sûre dans une source peut donc être signalée dans une autre.
Les recommandations de Snyk sont particulièrement importantes pour les vulnérabilités transitives, dans les packages que le projet ne déclare pas directement. En ne comptant que les mises à niveau ayant franchi toutes les étapes de validation, elles ont plus que doublé la proportion de vulnérabilités corrigées par Claude Code, de 28 % à 59 %.
Résultat clé :
Le scan de Snyk et le choix de la version cible ont amélioré le taux de réussite de Claude Code de 17,9 points et plus que doublé le nombre de vulnérabilités transitives corrigées.
Résultat 3 : les recommandations de Snyk suffisent à en résoudre environ la moitié, puis les agents se démarquent sur le reste
La mise à niveau par le gestionnaire de packages divise les 307 mises à niveau en deux groupes : parmi les 144 qu’elle réussit, la version recommandée par Snyk suffit, et un agent ne peut que préserver cette correction facile ou échouer. Les 163 autres nécessitent plus qu’un changement de version, par exemple adapter le code aux changements incompatibles ou résoudre des conflits de dépendances.

Les agents sur les 144 mises à niveau résolues par les recommandations de Snyk, puis sur les 163 autres
Avec les recommandations de Snyk, les agents compromettent rarement les résultats obtenus par la mise à niveau. En revanche, Claude Code sans assistance a régressé sur 20 des 144 mises à niveau, et dans 15 cas en choisissant une version toujours signalée par Snyk. La véritable différence apparaît dans la moitié la plus difficile : parmi les 163 autres mises à niveau, Evo Remediation Agent a réussi 82,2 % des cas, Claude Code + analyse Snyk 61,3 % et Claude Code seul 36,2 %.
Résultat clé :
Parmi les 163 mises à niveau qui nécessitent davantage qu’un simple changement de version, Evo Remediation Agent a réussi dans 82,2 % des cas, contre 61,3 % pour Claude Code + Snyk scan et 36,2 % pour Claude Code sans assistance.
Résultat 4 : une build au vert peut masquer une vulnérabilité non corrigée
Le moyen le plus simple de maintenir une build au vert est de laisser la vulnérabilité en place, et c’est principalement ainsi que Claude Code a échoué. La nouvelle analyse a été la première étape de validation à échouer dans 107 des 124 échecs de Claude Code sans assistance, 48 des 69 échecs de Claude Code + analyse Snyk, contre 9 des 30 échecs d’Evo Remediation Agent.
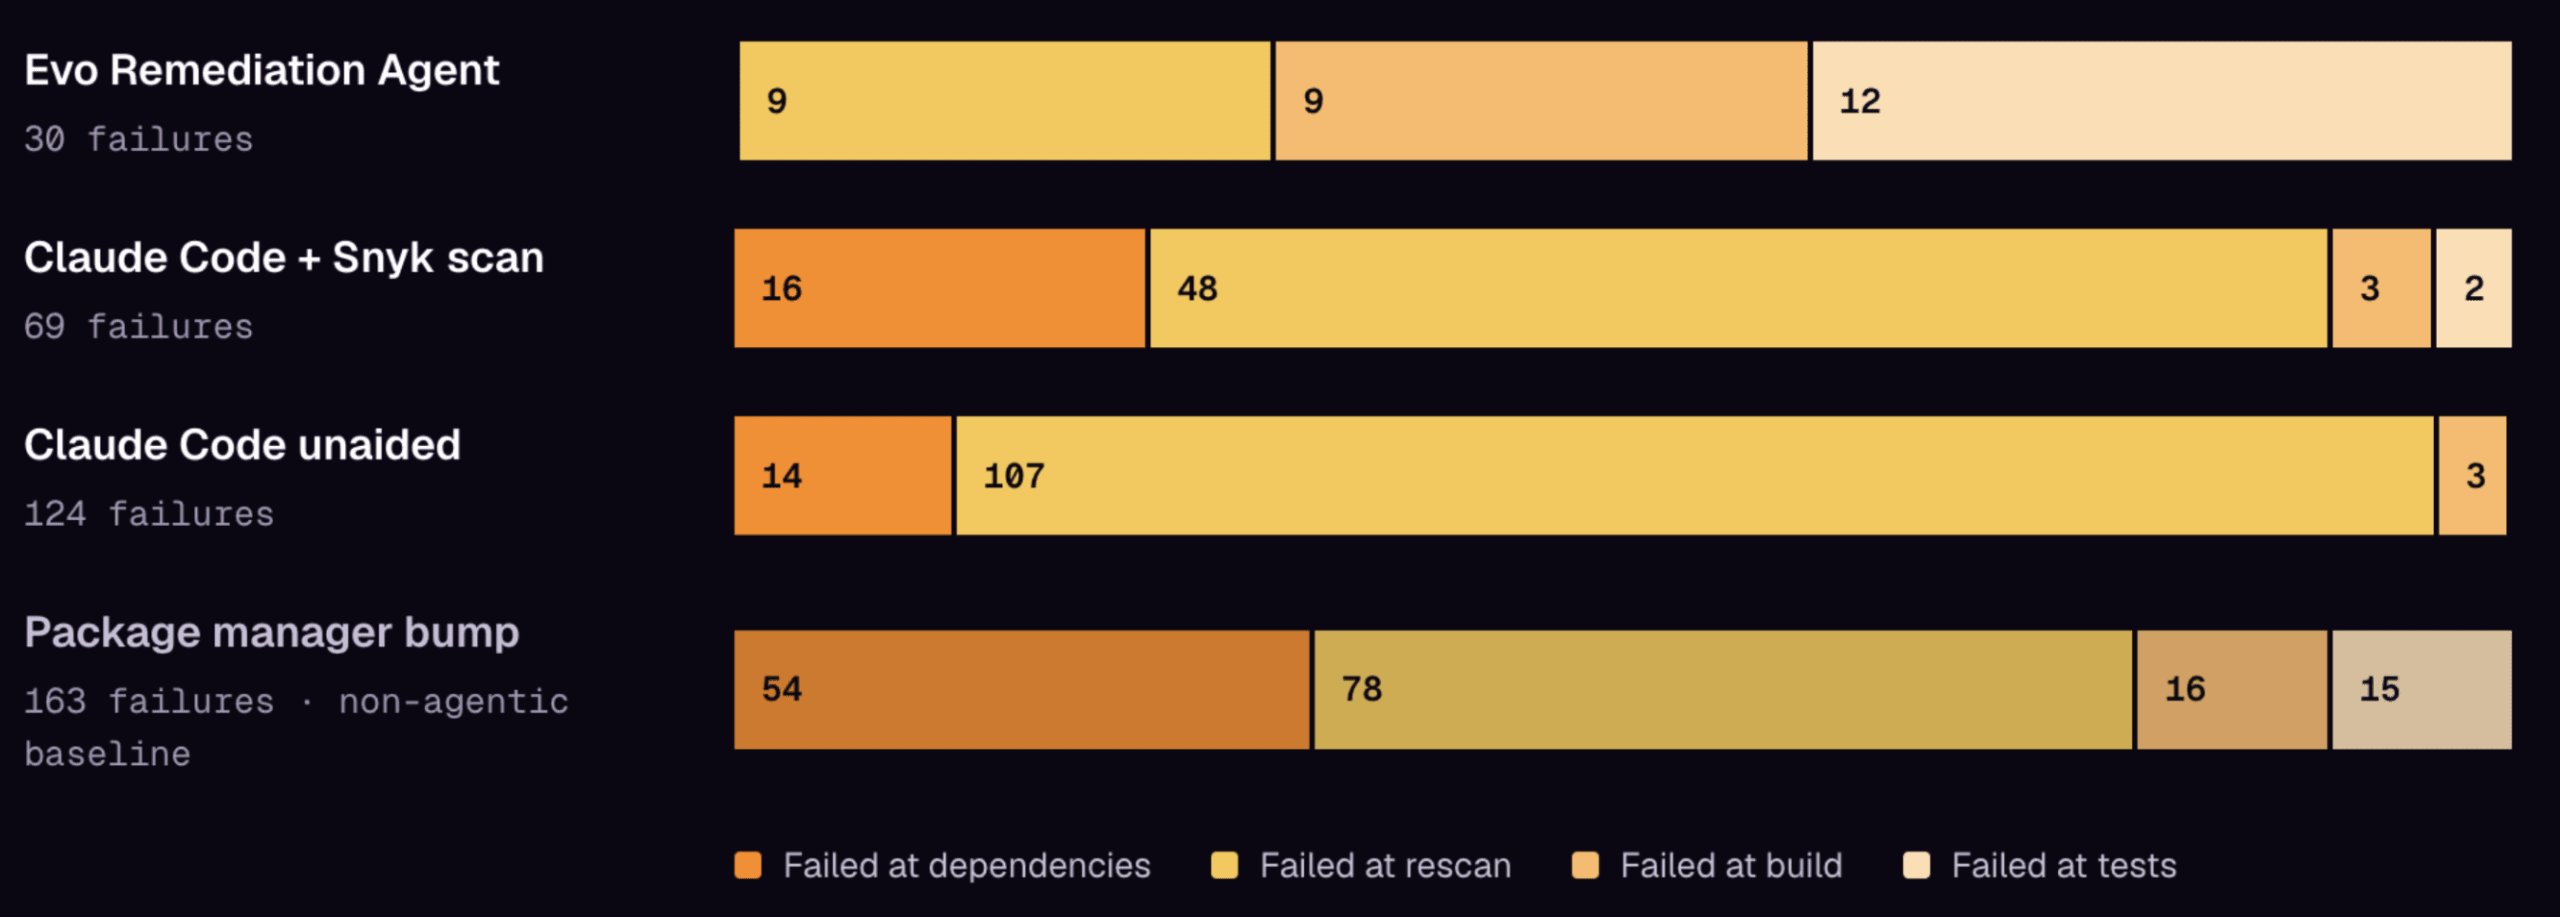
Première étape de validation ayant échoué pour chaque tentative infructueuse
Les échecs d’Evo Remediation Agent sont visibles (et ce n’est pas une mauvaise chose). 21 de ses 30 échecs ont cassé la build ou les tests, principalement lors de mises à niveau majeures que les autres agents évitaient souvent. Un échec manifeste est bien plus sûr qu’un échec silencieux : lorsqu’une mise à niveau échoue, la build et les tests du projet le révèlent, les développeurs peuvent le voir et intervenir.
Résultat clé :
Les agents généralistes échouent sans signaler le problème ; Evo Remediation Agent échoue là où la CI le détecte.
Résultat 5 : connaître la version cible ne suffit pas
L’analyse de Snyk permet à Claude Code d’aller loin, mais réussir la mise à niveau nécessite davantage : avec exactement les mêmes détections et versions cibles, Evo Remediation Agent a réussi 39 mises à niveau de plus que Claude Code avec analyse Snyk, dont 23 mises à niveau majeures.
Evo Remediation Agent associe les renseignements de Snyk à une boucle dans laquelle il compile, teste et corrige le projet avant de terminer. Notre configuration ne permet pas d’isoler le composant responsable de la différence, mais elle montre à quel point le système qui entoure un modèle peut influer sur le résultat, ce qui concorde avec DepBench, où la seule modification de l’environnement de test a fait varier les résultats de jusqu’à 16,3 points.
Constat clé :
Même modèle, mêmes résultats Snyk : le Remediation Agent d’Evo obtient toujours un score supérieur de 12,7 points.
Résultat 6 : les mises à niveau majeures et les dépendances transitives restent les tâches les plus difficiles
Tous les agents peinent encore avec les migrations majeures de frameworks : 23 mises à niveau, principalement des migrations de Spring, Spring Boot et Dropwizard, ont mis en échec les trois agents.
Pour les mises à niveau majeures vs non majeures, les taux de réussite ont respectivement chuté de 96 % à 81 % pour Evo Remediation Agent, de 88 % à 61 % pour Claude Code + analyse Snyk et de 70 % à 42 % pour Claude Code sans assistance. Les mises à niveau majeures sont aussi celles qui nécessitent des modifications du code : environ la moitié des réussites d’Evo Remediation Agent sur les mises à niveau de versions majeures ont modifié le code source de l’application, contre 5 % pour ses réussites sur les autres mises à niveau.
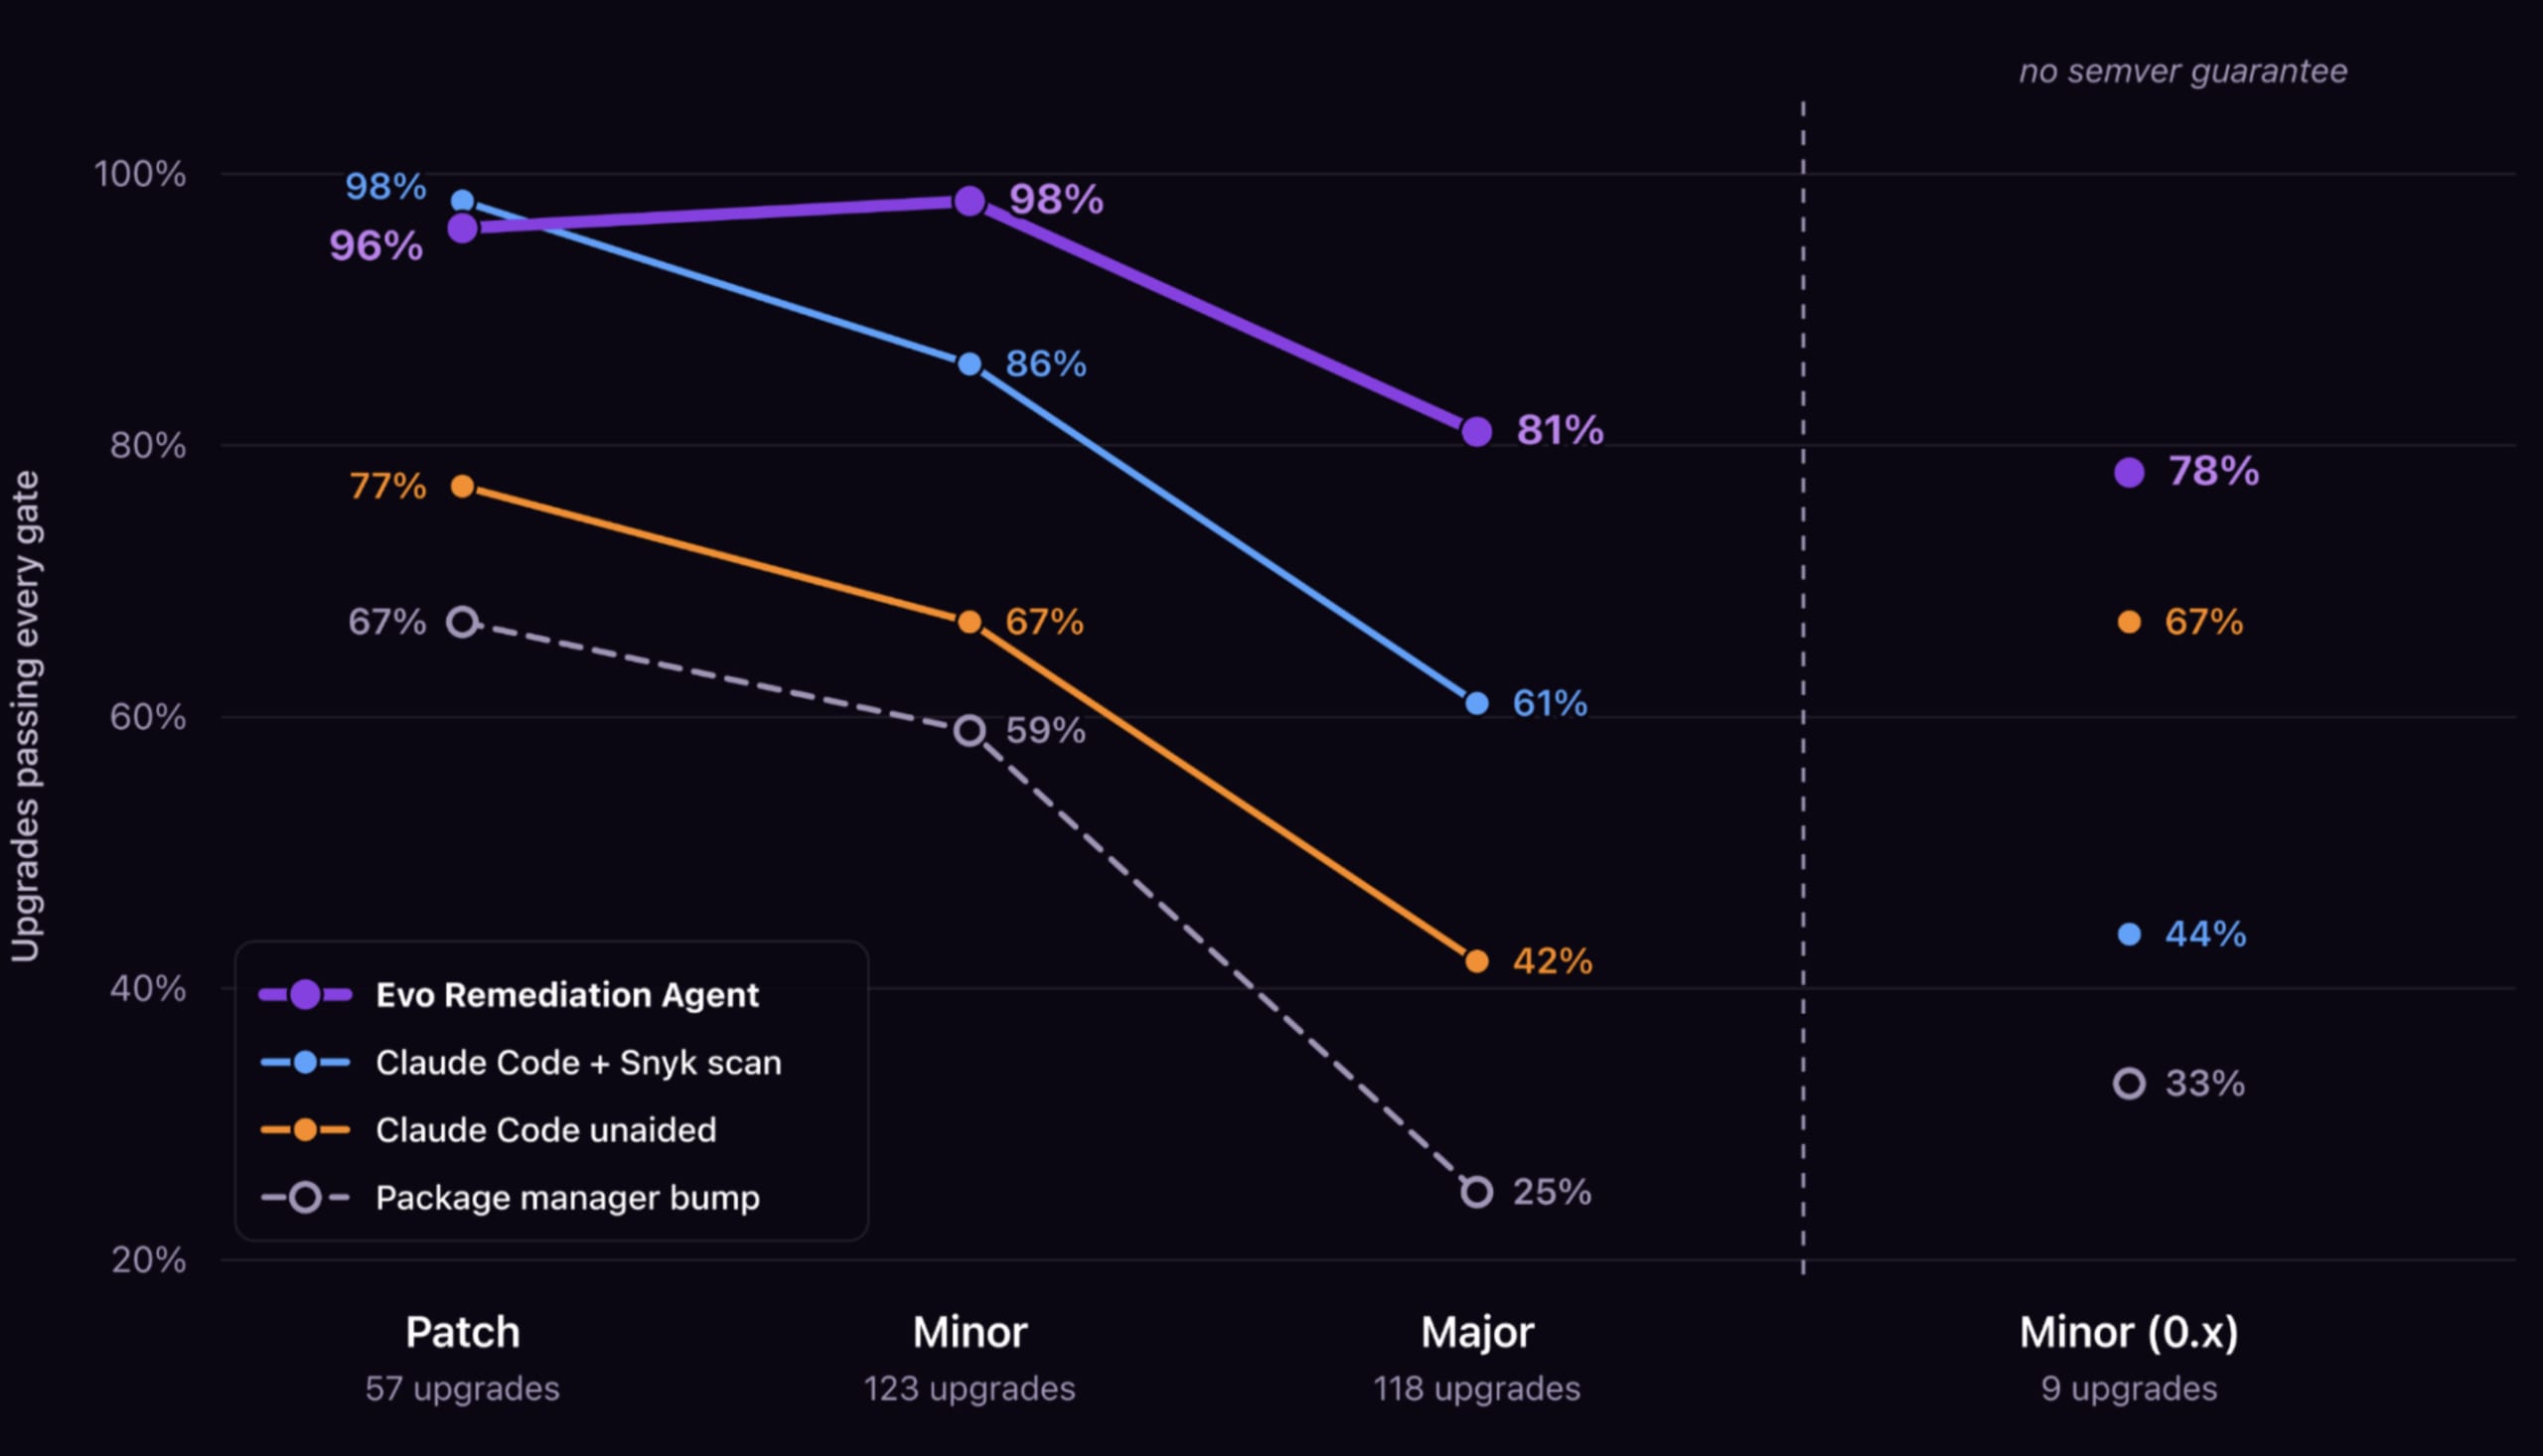
Mises à niveau ayant franchi toutes les étapes de validation, selon l’ampleur du saut de version
Les vulnérabilités transitives, pour lesquelles le package vulnérable n’est pas déclaré dans le manifeste, représentent 70 % des occurrences corrigibles et sont plus difficiles à résoudre pour tous les environnements de test évalués. En ne comptant que les corrections issues de tentatives ayant franchi toutes les étapes de validation, Evo Remediation Agent a corrigé 73 % des occurrences transitives, Claude Code + analyse Snyk 59 % et Claude Code sans assistance 28 %, contre respectivement 91 %, 71 % et 62 % des occurrences directes.
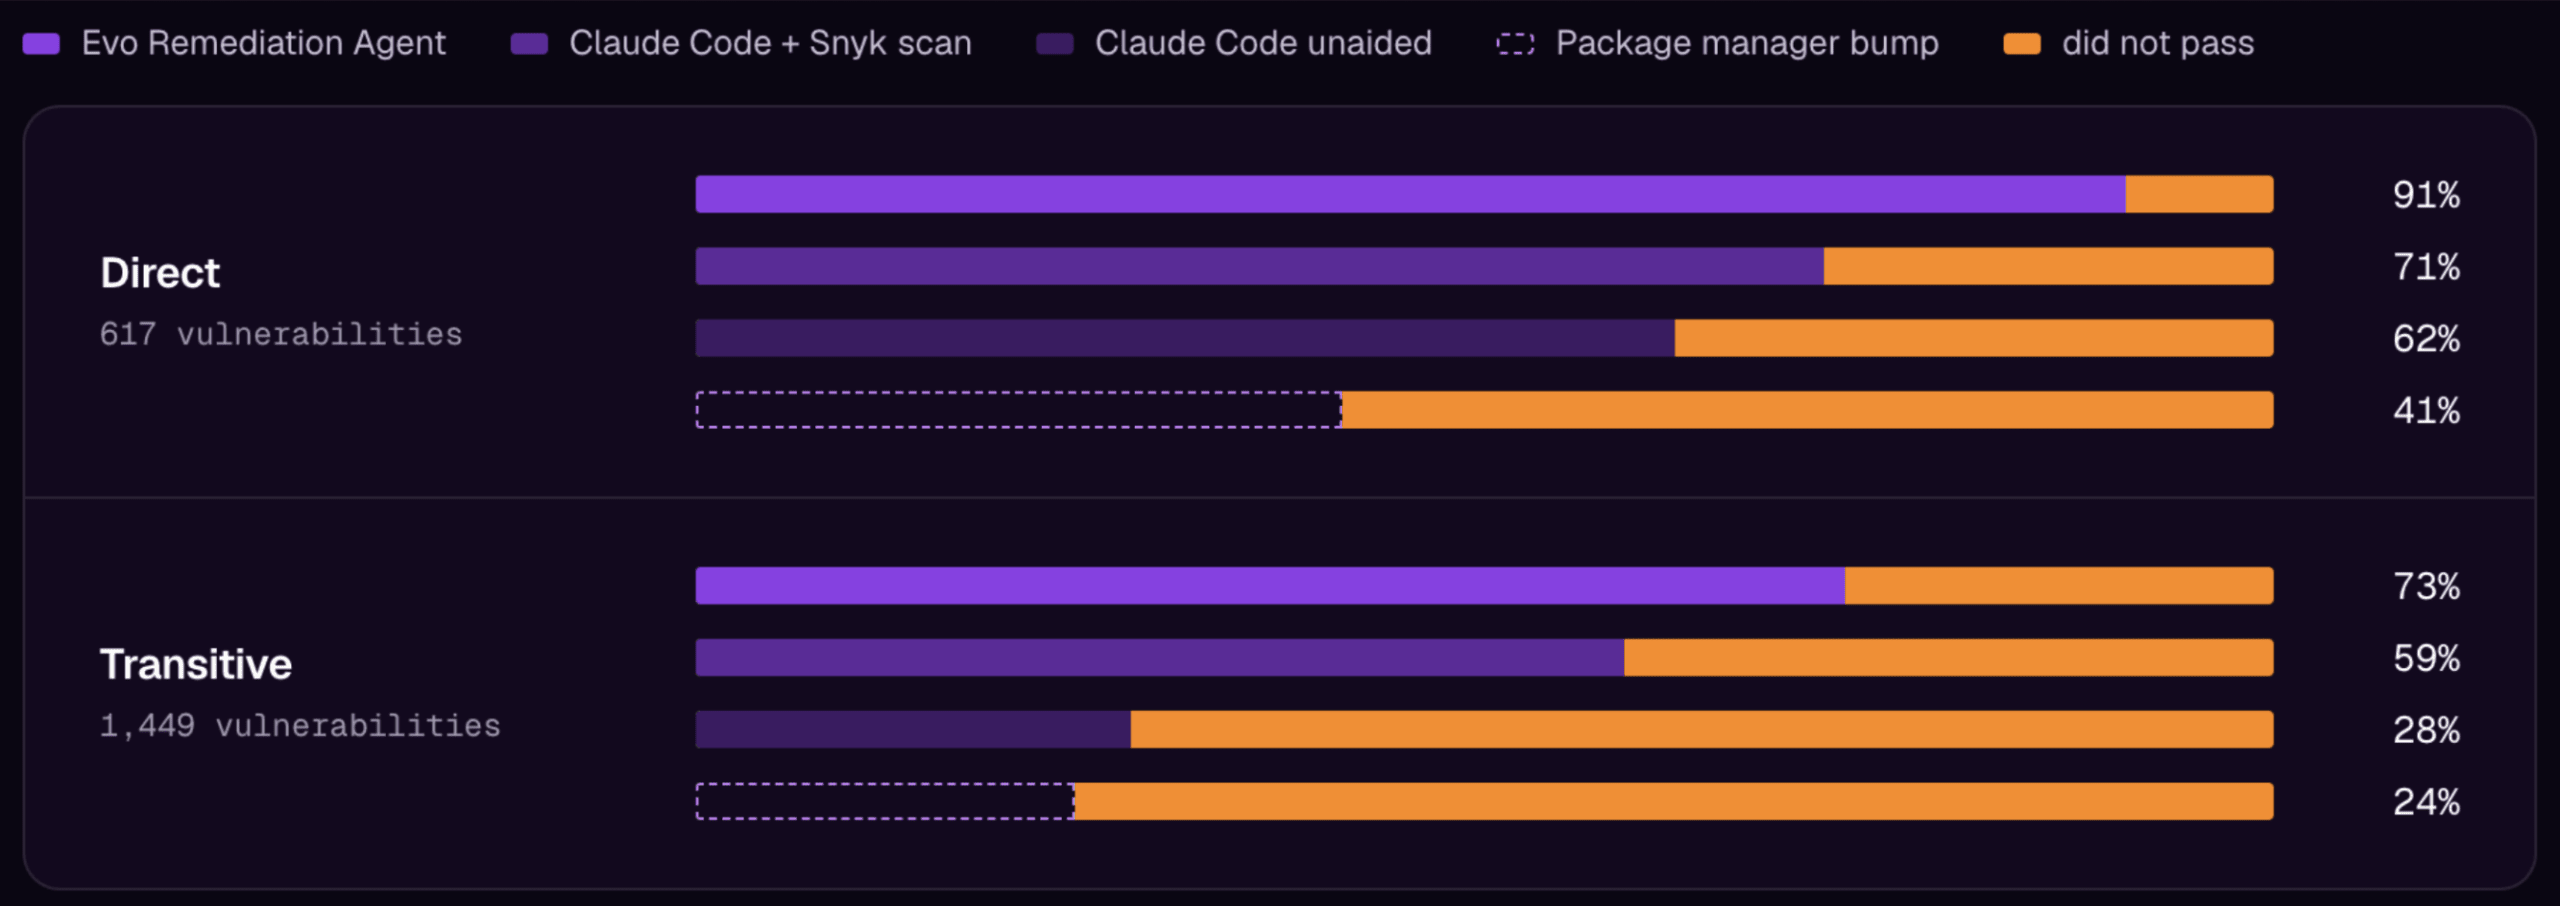
Taux de réussite par type de dépendance (directe vs transitive)
À retenir :
Evo Remediation Agent est le plus performant pour les mises à niveau les plus complexes, les versions majeures et les dépendances transitives, mais les migrations majeures de frameworks restent hors de portée de tous les agents.
Comment VulnBump complète-t-il VulnBench ?
VulnBench évalue la manière dont les agents de programmation IA détectent les vulnérabilités dans le code que vous écrivez : leur capacité à détecter les mêmes problèmes de façon cohérente lors d’exécutions répétées, et la correspondance de leurs résultats avec une référence SAST déterministe. VulnBump évalue leur capacité à corriger les vulnérabilités dans le code dont vous dépendez : mettre à niveau des dépendances open source vulnérables sans casser la build ni les tests.
En examinant les deux études ensemble, on aboutit à la même conclusion : les modèles apportent un raisonnement dont les outils déterministes sont tout simplement dépourvus. Utilisés seuls, ils produisent des résultats différents d’une exécution à l’autre et s’arrêtent souvent avant d’avoir corrigé le problème. À l’échelle de la plateforme, la leçon commune se résume ainsi : le générateur ne peut pas être le validateur.
Qu’est-ce que cela signifie pour les équipes qui confient des tâches de sécurité à des agents ?
Évaluez une correction à partir de preuves que l’agent n’a pas produites : le compte rendu de sa propre correction est une affirmation, tandis qu’une nouvelle analyse, une compilation et l’exécution des tests constituent des preuves. Si un agent traite votre backlog, soumettez-le aux mêmes vérifications.
Évaluez ensemble la vulnérabilité et le build : Pris séparément, aucun de ces critères ne révèle tous les échecs. Vérifier uniquement les régressions ne permet pas de détecter les correctifs qui n’ont jamais été appliqués, tandis que vérifier uniquement les vulnérabilités ne permet pas de repérer le correctif qui a cassé le projet.
Fournissez les données de sécurité à l’agent : Le scan de Snyk et la mise à niveau recommandée ont apporté 17,9 points à un agent généraliste, avec le même modèle.
Evo Remediation Agent est le moteur de remédiation agentique de Snyk, disponible via la Snyk CLI et sous forme de service cloud. Il fait partie des agents d’Evo Agentic AppSec, lancé aujourd’hui.
Testez votre agent avec VulnBump
Le framework VulnBump et ses 43 cas d’évaluation sont open source sur github.com/snyk-labs/snyk-vulnbump.
La méthodologie complète, l’analyse des échecs et les limites sont détaillées dans l’article de recherche. Si vous développez votre propre agent de remédiation, testez-le avec VulnBump et dites-nous ce que vous en pensez.
VulnBump a été conçu par Gabija Pasiunaite, Ryan McMorrow, Brian Clark, Liran Tal et Luke Tu.
RECHERCHE