Revue de code sécurisée : 8 bonnes pratiques pour les revues de code

20 avril 2020
0 minutes de lecture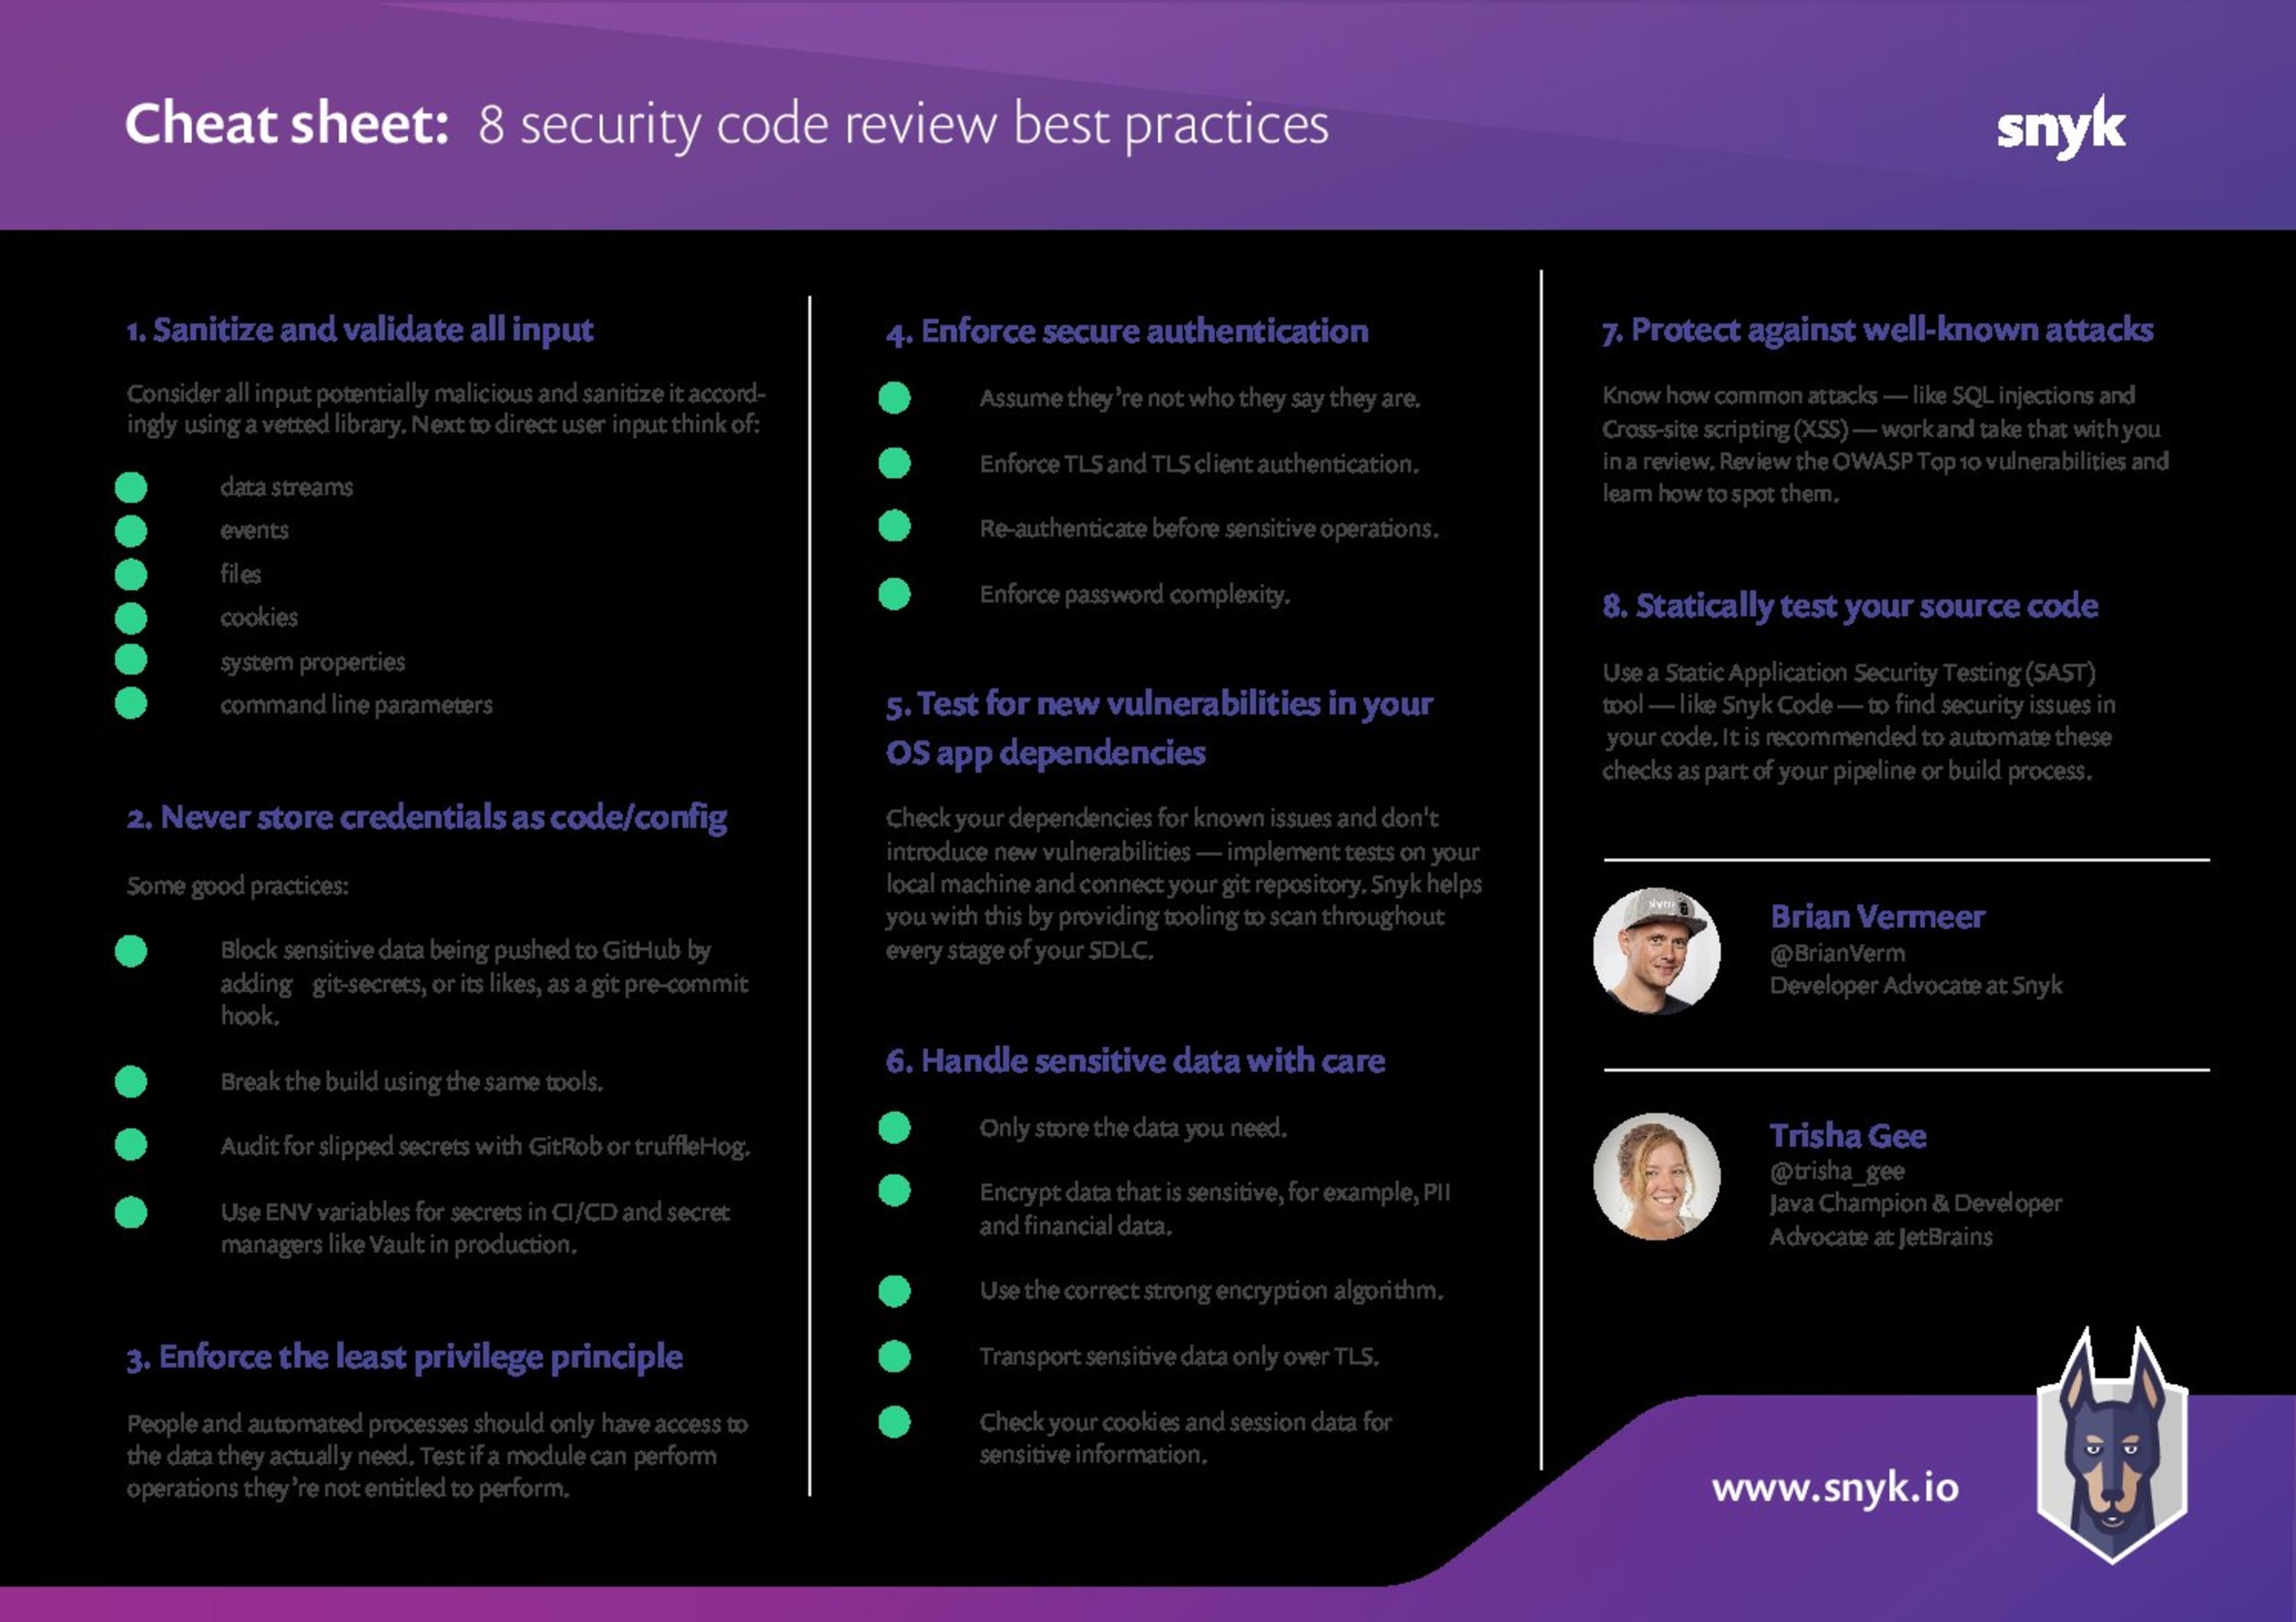
Téléchargez la fiche pratique !
« Lors d’une revue de code, il est toujours judicieux de rechercher les problèmes de sécurité dans le code. Vous ne savez pas quoi vérifier ? Voici une checklist pratique pour vous guider lors de vos prochaines revues de code !Les revues de code sont difficiles à mener correctement, surtout quand on ne sait pas exactement quelles erreurs rechercher ! L’approche DevSecOps déplace les tests de sécurité vers la gauche afin de repérer et de corriger les vulnérabilités plus tôt, lors des étapes de conception, de développement ou de CI/CD du workflow. Lors d’une revue de code, il est toujours judicieux de rechercher les problèmes de sécurité dans le code. Vous ne savez pas quoi vérifier ? Voici une checklist pratique pour vous guider lors de vos prochaines revues de code !»
Lorsque vous examinez du code, gardez à l’esprit que tous les codes ne se valent pas ! Pensez aussi à ce qui se trouve derrière le code que vous examinez, ainsi qu’aux données et aux ressources que vous cherchez à protéger. Ces connaissances du contexte sont difficiles à intégrer dans une checklist. Toutefois, en appliquant les conseils de cette fiche pratique et en vous appuyant sur votre expertise du domaine, vous pourrez déterminer où concentrer vos efforts et où vous attendre à des risques plus élevés et à différents types d’attaques. Pour repérer les zones les plus à risque, vous pouvez notamment créer des arbres d’attaque, qui vous aideront à savoir où concentrer vos efforts en priorité.
Commençons par notre liste de 8 conseils de sécurité à vérifier lors de vos prochaines demandes de fusion !
1. Nettoyez et validez toutes les entrées
Les applications web modernes doivent interagir avec toutes sortes de données provenant de tiers. Les entrées directes d’un utilisateur final dans le navigateur, par exemple, sont un cas évident. En tant que développeurs, nous savons tous qu’un utilisateur peut saisir des données inattendues dès qu’il en a la possibilité. Il est donc essentiel de valider et de nettoyer les entrées directes des utilisateurs afin d’éviter que les applications soient vulnérables aux injections de contenu. Cependant, les entrées directes des utilisateurs sont loin d’être les seules à vérifier. En principe, toute entrée provenant de l’extérieur des frontières de votre système doit être considérée comme potentiellement dangereuse et traitée comme telle. Pensez notamment aux éléments suivants :
flux de données
fichiers
événements — dans un système événementiel, par exemple, qui fonctionne en étroite collaboration avec des plateformes comme les fonctions en tant que service
réponses de données provenant d’autres systèmes
cookies
De plus, une entrée qui semble à première vue sous votre contrôle peut être dangereuse. Imaginez qu’un utilisateur malveillant parvienne à se connecter directement à votre base de données : il pourrait y insérer, par exemple, du code malveillant qui serait exécuté dans votre système. Le même principe s’applique aux éléments suivants :
paramètres de ligne de commande
variables d’environnement
propriétés système
stockage de données
Toutes les entrées, même celles qui semblent être sous votre contrôle, doivent être validées et nettoyées. Vérifiez qu’elles sont cohérentes. L’utilisation du système de types d’un langage à typage sûr peut grandement vous aider. Vérifiez également le format, la plage de valeurs, la taille, le type et le nom du fichier, sans rien tenir pour acquis. Les entrées des utilisateurs doivent être nettoyées, de préférence à l’aide d’une bibliothèque éprouvée, avant d’être stockées ou utilisées.
2. Ne stockez jamais de secrets dans le code ou la configuration
Il est si facile de stocker des identifiants, des jetons ou d’autres secrets sous forme de variables ou de constantes, parce qu’après tout, on ne fait que tester si ça fonctionne. Mais ce code peut tout aussi facilement se retrouver dans votre dépôt parce que vous avez oublié de le supprimer. Veillez à ce qu’il n’y ait aucune donnée sensible dans le code que vous examinez. Si vous utilisez un dépôt de code basé sur Git, il existe d’excellents outils comme git-secrets, capables d’analyser statiquement vos commits via un hook Git pre-commit pour vérifier que vous n’essayez pas d’envoyer des mots de passe ou des informations sensibles dans votre dépôt. Les commits sont rejetés si l’outil détecte l’un des motifs d’expression régulière configurés, qui indiquent que des informations sensibles ont été stockées de manière inappropriée. Cela peut ralentir légèrement les push, mais le jeu en vaut largement la chandelle.
Établir des règles à l’échelle de l’équipe pour empêcher le stockage d’identifiants dans le code est un excellent moyen de surveiller les mauvaises pratiques dans le workflow de développement existant. Utilisez des outils comme Vault pour gérer vos secrets en production. Enfin, envisagez d’utiliser une chaîne d’outils de gestion des identités et des utilisateurs, comme Keycloak (actuellement maintenu par plusieurs développeurs chez Red Hat), ou d’autres solutions.
Il existe de nombreuses façons d’éviter d’ajouter des identifiants à votre dépôt dès le départ ; mieux vaut en mettre en œuvre autant que possible. Toutefois, des informations sensibles peuvent toujours s’y glisser. Pensez également à auditer régulièrement vos dépôts à l’aide d’outils comme GitRob ou truffleHog, qui analysent votre base de code pour y rechercher des informations sensibles par correspondance de motifs.
3. Recherchez les nouvelles vulnérabilités de sécurité introduites par les dépendances open source tierces
Le développement d’applications modernes dépend fortement des bibliothèques tierces. Les gestionnaires de paquets comme npm, Maven, Gradle, PyPI ou leurs équivalents nous donnent facilement accès à des bibliothèques et à des frameworks publics. En tant que développeurs, nous voulons nous concentrer sur la logique métier spécifique, plutôt que de créer des fonctionnalités standard. Il est donc évident de confier les tâches les plus lourdes aux frameworks et aux bibliothèques.
Il est fort probable que vous ne sachiez pas combien de dépendances directes votre application utilise. Dans un projet moyen, votre propre code peut ne représenter que 1 % de l’ensemble ; le reste provient de bibliothèques et de frameworks importés. Une grande partie du code mis en production ne nous appartient pas, mais nous en dépendons fortement. Il est également très probable que vous ignoriez le nombre de dépendances transitives utilisées par votre application. Les frameworks les plus importants dépendent aujourd’hui d’autres bibliothèques, elles-mêmes dépendantes d’autres bibliothèques. L’ajout d’une seule bibliothèque ou d’un seul framework peut entraîner l’ajout d’au moins une douzaine d’autres bibliothèques ou frameworks, dont vous n’avez pas toujours connaissance. Les dépendances constituent ainsi la majeure partie de votre application. Les attaquants ciblent de plus en plus les dépendances open source, car leur réutilisation leur permet de toucher de nombreuses victimes. Il est donc important de vérifier l’absence de vulnérabilités connues dans l’ensemble de l’arborescence des dépendances de votre application.
Prenons Snyk comme exemple. Snyk analyse statiquement votre projet pour détecter les dépendances vulnérables que vous utilisez et vous aider à les corriger. Vous pouvez tester vos dépôts dans l’interface Snyk pour détecter les problèmes, mais aussi empêcher l’ajout de nouvelles bibliothèques vulnérables en testant les demandes de fusion et en faisant échouer le test si une nouvelle vulnérabilité a été introduite. Des demandes de fusion contenant des correctifs automatisés sont également possibles.
Selon votre façon de travailler, vous pouvez connecter votre dépôt à l’interface Snyk ou analyser le projet sur votre machine locale avec la CLI (consultez la fiche pratique sur la CLI), une intégration à votre système de build ou un plugin dans votre IDE. De la machine locale des développeurs jusqu’à votre système en production, en passant par toutes les étapes intermédiaires, analysez automatiquement vos dépendances afin d’obtenir rapidement des retours.
4. Imposez une authentification sécurisée
L’authentification vérifie qu’un utilisateur, un service ou une entité, interne ou externe, est bien celui ou celle qu’il prétend être. Cela peut être aussi simple qu’un utilisateur qui vous fournit ses identifiants, ou un serveur qui vous présente son certificat TLS afin de prouver qu’il est bien le serveur annoncé. L’authentification ne vous indique pas ce que l’utilisateur ou le service est autorisé à faire ; elle confirme simplement son identité. Voici quelques bonnes pratiques d’authentification à retenir :
Partez du principe qu’ils ne sont pas ceux qu’ils prétendent être.
Vous devez partir du principe qu’ils ne sont pas ceux qu’ils prétendent être tant qu’ils n’ont pas fourni les identifiants qui le prouvent. Supposer qu’un utilisateur ou un service ne doit pas accéder à vos données est, bien sûr, la solution la plus sûre. Veillez à ce que votre code reflète ce principe.
Imposez des mots de passe complexes
Pour les utilisateurs, envisagez d’être plus souple concernant les noms d’utilisateur, en particulier lorsqu’il s’agit d’adresses e-mail. Par exemple, il est peu utile de distinguer Patch@snyk.io de patch@snyk.io, alors qu’il est important d’imposer des mots de passe complexes (au moins 1 majuscule, 1 minuscule (a-z), 1 chiffre (0-9) et 1 caractère spécial) et suffisamment longs (NIST SP800-132). Je comprends, il est difficile de retenir tous ces mots de passe aléatoires — ou pas — longs et compliqués. Mais enfin ! Nous sommes en 2020 et les gestionnaires de mots de passe sont là pour vous aider !
Demandez une nouvelle authentification avant les opérations sensibles
Demander aux utilisateurs de saisir leurs identifiants avant un transfert d’argent ou une action sensible permet de limiter les risques de falsification de requête intersite (CSRF) et de détournement de session. Un attaquant pourrait effectuer ces opérations sensibles sans que l’utilisateur ait jamais fourni ses identifiants. Cette mesure de sécurité, même si elle est contraignante pour vos utilisateurs, peut les protéger à long terme.
Authentification client TLS
L’authentification client TLS, également appelée authentification TLS mutuelle, exige que le navigateur et le serveur s’authentifient tous les deux en envoyant leurs certificats TLS lors de la négociation TLS. Pour cela, un utilisateur ou un service obtient un certificat client auprès du serveur, puis le présente lors des échanges suivants. Si l’utilisateur utilise un navigateur, il peut être nécessaire d’y installer le certificat.
5. Appliquez le principe du moindre privilège
L’autorisation complète l’authentification. Ces notions se ressemblent, mais sont très différentes. Comme nous l’avons vu au point 4, l’authentification prouve qu’un utilisateur ou un service est bien celui qu’il prétend être, tandis que l’autorisation vérifie en plus que cette personne ou ce service est habilité à effectuer la tâche ou l’action demandée. Nous savons qu’il faut vérifier ce point et nous assurer que les utilisateurs, services ou processus disposent d’un rôle qui les autorise à effectuer l’action en question. Pourtant, du point de vue du code, il est souvent beaucoup trop facile d’accorder davantage d’accès que nécessaire.
Le principe du moindre privilège stipule que chaque module (par exemple, un processus, un utilisateur ou un programme, selon le contexte) ne doit accéder qu’aux informations et aux ressources nécessaires à son objectif légitime. En somme, accordez aux personnes et aux processus uniquement les privilèges et autorisations indispensables pour atteindre leur objectif.
Pour vérifier ce principe, rédigez des tests unitaires et d’intégration automatiques spécifiques qui couvrent non seulement les scénarios fonctionnels, mais surtout les cas liés à la sécurité qui échouent. Ces tests doivent réussir à authentifier l’utilisateur, puis tenter d’effectuer des opérations auxquelles il n’a pas droit. Ajoutez toujours ces tests lorsque vous modifiez les rôles sous lesquels votre application s’exécute ou introduisez de nouvelles ressources qui exigent un rôle particulier pour être utilisées.
6. Traitez les données sensibles avec précaution
L’exposition de données sensibles, comme des informations personnelles ou les numéros de carte bancaire de vos clients, peut être préjudiciable. Mais des cas plus subtils peuvent l’être tout autant. Par exemple, exposer des identifiants uniques dans votre système est dangereux si ces identifiants peuvent être utilisés dans un autre appel pour récupérer des données supplémentaires.
Tout d’abord, examinez attentivement la conception de votre application et déterminez si vous avez réellement besoin de ces données. Veillez également à ne pas exposer de données sensibles, par exemple dans les journaux, la saisie semi-automatique ou lors de la transmission de données.
Stockage des données sensibles
Si vous devez conserver des données sensibles, comme des informations permettant d’identifier une personne (PII) ou des données financières, veillez à utiliser un chiffrement adapté. Vous souhaitez sans doute, et devez probablement, respecter le RGPD, mais surtout, vous ne voulez pas que les données de vos clients soient compromises. Utilisez un algorithme de chiffrement robuste à double sens si vous devez récupérer les données dans leur forme d’origine, ou un algorithme de hachage cryptographique robuste si vous devez stocker des mots de passe. Ne tombez pas dans le piège qui consiste à créer votre propre chiffrement : renseignez-vous sur le type de chiffrement nécessaire et utilisez une bibliothèque éprouvée pour le mettre en œuvre. Par exemple, utilisez BCrypt pour le hachage des mots de passe, et les algorithmes de chiffrement Triple DES, RSA et AES pour chiffrer les données que vous devez pouvoir récupérer. Surtout, vérifiez régulièrement que les algorithmes que vous utilisez sont toujours suffisamment sûrs. Ce qui est parfaitement sûr aujourd’hui peut être compromis demain.
N’oubliez pas non plus que des données sensibles peuvent se trouver en mémoire. Si vous modifiez un mot de passe dans votre système, évitez de le stocker temporairement dans un type de données immuable. Par exemple, si vous utilisez une String en Java pour stocker votre mot de passe en mémoire, la valeur d’origine y restera jusqu’à ce que le ramasse-miettes la supprime, car String est immuable. Dans ce cas, un tableau d’octets serait un meilleur choix.
Transfert de données sensibles
Si vous devez transférer des données sensibles, vérifiez que la connexion est sécurisée. Ces données doivent être transférées uniquement sous forme chiffrée et via TLS. Vous devez également vous assurer que la version de TLS est à jour. Il va sans dire que transmettre les coordonnées de carte bancaire d’une personne en paramètre de requête ou en texte brut dans le corps d’une requête HTTP n’est absolument pas sûr.
Données de session
Enfin, et ce n’est pas le moins important, considérez également les données de session comme des données sensibles. Il est conseillé de ne pas stocker de données sensibles dans des cookies, mais plutôt d’utiliser un identifiant de session et de stocker les données dans une session gérée côté serveur. Veillez également à ce que les cookies soient chiffrés et suffisamment longs (par exemple, 128 bits). Vérifiez que les attributs tels que HttpOnly, Secure, et SameSite sont correctement définis sur le cookie et que celui-ci expire dans un délai raisonnable. Notez que si un utilisateur se déconnecte côté client, la session doit être invalidée afin qu’elle ne puisse pas être réutilisée ailleurs.
7. Se protéger contre les attaques bien connues
On peut partir du principe que les attaquants continueront de pirater nos applications en recourant à des vecteurs d’attaque prévisibles, bien connus et identifiés. Le manque général de connaissances sur les vulnérabilités courantes et leur exploitation conduit souvent à répéter les mêmes erreurs de sécurité dans le code. Consultez les vulnérabilités de l’OWASP Top 10 et comprenez le fonctionnement de ces exploits courants. Voici quelques conseils à garder à l’esprit pour éviter les types de vulnérabilités les plus répandus.
XSS
Le principe d’une attaque par cross-site scripting (XSS) est qu’un utilisateur injecte des données malveillantes dans votre application, lesquelles se retrouvent dans un contexte — tel qu’un document HTML — où elles peuvent être exécutées pour divulguer des informations sensibles ou mener d’autres activités malveillantes. Si vous prévoyez d’autoriser les utilisateurs à envoyer des données sur votre site et que celles-ci s’affichent sur vos pages, vous devez apprendre à prévenir les attaques XSS. Il existe plusieurs moyens de réduire le risque d’attaque XSS, par exemple en encodant les caractères dangereux en HTML. Il s’agit notamment de &, <, >, “ et ‘. Interdire ou assainir ces caractères empêchera un attaquant de sortir de la balise HTML et d’exécuter du code malveillant. Pour compliquer davantage les choses, nous pouvons encoder en HTML tous les caractères HTML qui nous sont transmis, afin qu’ils ne soient pas représentés sous une forme permettant de sortir d’une balise HTML, comme suit :
Entité HTML | Encodage HTML |
|---|---|
& | & |
< | < |
> | > |
“ | " |
‘ | ' |
Nous pouvons obtenir le même résultat avec les attributs de balise, les gestionnaires d’événements ou même les propriétés de style. Il est courant d’utiliser des bibliothèques d’assainissement pour définir une liste d’autorisation des caractères à accepter. Le recours à des bibliothèques d’assainissement existantes nous évite également de devoir être des experts en sécurité pour prendre en compte tous les cas de figure. C’est particulièrement utile pour les développeurs moins expérimentés.
Injection SQL et NoSQL
Si l’injection SQL est particulièrement intéressante pour un attaquant, c’est parce qu’elle lui donne un accès direct aux données qu’il cherche à obtenir. Bien souvent, un piratage sert simplement à découvrir le système que l’attaquant tente de compromettre. Il doit alors généralement redoubler d’efforts pour découvrir où se trouvent les données et comment y accéder. L’injection SQL, en revanche, permet à un attaquant d’accéder directement aux informations sensibles stockées dans une base de données, dès lors que l’attaque réussit. Cela ne concerne pas uniquement les bases de données SQL : de nombreuses bases NoSQL peuvent être compromises de manière similaire.
Les attaques XSS et les injections SQL sont très courantes. Vous devez savoir comment elles fonctionnent et comment les repérer dans votre code. L’absence d’assainissement des entrées, où que ce soit dans le système, est un signal d’alerte majeur concernant les attaques XSS. Pour les injections SQL, vérifiez si les paramètres des requêtes sont correctement utilisés. Vous devez distinguer la requête de ses paramètres. Lier les paramètres à un type précis avant de les intégrer à la requête (et les assainir correctement) permet de prévenir ces attaques.
Votre application peut être exposée à de nombreux autres types de vulnérabilités, à des degrés divers. Prenez le temps de découvrir lesquelles présentent le plus de risques pour votre application, du code produit directement par vos équipes aux types de bibliothèques dont dépend votre application.
8. Tester automatiquement le code source de manière statique
L’analyse statique du code est un outil très puissant pour les développeurs. Les outils de test de sécurité des applications statique (SAST) constituent une catégorie d’outils axés sur la sécurité. En analysant statiquement le code écrit par votre équipe et vous-même, un outil SAST signale les éventuels bogues liés à la sécurité qui se seraient glissés dans votre code source. Un outil SAST comme Snyk Code peut détecter des problèmes tels que les injections SQL et les vulnérabilités dans le code.
Pour la sécurité, nous recommandons un outil SAST plutôt qu’un linter. Les linters sont utiles pour l’analyse statique du code (bogues, erreurs, etc.), mais ils génèrent de nombreux faux positifs. Comme ils reposent tous sur des règles et ne tiennent pas compte de l’ensemble du contexte de votre code, un linter peut signaler à tort un bogue ou un problème de sécurité. Cela dit, en affinant le jeu de règles, un linter peut prévenir des erreurs graves. L’idéal est d’automatiser ces processus autant que possible, par exemple dans votre processus de build ou à chaque nouvelle pull request envoyée à votre dépôt. Snyk Code s’occupe de tout cela pour vous en intégrant des fonctionnalités SAST directement à vos workflows.
Si vous ne disposez pas d’un outil SAST, vous pouvez l’utiliser lors de vos revues de code manuelles ou, mieux encore, l’intégrer à votre processus pour que les équipes puissent détecter plus tôt les problèmes évidents. Vous pouvez également essayer l’outil gratuit de vérification du code de Snyk pour évaluer rapidement la sécurité de votre code.
Lancez-vous dans les compétitions Capture The Flag
Apprenez à résoudre des défis Capture The Flag en regardant à la demande notre atelier virtuel d’initiation.


