Vulnérabilités liées aux URL observées sur le terrain : exploration des incohérences entre analyseurs

Snyk Security Research Team
Claroty Team82
10 janvier 2022
0 minutes de lectureLes URL ont profondément transformé notre façon d’interagir avec les ordinateurs. Conçue en 1992 et définie en 1994, l’URL (Uniform Resource Locator) reste un élément essentiel d’Internet, permettant aux internautes de parcourir le Web grâce à des adresses descriptives et compréhensibles. Mais la lisibilité humaine implique de décomposer ces adresses en éléments exploitables par les machines, ce que font les analyseurs d’URL.
Compte tenu de l’omniprésence des URL depuis des décennies, on pourrait penser que les analyseurs d’URL utilisés aujourd’hui s’accordent sur la manière d’analyser des URL similaires, voire identiques. Ce serait l’idéal, mais c’est loin d’être le cas. Ce manque de consensus a favorisé une catégorie de vulnérabilités appelée confusion d’URL, que nous allons explorer dans cet article.
Remarque : Le processus de développement des protocoles Internet (HTTP, HTML, URL, etc.) s’appuie sur des documents appelés Requests for Comments, ou RFC. Nous y ferons souvent référence dans cet article.
Dans le cadre de nos recherches conjointes, nous avons examiné de nombreuses bibliothèques d’analyse d’URL dans différents langages de programmation et relevé des incohérences dans la façon dont chacune décompose les URL fournies en leurs éléments de base. Nous avons classé ces incohérences en quatre catégories et recherché des flux de code problématiques dans des applications web et des bibliothèques open source. Ces travaux ont mis au jour de nombreuses vulnérabilités, dont la plupart avaient l’une des causes profondes suivantes :
Plusieurs analyseurs d’URL sont utilisés
Plusieurs RFC relatives aux URL ont été publiées au fil du temps, et différents analyseurs ont implémenté différentes RFC
Dans cet article, nous revenons sur l’histoire des URL, explorons les sources possibles de confusion entre analyseurs d’URL, présentons un POC d’exploitation, puis formulons des recommandations pour vous protéger contre les attaques liées à la confusion des URL. Utilisez la table des matières ci-dessous pour accéder directement à une section :
Les recherches menées conjointement par les équipes de recherche en sécurité de Claroty et de Snyk s’inspirent des travaux antérieurs d’Orange Tsai, intitulés « A New Era of SSRF », ainsi que d’une comparaison entre WHATWG et RFC 3986 réalisée par Daniel Stenberg, créateur de cURL. Nous tenons à les remercier pour leurs recherches novatrices.
Que sont les URL et comment en sommes-nous arrivés là ?
Quand on pense à une URL, on pense à quelque chose comme https://snyk.io. À la base, il s’agit de l’endroit où aller (my-site.com) et du moyen d’y accéder (via HTTPS). À ces éléments s’en ajoutent d’autres, comme les chemins (https://my-site.com/about), les symboles dièse suivis d’une chaîne (les fragments, par exemple https://my-site.com#contact) ou les points d’interrogation suivis de paramètres (les requêtes, par exemple https://my-site.com?source=li&device=mobile).
En généralisant et en combinant les éléments ci-dessus, on peut décomposer une chaîne d’URL en composants essentiels :
scheme://authority/path?query#fragment
Par exemple, une URL peut prendre la forme suivante : https://example.com:8042/over/there?name=ferret#nose
Dans le cadre de nos recherches, nous avons étudié la manière dont différents analyseurs implémentaient diverses RFC. Si la forme d’URL ci-dessus semble relativement simple, les RFC qui la définissent ont beaucoup évolué depuis 1994. Ces ajouts et refontes ont progressivement donné naissance à l’URL que nous connaissons aujourd’hui.
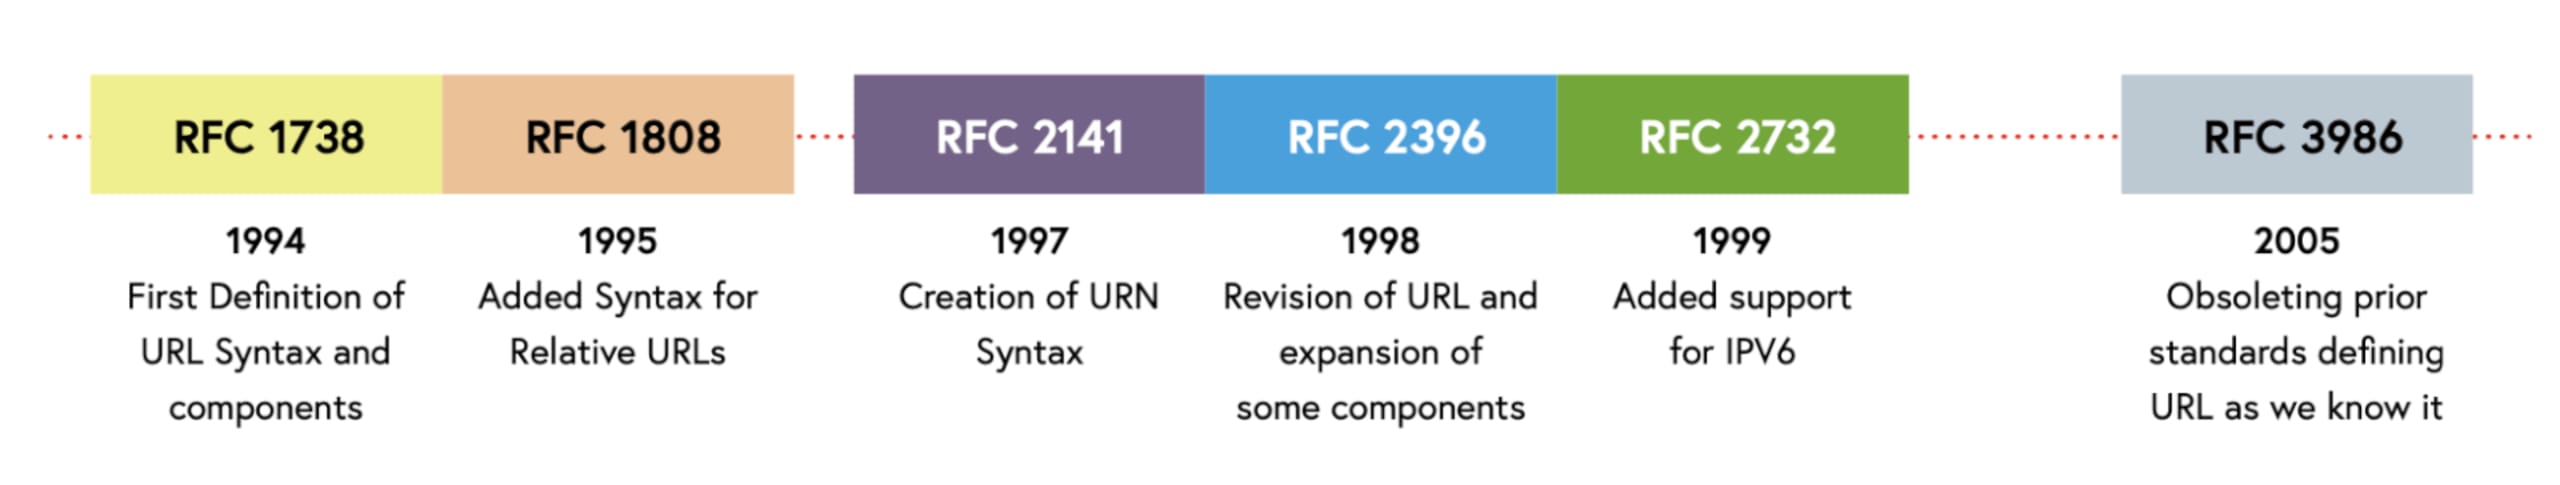
Pour en savoir plus : RFC 1738, RFC 1808, RFC 2141, RFC 2396, RFC 2732, RFC 3986
Pour comprendre où les analyseurs se trompent, nous devons d’abord examiner (rapidement) la signification de chaque composant de l’URL complète et la façon dont il est défini.
Schéma
La section du schéma définit le protocole (HTTP, HTTPS, FTP, Gopher, etc.). Les RFC précisent les caractères autorisés dans ce composant et indiquent que le schéma doit respecter le modèle ALPHA *( ALPHA / DIGIT / "+" / "-" / "." ). Voyons comment cela fonctionne :
Premier caractère :
a–ZCaractère(s) suivant(s) :
a–Z,0–9,+,-,.
Cela signifie que 1http n’est pas un schéma valide (puisqu’il commence par un chiffre), contrairement à h2ttp (le premier caractère doit être une lettre). De plus, contrairement aux autres composants d’une URL, le schéma est le seul élément obligatoire.
Autorité (anciennement Netloc)
Ce composant s’appelait autrefois « Netloc » (network-location), avant d’être renommé Authority. Il se compose de trois sous-composants : userinfo, host et port. Ensemble, ils forment une autorité générique de la manière suivante : authority = [ userinfo "@" ] host [ ":" port ]. Le sous-composant userinfo peut également être réduit à ses éléments principaux : username[:password]. Cela couvre les URL de la forme scheme://user:password@domain:port/. Notez qu’à partir de la RFC-2396, l’utilisation de user:password en texte brut a été déconseillée, puis abandonnée dans la RFC-3986.
Chemin
Ce composant indique les ressources auxquelles le demandeur souhaite accéder sur le serveur. Il peut contenir toute séquence de caractères (à l’exception de /,;,=,?), divisée en segments (délimités par /).
Bien que ce composant semble le plus simple, c’est aussi celui qui a le plus évolué au fil des ans. Les RFC-1738 et RFC-1808 liaient la structure et les règles du chemin au composant du schéma. Ensuite, la RFC-2396 a indiqué que chaque segment de chemin pouvait utiliser le point-virgule (;) pour définir des paramètres. Toutefois, peu après la RFC-2396, la RFC-3986 a rendu obsolète la syntaxe des paramètres utilisant le point-virgule.
Vous êtes perdu ? Les analyseurs aussi !
Requête
Les requêtes sont des paires clé-valeur transmises via l’URL à la ressource demandée. Les paramètres de requête se trouvent après le premier point d’interrogation (?) et se terminent par un signe dièse (#).
Dans un composant de requête, le point-virgule (;), la barre oblique (/), le point d’interrogation (?), les deux-points (:), l’arobase (@), l’esperluette (&), le signe égal (=), le signe plus (+), la virgule (,) et le dollar ($) sont des caractères réservés et sont encodés dans l’URL lorsqu’ils sont utilisés.
Voici un exemple d’encodage de caractères spéciaux dans une URL :
Fragment
Le fragment sert à identifier et à accéder à une seconde ressource au sein de la première ressource récupérée, spécifiée par le composant de chemin. Un fragment est indiqué par la présence d’un dièse (#) et se termine à la fin de l’URI.
... et voilà pour les composants !
URL relatives
Dernier point de cette section : la référence relative dans les URL. Les URL étant hiérarchiques par nature, une URL peut être relative à une autre. Par exemple, si l’URL « de base » est https://example.com/ et que la chaîne d’URL commence par un chemin, comme /foo/bar, l’analyseur les résoudra en https://example.com/foo/bar. Toutefois, l’URL « de base » doit lui être fournie au préalable.
Cela signifie que les analyseurs doivent savoir traiter les références relatives. La RFC-3986 définit trois types de références relatives :
Référence de type network-path : commence par
//, par exemple//example.comRéférence de type absolute-path : commence par
/, par exemple/etc/passwdRéférence de type relative-path : ne commence pas par
/, par exemplefoo/bar
Type de référence | Exemple |
|---|---|
Network-path | //snyk.io |
Absolute-path | /etc/passwd |
Relative-path | app/login.js |
Les deux derniers types nécessitent une URL de base pour être résolus, tandis que la référence de type network-path nécessite uniquement la présence du schéma. Ainsi, si un analyseur utilise HTTPS comme schéma par défaut, //example.com devient https://example.com.
Où les analyseurs d’URL se trompent-ils ?
Après avoir passé en revue les différents éléments d’une chaîne d’URL et les évolutions des RFC au fil des ans, nous avons décidé de cibler les analyseurs d’URL et de rechercher des cas limites susceptibles de produire des résultats d’analyse incorrects ou inattendus.
Au cours de nos recherches, nous avons examiné 15 bibliothèques (écrites dans différents langages de programmation), des outils de récupération d’URL (comme curl et wget) ainsi que des navigateurs.
Nous avons relevé de nombreuses incohérences entre les analyseurs et les avons classées en quatre grandes catégories. Comme nous le verrons ci-dessous, ces incohérences permettent de piéger la plupart des analyseurs et de créer divers comportements imprévisibles, ouvrant la voie à un large éventail de vulnérabilités.
Voici les catégories que nous avons définies :
Sans plus attendre, passons-les en revue !
Confusion de schéma
Presque tous les analyseurs d’URL se trompent lorsque le composant du schéma est absent. La confusion vient du fait que la RFC 3986 indique que le schéma est la seule partie obligatoire de l’URL, contrairement à la RFC 2396 et aux versions antérieures. Concevoir des analyseurs rétrocompatibles tout en tenant compte de ces nuances n’a rien de simple : la confusion est donc inévitable.
Pour illustrer cela, voici le résultat obtenu par quatre bibliothèques Python différentes à partir de l’URL google.com/abc :

Comme illustré ci-dessus, la plupart des analyseurs indiquent que le composant hôte est vide lorsque la chaîne google.com/abc leur est fournie. Urllib3, en revanche, indique que l’hôte est google.com et que le chemin est /abc. À l’inverse, httptools considère que cette URL est invalide. En résumé, presque tous les analyseurs traitent mal cette URL, car elle ne respecte pas les spécifications des RFC.
Cela dit, certains analyseurs basculent sur le schéma par défaut, comme le fait curl dans cet exemple :

Dans ce cas, les attaquants peuvent exploiter la différence entre les analyseurs pour contourner la validation. Si un analyseur d’URL vérifie certains hôtes, mais ne parvient pas à analyser correctement l’URL pour en extraire l’hôte, alors que la bibliothèque sous-jacente analyse correctement l’URL (ou utilise une valeur par défaut), le contournement réussit. Par exemple :

Dans l’exemple ci-dessus, urllib (plus précisément la fonction urlsplit) analyse l’URL sans netloc, ce qui permet de passer le contrôle. Mais urllib3 utilise le protocole http par défaut et récupère la ressource interdite.
Confusion liée aux barres obliques
La méthode de confusion suivante repose sur un nombre non standard de barres obliques dans l’URL. La RFC 3986 indique que le composant d’autorité de l’URL doit suivre deux barres obliques après les deux-points (://) et se poursuivre jusqu’à la fin de la ligne (EOL) ou jusqu’à la lecture d’un délimiteur. Dans ce cas, un délimiteur peut être une barre oblique (qui indique un composant de chemin), un point d’interrogation (composant de requête) ou un dièse (composant de fragment).
Au cours de nos recherches, nous avons observé différents comportements des analyseurs lorsqu’ils traitaient une URL qui ne respectait pas la syntaxe ci-dessus. Voici ce qui s’est passé avec l’URL http:///google.com :

Comme vous pouvez le constater, la plupart des analyseurs ont indiqué que cette URL n’avait pas d’hôte et ont plutôt interprété /google.com comme un chemin dans une URL sans hôte, ce qui est le comportement attendu selon la RFC 3986. Nous avons reproduit ce résultat avec différents nombres de barres obliques après le schéma. Cependant, nous avons également trouvé des analyseurs qui tentaient de « corriger » l’URL en ignorant les barres obliques en trop ou manquantes, dans une certaine mesure. Par exemple, la fonction native Javascript fetch traite ces URL comme si elles étaient correctes :

C’est aussi le cas pour curl :

De telles différences dans les résultats d’analyse élargissent considérablement la surface d’attaque. Comme pour la précédente piste d’attaque (la confusion de schéma), et si nous pouvions contourner les vérifications parce que le premier analyseur interprète l’URL différemment du client de récupération ? Considérons l’exemple suivant :

Là encore, on observe une assertion concernant un domaine bloqué, et là encore, netloc sera vide à cause de l’analyse, ce qui permettra à la vérification de réussir. Plus loin dans le code, curl interprétera l’URL différemment et tentera de récupérer la ressource de manière inattendue. Cela peut entraîner des SSRF et donner accès à d’autres hôtes interdits.
Confusion liée à la barre oblique inverse
La confusion liée à la barre oblique inverse est une variante de la confusion liée à la barre oblique. Elle peut se produire lorsqu’une URL utilise une barre oblique inverse (\) au lieu d’une barre oblique (/), créant ainsi une URL mal formée. Selon la RFC 396, une barre oblique inverse est différente d’une barre oblique et doit être interprétée différemment : http://google.com est donc différent de http:\\google.com. Conformément à la RFC, la plupart des analyseurs d’URL utilisés par programmation traitent effectivement ces deux URL différemment :

Chrome, en revanche, choisit d’interpréter la barre oblique inverse comme une barre oblique :

Il accède à l’URL comme si elle était valide. Pour pousser les choses à l’extrême, ce comportement se produit aussi pour https:/\google.com, et Chrome fournit la ressource de manière (in)attendue.
Confusion liée à l’encodage des URL
La dernière catégorie de confusion est celle liée à l’encodage des URL. Elle se produit lorsqu’une URL contient une sous-chaîne encodée qui ne devrait pas l’être.
De manière générale, l’encodage des URL permet d’intégrer des caractères non imprimables dans les chaînes d’URL. Pour cela, on utilise la valeur hexadécimale du caractère, précédée du symbole % : ainsi, g devient %67 une fois encodé dans une URL. Cette méthode permet aux chaînes d’URL de rester entièrement textuelles et lisibles, quels que soient les caractères qu’elles contiennent. Bien que cette méthode soit destinée aux caractères non imprimables, les caractères imprimables peuvent eux aussi être encodés dans une URL, ce qui peut entraîner une confusion.
La RFC 3986 indique que tous les composants d’une URL, à l’exception du schéma, peuvent être encodés. En pratique, cependant, de nombreux analyseurs n’analysent pas le composant netloc.
Voici les résultats obtenus lorsque nous avons fourni aux analyseurs l’URL http://google.com sous forme encodée :

Si les résultats ci-dessus semblent attendus, urllib et requests, deux bibliothèques Python, ont eu un comportement intéressant lorsqu’elles ont reçu une URL encodée :

Dans les deux cas ci-dessus, une requête a été envoyée de manière inattendue à 127.0.0.1.
Compte tenu de ce qui précède, cette divergence crée une autre surface d’attaque : de simples expressions régulières ne détecteront pas ces chaînes, ce qui peut nous permettre de contourner à nouveau les vérifications.
Preuve de concept de l’exploitation (et CVE attribués)
Maintenant que nous comprenons l’origine de cette confusion, voyons comment exploiter ces problèmes et les vulnérabilités que nous avons découvertes. Nous détaillerons une CVE, mais la liste complète figure ci-dessous.
Clearance (Ruby) : CVE-2021-23435 : vulnérabilité de redirection ouverte
Une vulnérabilité de redirection ouverte se produit lorsqu’une application web accepte une entrée contrôlée par l’utilisateur qui spécifie l’URL vers laquelle celui-ci sera redirigé après une action donnée (comme une connexion). Pour illustrer concrètement l’attaque, voici un schéma qui la représente :
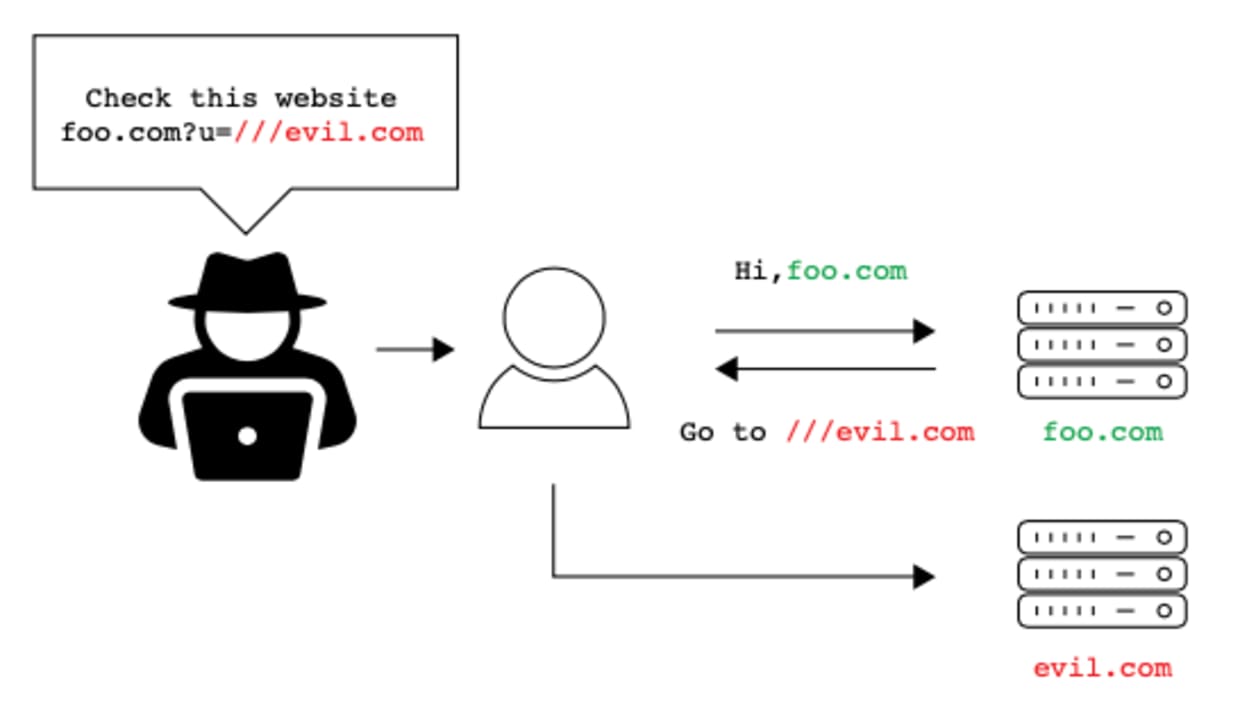
Comme vous pouvez le voir, l’attaquant fournit à la victime une URL à utiliser. Avec la configuration adéquate, celle-ci amènera le serveur à rediriger l’utilisateur vers un site contrôlé par l’attaquant.
Clearance est une gem Ruby destinée à enrichir le mécanisme d’authentification de Rails en y ajoutant une authentification email-and-password. Après une connexion ou une déconnexion, elle redirige l’utilisateur vers une URL récupérée à partir d’une requête précédente de l’utilisateur (c’est-à-dire la ressource demandée avant l’affichage de la page de connexion).
Le code vulnérable se trouve dans la fonction return_to (le rappel après connexion/déconnexion) :
Même si l’on pense aux redirections ouvertes, return_to ne permet pas aux utilisateurs de fournir librement une URL return_to. Cependant, si un utilisateur demande une ressource auth-required sans être connecté, le système appelle store_location et redirige le navigateur vers la page de connexion. Ainsi, si un attaquant parvient à convaincre une victime de cliquer sur un lien comme http://target.com/////evil.com, la vulnérabilité peut être exploitée.
Pourquoi une redirection ouverte se produit-elle ? À cause de plusieurs analyseurs !
Comme nous l’avons vu, store_location enregistre le chemin complet de l’URL (cela tient aussi au fait que Ruby ignore les barres obliques multiples dans les URL). Il stocke donc /////evil.com dans son cache. Lorsque URI.parse est appelé, il supprime deux barres obliques supplémentaires : on obtient alors ///evil.com. Lorsqu’un navigateur (comme Chrome) reçoit cette URL, il l’interprète comme une référence de chemin réseau et redirige le client vers http://evil.com.
Si les navigateurs ont tendance aujourd’hui à « pardonner » ce type d’erreur dans les URL (et à tenter de les corriger), c’est parce qu’au fil des ans, ils ont dû gérer de nombreuses URL imparfaites ou non conformes aux RFC. Pour mieux tolérer les erreurs des clients et des développeurs, ils ont fini par décider d’omettre ou d’ajouter des barres obliques dans les cas d’erreur courants.
Voici un extrait du code source du projet Chromium :
Autres vulnérabilités
Voici d’autres vulnérabilités dues aux différences entre les analyseurs :
Flask-security (Python, CVE-2021-23385)
Flask-security-too (Python, CVE-2021-32618)
Flask-User (Python, CVE-2021-23401)
Flask-unchained (Python, CVE-2021-23393)
Belledonne’s SIP Stack (C, CVE-2021-33056)
Video.js (JavaScript, CVE-2021-23414)
Nagios XI (PHP, CVE-2021-37352)
Clearance (Ruby, CVE-2021-23435)
Recommandations pour éviter la confusion liée aux URL
Comme les problèmes abordés dans cet article résultent de la présence de plusieurs analyseurs et de leurs méthodes respectives, il est important de savoir quels analyseurs sont utilisés dans votre application lors de la construction de ce type de système. La tâche se complique avec les architectures actuelles (microservices et maillages, par exemple) et peut nécessiter du temps pour déterminer quels composants effectuent l’analyse dans votre application et comment une requête y circule.
Une fois la liste des analyseurs établie, les développeurs doivent comprendre en détail les différences entre leurs logiques d’analyse afin de pouvoir travailler efficacement sans compromettre l’application.
De manière générale, nous vous recommandons de :
Utiliser le moins d’analyseurs différents possible. Vous réduirez ainsi la surface de « confusion » et le nombre de problèmes d’analyse susceptibles de se produire.
Centraliser l’analyse dans les systèmes décentralisés. Si votre requête passe de composant en composant dans votre système, il est fort probable que différents analyseurs soient appelés (par exemple, parce que différents services utilisent différents langages). Pour limiter ce risque, vous pouvez analyser l’URL une seule fois, au point d’entrée des requêtes de votre système, puis transmettre la requête analysée. Ainsi, un seul analyseur sera utilisé tout au long du parcours de la requête.
Comprendre les différences entre les analyseurs utilisés par votre logique métier. Comme nous devons parfois analyser des URL dans notre code ou notre logique métier, les développeurs qui travaillent sur la fonctionnalité doivent comprendre les variations entre les analyseurs (comme indiqué ci-dessus).
Lisez le livre blanc sur la confusion des URL
Approfondissez les différents types de confusion des URL en lisant le livre blanc.


