Sécuriser le code avec Snyk Code : ignorer, avec une touche d’originalité
Frank Fischer
30 mars 2021
0 minutes de lectureLors de l’analyse de votre code avec notre outil de sécurisation du code, Snyk Code peut détecter toutes sortes de vulnérabilités. Snyk Code est rapide, précis et riche en informations, mais il peut parfois être nécessaire de masquer certains avertissements. C’est notamment le cas dans le code de test, lorsque vous utilisez délibérément des mots de passe codés en dur pour tester vos routines, ou que vous connaissez un problème, mais décidez de ne pas le corriger. Dans ce cas, Snyk Code, comme les autres produits de la plateforme Snyk, permet d’ignorer des suggestions.
Et il y a bien plus à découvrir sur cette fonction d’ignorance que vous ne le pensez (du moins, plus que je ne le pensais). Voyons comment ignorer un problème, puis découvrons les coulisses de l’implémentation de cette fonctionnalité.
Comment utiliser la fonction d’ignorance dans Snyk Code
Dans l’interface Web de Snyk Code, vous trouverez un nouveau bouton intitulé Ignorer (en bas à droite, avec une icône en forme d’œil barré) :
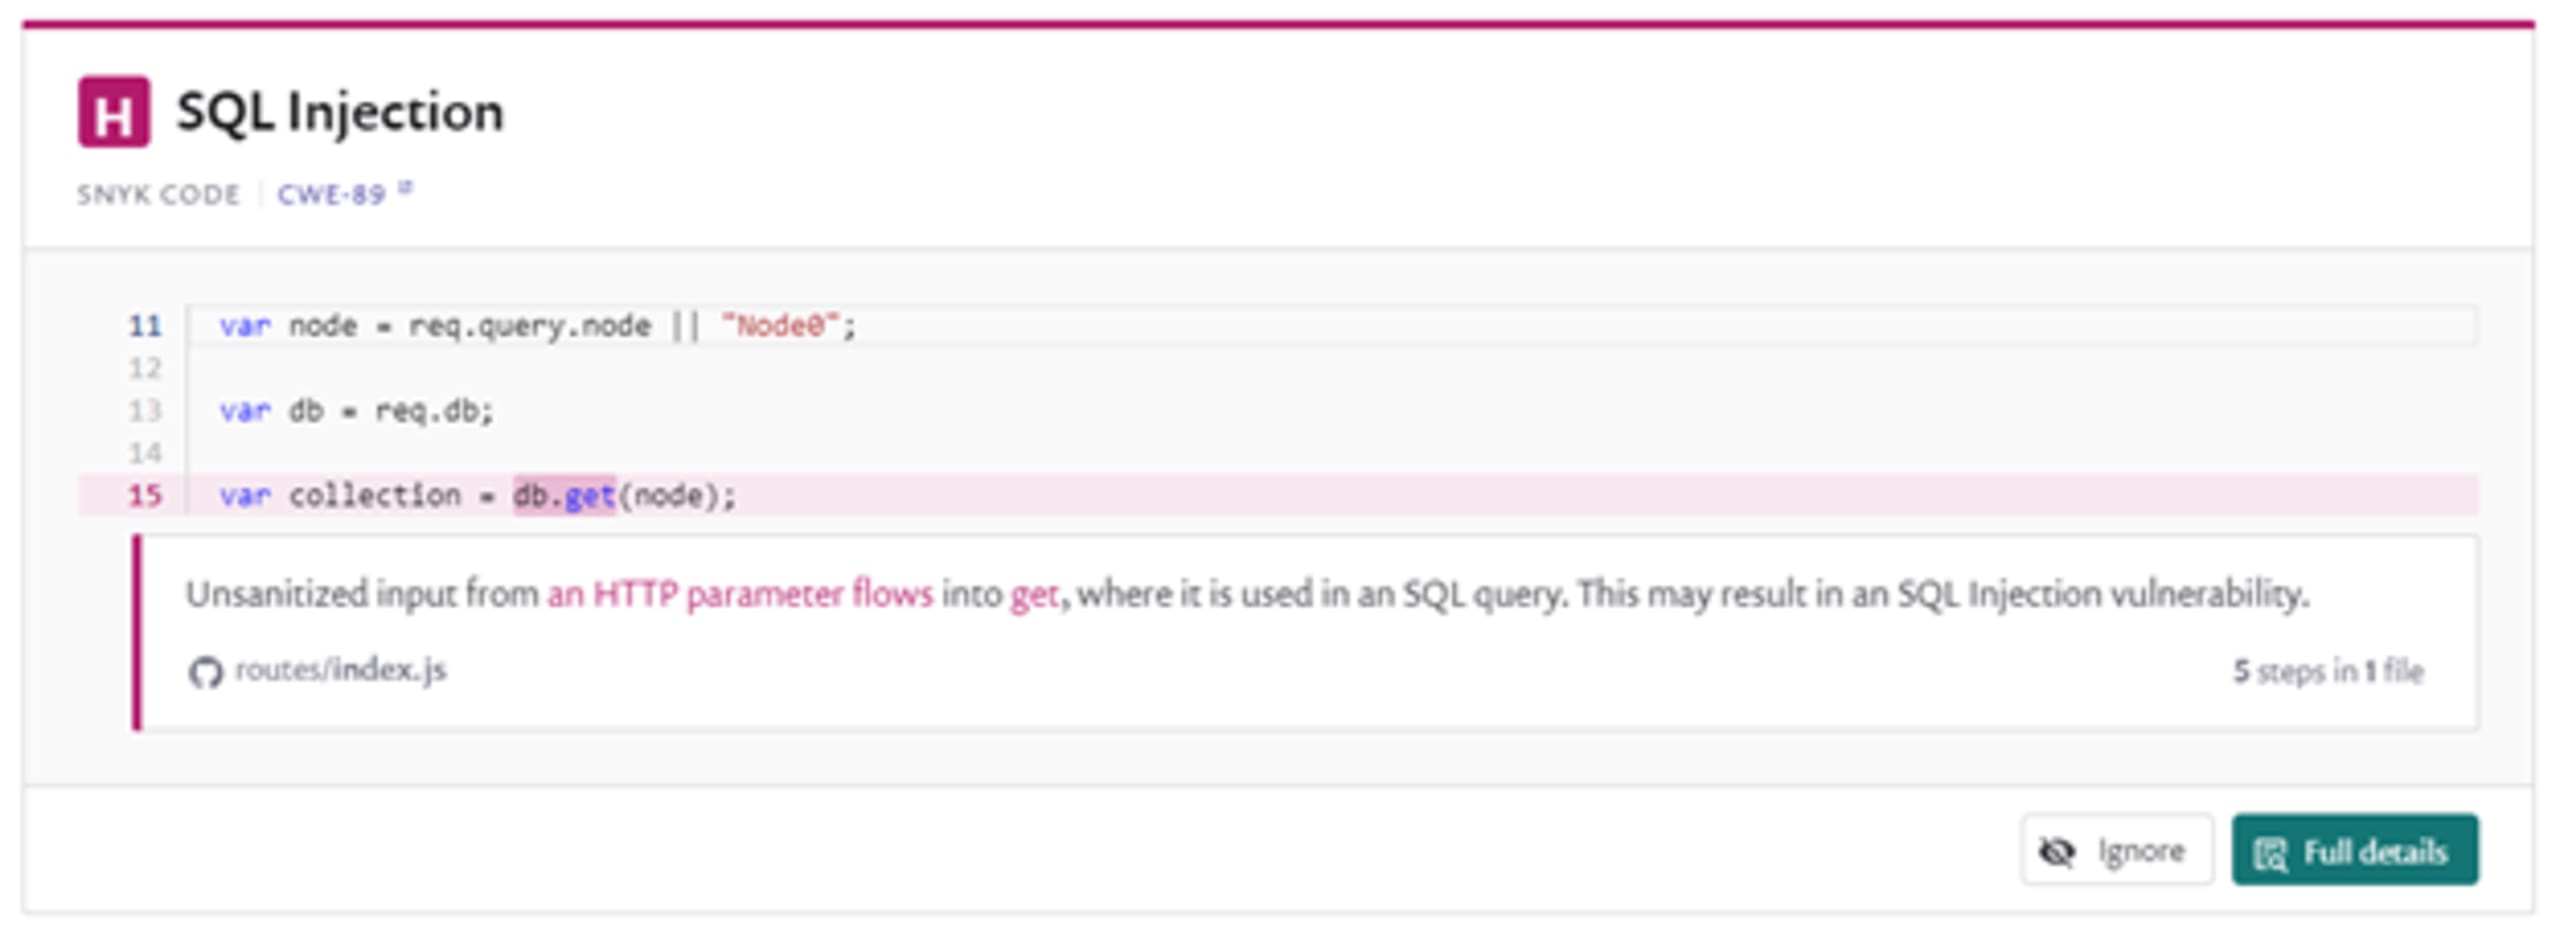
Ce bouton vous permet de configurer le moteur de test de sécurité des applications statique (SAST). Nous verrons bientôt comment cela fonctionne ; pour l’instant, concentrons-nous sur son utilisation.
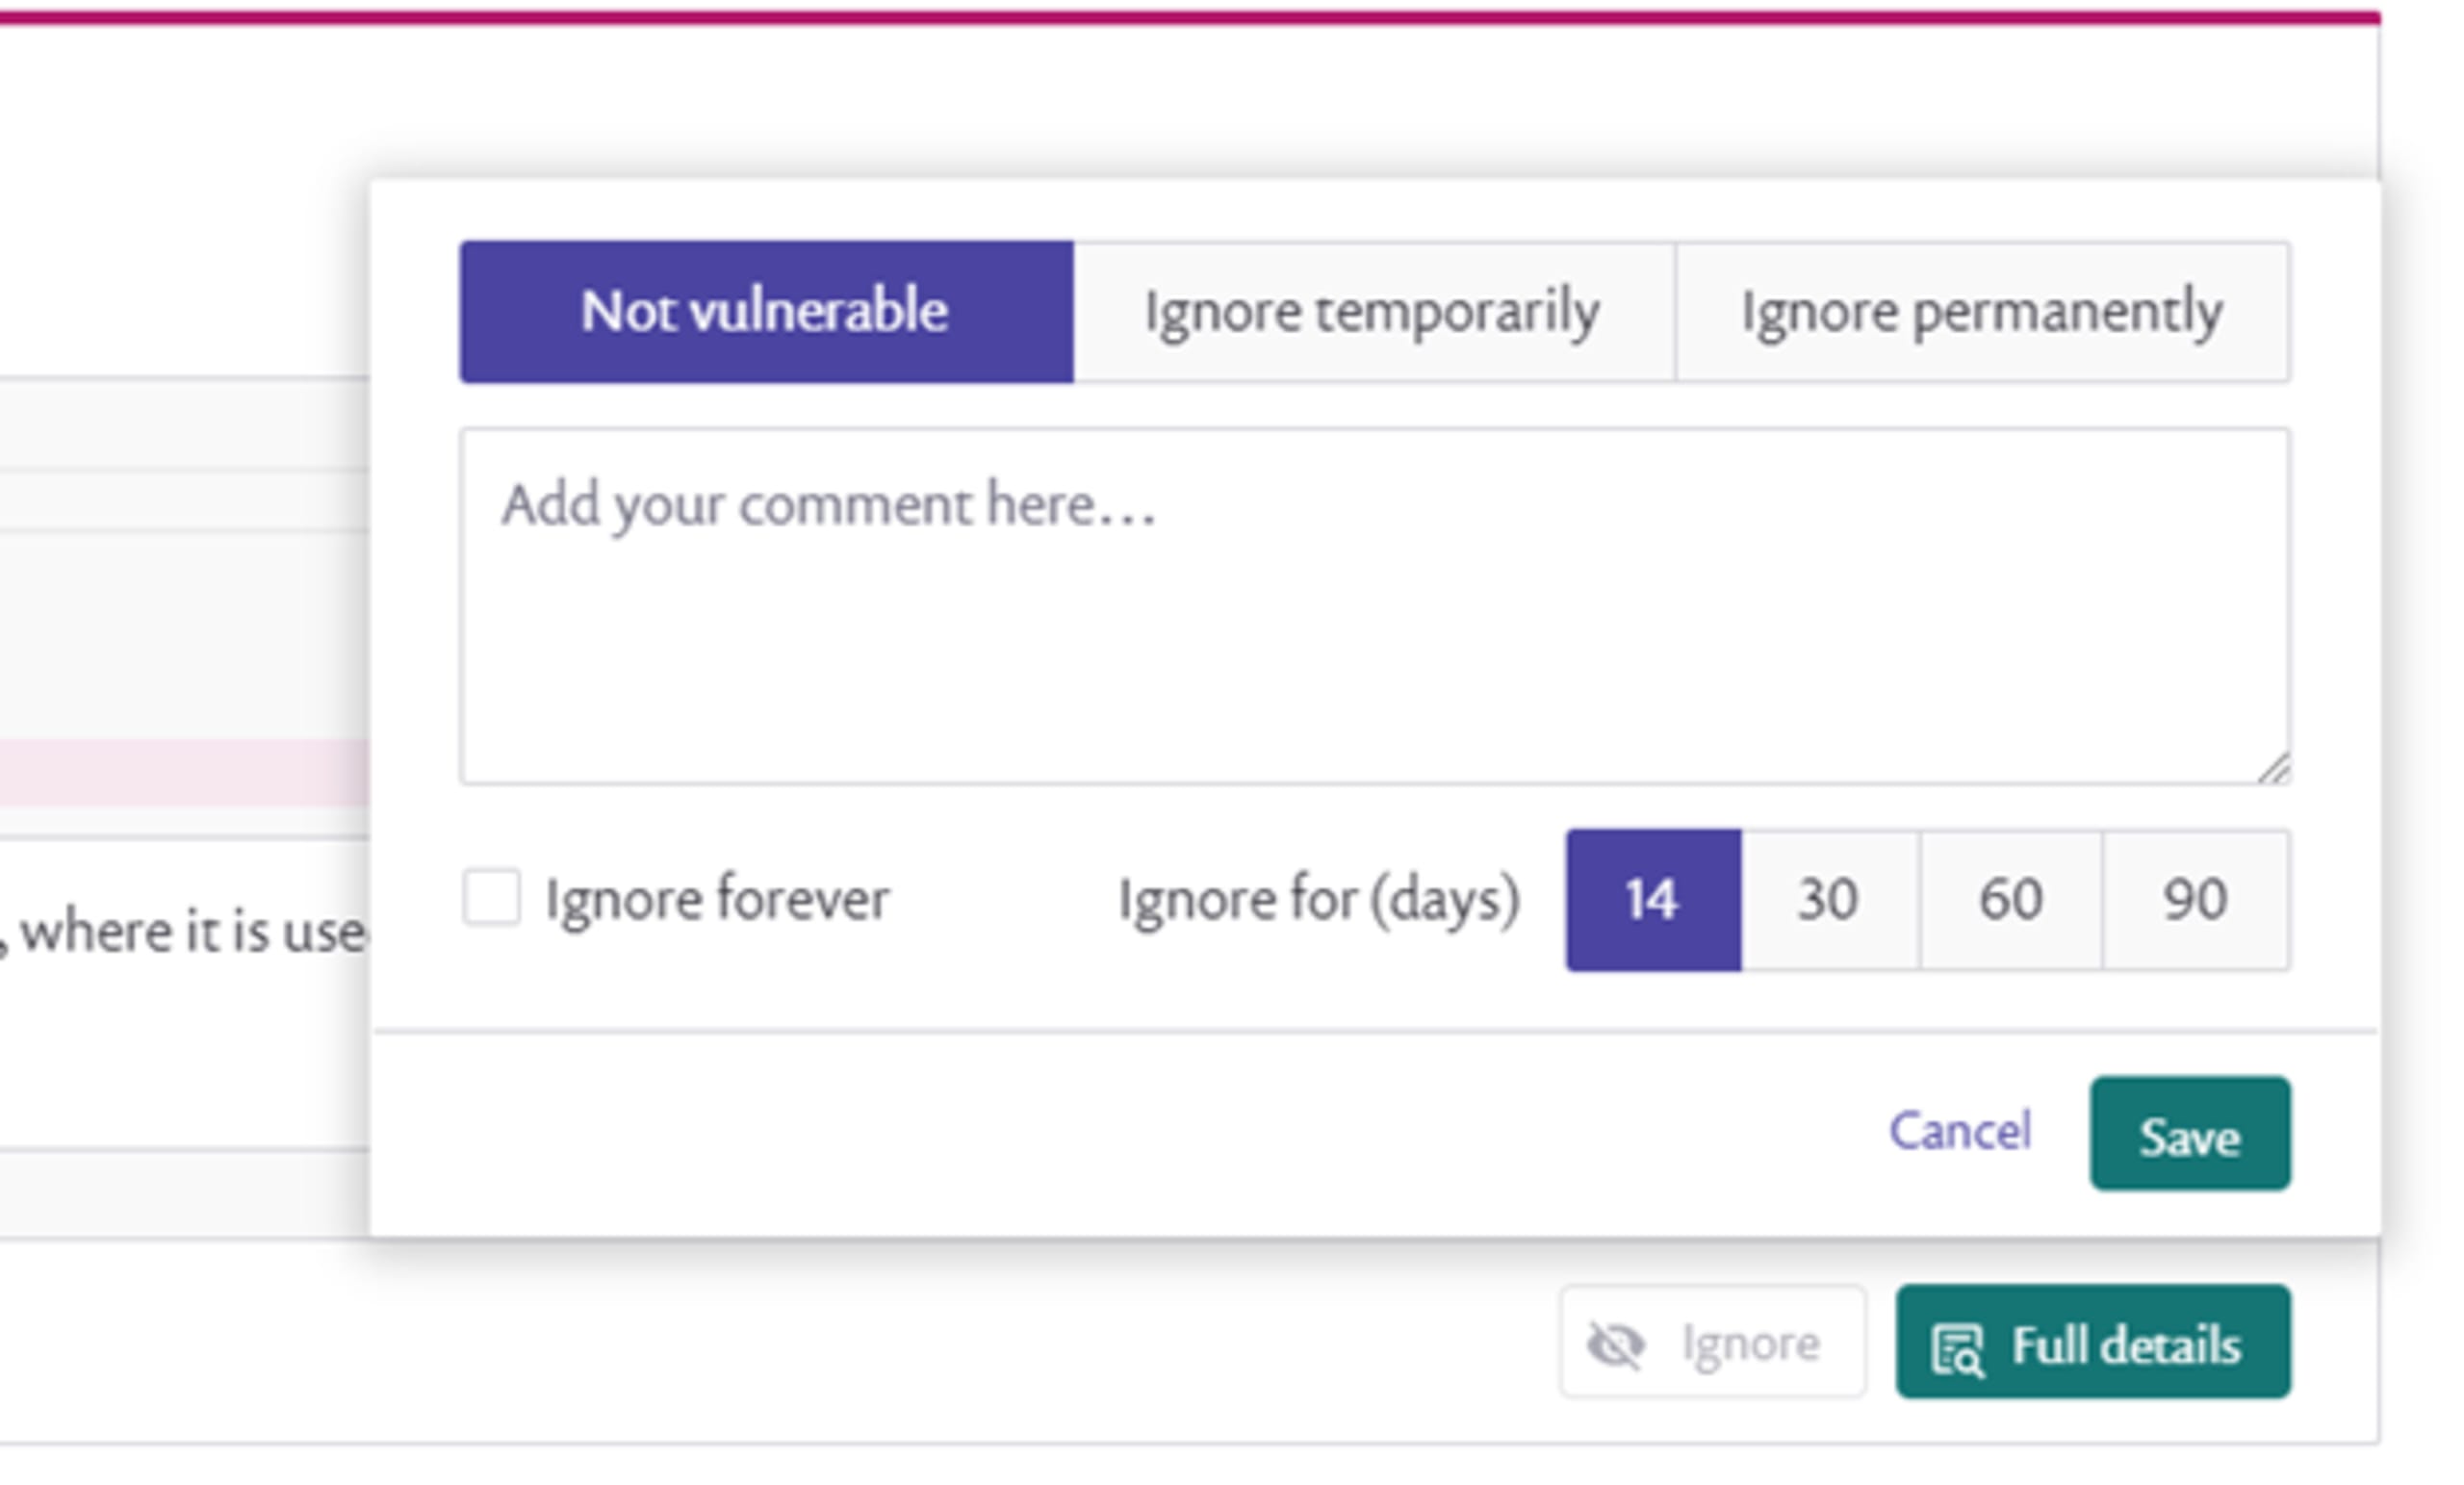
Lorsque vous cliquez sur Ignorer, une fenêtre superposée s’affiche (voir ci-dessus). Commencez par indiquer si le problème doit être marqué comme non vulnérable, ignoré temporairement (pour masquer le message pour le moment) ou ignoré définitivement (il ne sera pas corrigé). Vous pouvez ensuite ajouter un commentaire pour vous-même ou vos collègues. Nous vous recommandons vivement d’inclure une brève explication : sans commentaire, les décisions de la semaine dernière peuvent sembler bien mystérieuses. Enfin, vous pouvez définir la durée pendant laquelle le problème sera ignoré : 14, 30, 60 ou 90 jours, ou indéfiniment.
Si vous choisissez d’ignorer un problème, il est masqué par défaut. Un sélecteur d’état, à gauche, vous permet d’afficher les problèmes ignorés (et de supprimer ou modifier leur statut d’ignorance). Pour en savoir plus sur cette fonctionnalité, consultez notre documentation sur l’ignorance dans Snyk Code.
Ignorer des suggestions, c’est moins simple qu’il n’y paraît
Pour pouvoir marquer un problème comme ignoré (ou l’exclure du rapport de problèmes), il faut évidemment pouvoir le reconnaître de manière fiable. À chaque nouvelle analyse, le moteur doit retrouver le même problème et le marquer à nouveau. Il ne peut pas se contenter de mémoriser le nom du fichier et le numéro de ligne, car le code évolue constamment, tout comme les numéros de ligne. La solution traditionnelle, utilisée par les linters, consiste à ajouter un commentaire à côté du problème pour indiquer au système de l’ignorer. C’est aussi la méthode que nous avions mise en œuvre au départ. Cependant, certains développeurs nous ont dit qu’ils n’aimaient pas parsemer leur code de commentaires uniquement pour configurer l’analyse statique. Nous avons donc imaginé une solution originale et, selon nous, supérieure.
Les systèmes traditionnels utilisent le code source à l’origine du problème (ainsi que quelques lignes autour), calculent une empreinte et s’en servent pour identifier le problème. Toute modification du texte change son identifiant et supprime donc tous les indicateurs qui lui sont associés. Mais notre façon de penser, à nous les humains, est un peu différente. Si j’ajoute un commentaire à côté du problème, je n’ai pas réellement modifié le problème lui-même. Pourtant, l’empreinte change et le problème est considéré comme nouveau.
Pour remédier à cela, la plupart des autres outils ne font correspondre qu’un petit nombre de lignes du rapport. Ils risquent alors soit d’ignorer des rapports similaires lorsqu’un autre problème présentant une signature proche réapparaît (ignorance trop agressive), soit de perdre la correspondance à la suite de changements sans rapport dans le code (et de générer des rapports intempestifs). Pour mettre au point un mécanisme acceptable, certains outils utilisent même des listes composées de dizaines d’exceptions pour établir les correspondances entre rapports. Ces deux approches sont imparfaites. Elles s’appuient fondamentalement sur le texte, sans tenir compte de l’analyseur à l’origine du résultat. C’est comme si elles traitaient les mots d’une phrase comme une simple suite de caractères, sans chercher à en comprendre le sens.
Comment Snyk Code implémente la fonction Ignorer
L’analyse statique du code transforme notamment le code source en ce que l’on appelle une représentation intermédiaire. Cette structure de données capture le flux de données ou de contrôle du code, tout en en faisant abstraction de certains détails. Nous avons eu l’idée d’utiliser cette représentation pour générer l’empreinte. Ainsi, l’implémentation reconnaît le même problème même si vous refactorisez votre code ou renommez une variable. De plus, nous avons assoupli les exigences de correspondance exacte : la plupart des petites modifications apportées au code contenant un problème ignoré ne provoqueront donc pas sa réapparition dans le rapport.
En établissant les correspondances à un niveau sémantique, nous pouvons reconnaître le même problème qu’auparavant, comme le ferait un développeur. Vous n’avez donc plus besoin d’ajouter de commentaires dans votre code source. Par exemple, les deux extraits de code suivants, malgré leurs différences textuelles, signalent le même problème : seules les variables ont été renommées.
Nous ne faisons pas la sourde oreille à vos commentaires
Nous espérons que cette nouvelle approche de la fonction d’ignorance vous sera plus utile. Ce n’est qu’un exemple parmi d’autres de la manière dont vos précieux retours nous permettent d’améliorer le produit. N’hésitez pas à nous faire part de votre avis sur cette nouvelle fonction et à nous dire comment nous pourrions améliorer le produit à l’avenir. Vos retours nous sont précieux.
Sécurisez votre code grâce à des informations de pointe
Découvrez toutes les fonctionnalités SAST de Snyk Code en seulement 30 minutes.


