Vulnérabilités atteignables : comment hiérarchiser efficacement la sécurité des logiciels open source

Krysztof Huszcza
18 août 2020
0 minutes de lectureNos clients nous font souvent part d’un problème : ils sont submergés par les vulnérabilités.
Pour les petits projets, vous pouvez vous retrouver à dépendre de dizaines, voire de centaines de bibliothèques open source. Pour les grandes applications d’entreprise, vos dépendances peuvent sembler inclure la moitié de l’écosystème. La multiplication des dépendances tierces entraîne celle des vulnérabilités qui leur sont associées. Si la plupart des développeurs acceptent à contrecœur l’ampleur de l’empreinte de leur projet en dépendances tierces, livrer une application contenant des centaines ou des milliers de vulnérabilités connues dépasse généralement les limites du raisonnable.
Face à la multitude de vulnérabilités qui affectent votre application, il est légitime de se demander si tous ces problèmes sont réellement exploitables. Et si certaines vulnérabilités se trouvaient dans du code tiers que votre application n’exécute jamais ? Autrement dit, et si certaines vulnérabilités n’étaient jamais atteignables depuis le code de votre application ? Si vous le saviez, vous pourriez réduire la priorité de correction des vulnérabilités inatteignables et vous concentrer plutôt sur celles qui sont atteignables, c’est-à-dire celles qui vous affectent réellement en production. Vous devriez tout de même finir par traiter toutes les vulnérabilités, mais vous sauriez au moins par où commencer.
Cela semble idéal, mais comment déterminer concrètement quelles vulnérabilités sont atteignables et lesquelles ne le sont pas ? Chez Snyk, nous résolvons ce problème en associant l’expertise de chercheurs en sécurité à l’analyse statique automatisée. Examinons cette solution de plus près.
Fonctions vulnérables
Commençons par examiner le volet recherche en sécurité, qui vise à répondre à une question essentielle : quel code est réellement vulnérable ?
Pour chaque vulnérabilité, nous voulons savoir quelles lignes de code, fonctions, classes ou modules d’une bibliothèque donnée présentent un risque pour la sécurité. C’est essentiel : nous ne pouvons pas déterminer si le code vulnérable est atteignable sans préciser de quel code il s’agit. Malheureusement, les bases de données publiques sur les vulnérabilités ne fournissent pas ces informations.
Alors, comment repérer le code vulnérable ? Une méthode qui s’avère efficace dans la pratique consiste à le faire examiner manuellement par des experts en sécurité. Chez Snyk, une équipe d’analystes et de chercheurs en sécurité analyse en continu les vulnérabilités qui affectent nos clients. Avant d’ajouter une vulnérabilité à notre base de données, elle fait l’objet de recherches, puis nous l’annotons avec des métadonnées qui indiquent le code réellement vulnérable.
Pour décrire le code vulnérable, nous avons choisi d’utiliser les fonctions du programme. Pour chaque vulnérabilité, nous enregistrons un ensemble de noms et de signatures de fonctions. Certaines de ces fonctions contiennent littéralement le code vulnérable, tandis que d’autres contiennent les fonctions qui rendent le comportement vulnérable possible. Quelle que soit leur relation réelle avec la vulnérabilité, nous les appelons « fonctions vulnérables ». Les fonctions considérées comme vulnérables pour une vulnérabilité donnée sont déterminées au cas par cas.
Analyse de l’atteignabilité dans le graphe d’appels
Une fois les fonctions vulnérables identifiées pour chaque bibliothèque, nous devons déterminer si l’application les utilise. Voici le second volet de notre approche : l’analyse statique. Nous l’utilisons pour créer le graphe d’appels du programme fourni, puis nous nous appuyons sur ce graphe pour évaluer l’atteignabilité des fonctions vulnérables.
Avant d’aborder l’analyse statique, prenons un exemple pour illustrer comment un graphe d’appels permet de déterminer si du code vulnérable est atteignable. Imaginons une application web Java avec deux dépendances directes : spring-web et mongodb. spring-web dépend à son tour de deux autres bibliothèques : hibernate et jackson. mongodb dépend de slf4j. Nous pouvons représenter ces relations sous forme de graphe de dépendances.
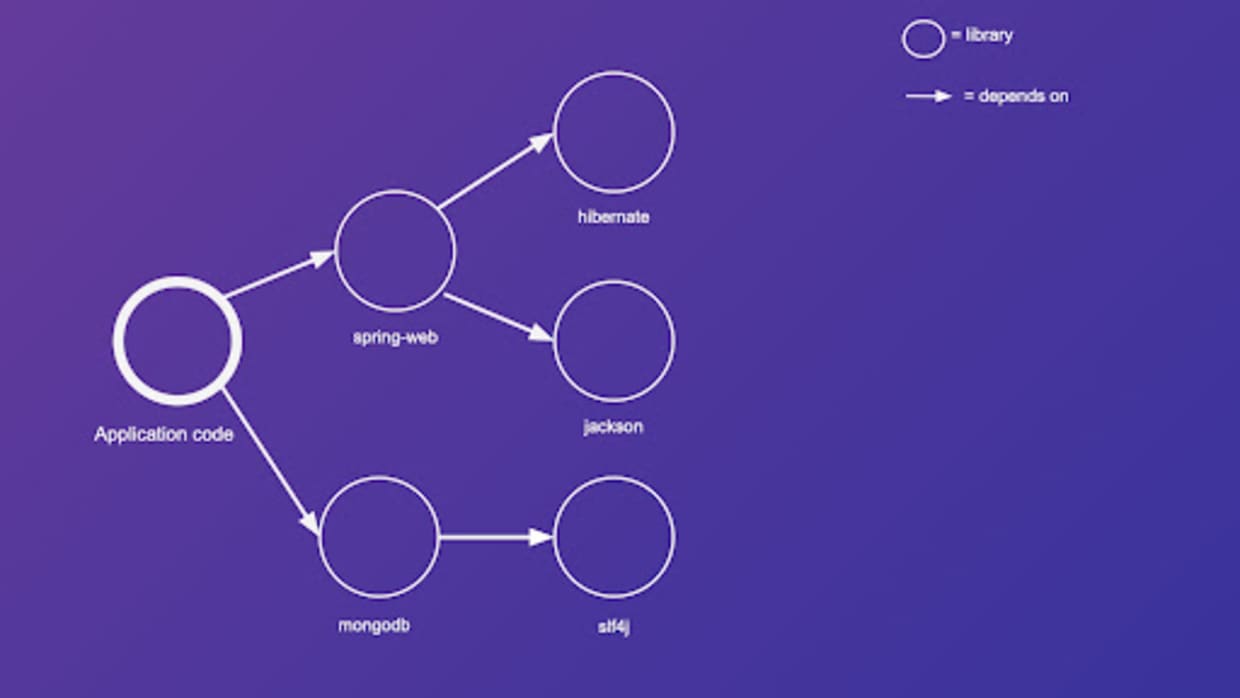
Ajoutons maintenant des détails au graphe en tenant compte des appels de fonctions. Simplifions énormément nos composants en supposant que le code de l’application, comme toutes les bibliothèques tierces, ne comporte que deux fonctions, à l’exception de spring-web, qui en comporte trois. Ajoutons toutes les fonctions au graphe sous forme de nœuds, puis une flèche de la fonction A vers la fonction B si, et seulement si, la fonction A appelle la fonction B.
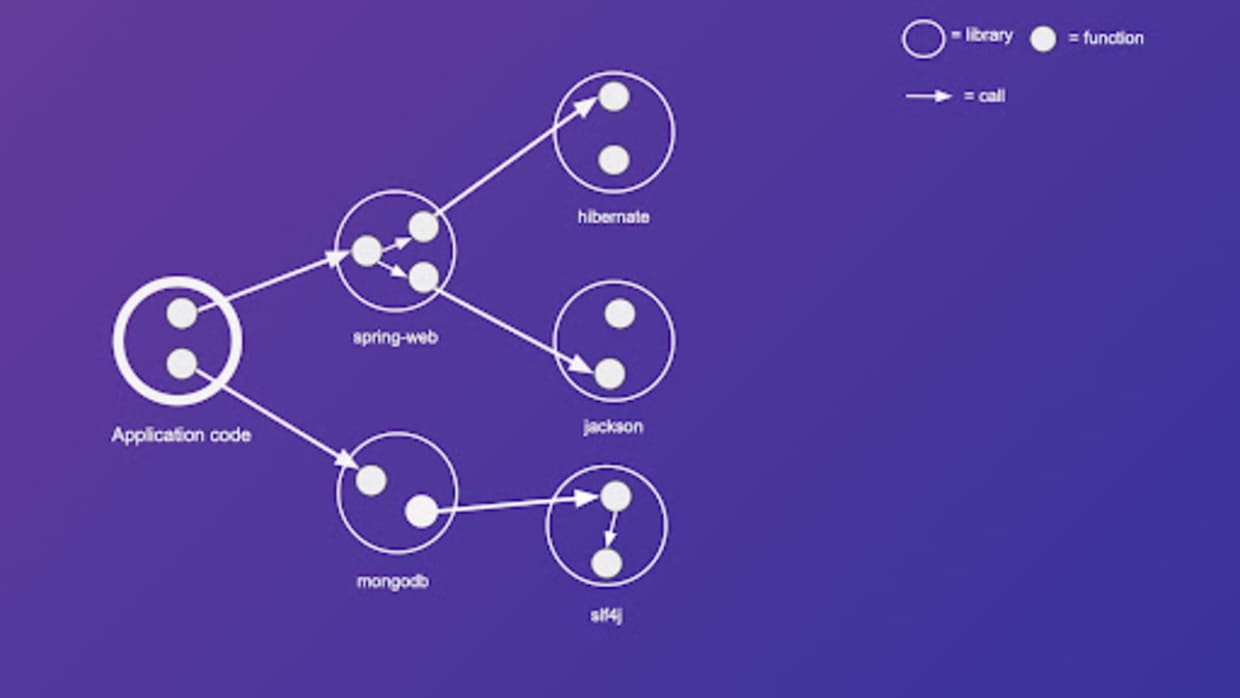
Nous obtenons une structure de données bien connue : un graphe d’appels. Ajoutons maintenant les fonctions vulnérables à notre graphe. Nous les représentons par des personnages Cookie Monster.
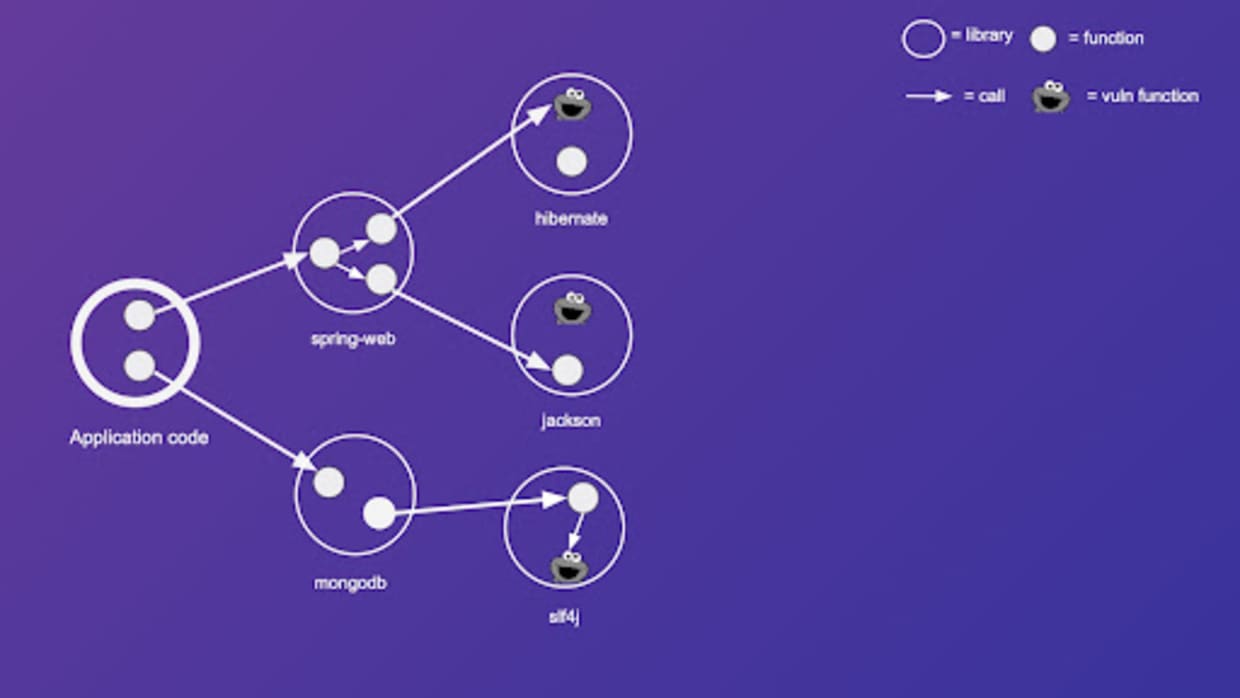
Enfin, définissons une règle simple d’atteignabilité pour notre graphe d’appels : une fonction X est atteignable depuis le code de l’application si, et seulement si, il existe dans le graphe d’appels un chemin qui part d’un nœud quelconque du code de l’application et aboutit à la fonction X. Selon cette règle, nous colorons en rouge toutes les fonctions atteignables et en vert celles qui ne le sont pas.
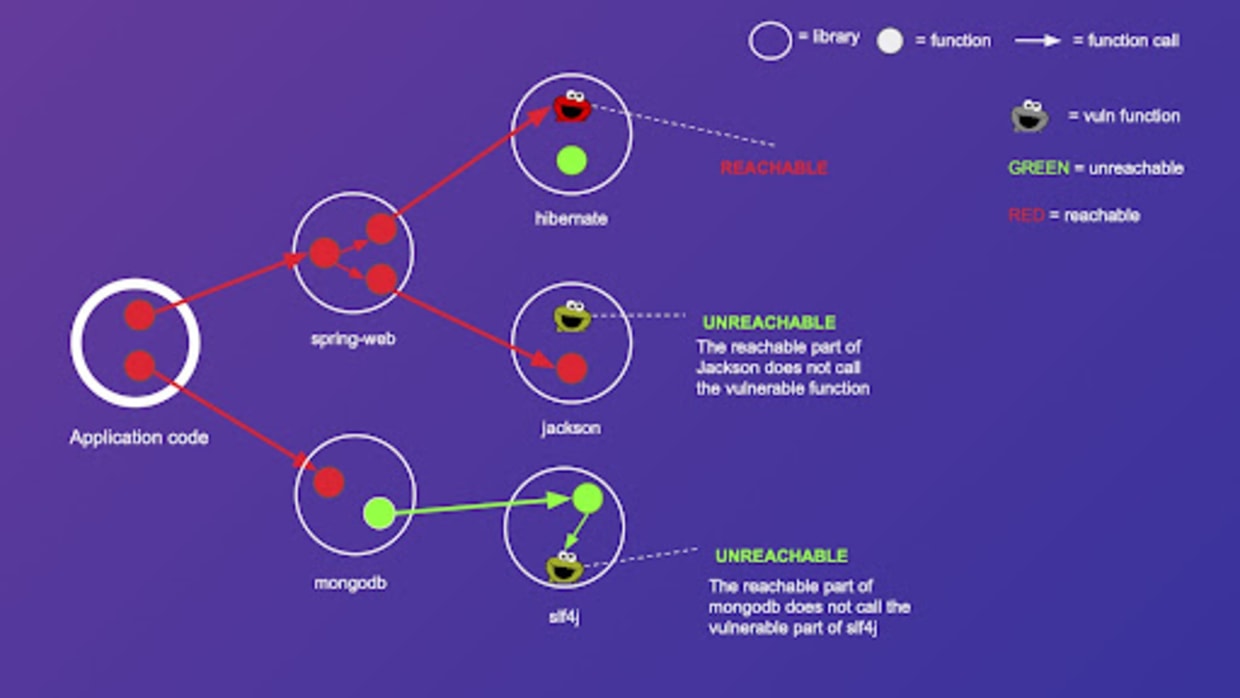
Comme nous pouvons le voir, certains personnages Cookie Monster (fonctions vulnérables) sont atteignables, et d’autres ne le sont pas. Cela nous permet de définir une règle de priorisation des vulnérabilités tierces de notre application. Si au moins une fonction vulnérable associée à une vulnérabilité donnée est atteignable, nous donnons la priorité à sa correction. En revanche, si aucune des fonctions vulnérables associées à cette vulnérabilité n’est atteignable, nous pouvons réduire la priorité de sa correction.
Nous avons donc défini l’analyse de l’atteignabilité dans un graphe d’appels et vu comment elle peut nous aider à hiérarchiser les vulnérabilités. Mais comment calculer concrètement le graphe d’appels ?
Exécuter l’application pour obtenir le graphe d’appels
Pour obtenir le graphe d’appels, vous pouvez exécuter l’application et recueillir des données sur l’exécution des fonctions à l’aide d’un agent d’exécution. Mais cette solution dynamique (à l’exécution) n’est pas idéale.
Tout d’abord, elle intervient « trop tard » dans le cycle de développement logiciel (SDLC), car elle nécessite une application en cours d’exécution. Or, les développeurs préfèrent toujours identifier et corriger les vulnérabilités atteignables avant que leur code soit fusionné dans la branche principale ou déployé en production. Ensuite, la configuration d’agents d’exécution nécessite généralement un paramétrage spécifique pour chaque application, ce qui représente beaucoup de travail. Enfin, les développeurs hésitent à ajouter de tels agents à leurs applications, par crainte de provoquer des interruptions de service ou une baisse des performances.
Nous avons donc cherché une meilleure solution, capable de répondre à tous les problèmes de l’approche dynamique : l’analyse statique du code.
Calculer statiquement le graphe d’appels
Contrairement à une solution dynamique (à l’exécution), l’analyse statique n’exécute pas le programme pour recueillir des informations. Nous analysons plutôt le code source de l’application. Nous élaborons un algorithme qui raisonne sur les variables du programme, les affectations, les appels de fonctions, les pointeurs, etc., puis déduit le graphe d’appels à partir de ce raisonnement.
Dans le domaine de la sécurité, l’analyse statique est déjà assez connue, notamment grâce au test de sécurité des applications statique (SAST). Le SAST vise à détecter les problèmes de sécurité dans le code de votre application, par exemple les injections SQL.
Source : publié par un plaisantin polonais, probablement jamais testé en pratique
N’oubliez pas que notre cas est différent du SAST. Nous ne cherchons pas à découvrir des failles de sécurité dans votre propre code. Nous nous intéressons aux failles présentes dans vos dépendances tierces.
D’accord, nous fournissons en entrée un programme (son code source) et toutes ses dépendances (leur code source), puis nous obtenons un graphe d’appels. Cela semble simple, non ?
Hélas, l’analyse statique n’est pas simple. Bien qu’elle constitue un domaine de recherche très actif, l’analyse des programmes réels demeure, dans une certaine mesure, un problème non résolu pour la plupart des langages de programmation. Prenons Java : ce langage peut sembler facile à analyser. Il est fortement typé et peu dynamique (comparé, par exemple, à Javascript). Examinons donc de plus près comment créer un graphe d’appels à partir de l’analyse statique de programmes Java, ainsi que les difficultés que cela pose.
Premier défi de l’analyse statique : la répartition dynamique
La répartition dynamique se produit lorsque la méthode à exécuter n’est sélectionnée qu’à l’exécution, en fonction du contexte. Elle est présente dans la grande majorité des langages de programmation : des langages orientés objet, comme Java (polymorphisme), aux langages fonctionnels, comme Haskell (fonctions d’ordre supérieur et fermetures). Elle complique l’analyse statique, car celle-ci doit modéliser le contexte qui détermine quelles fonctions seront appelées à l’exécution.
Prenons l’exemple Java suivant. Imaginons une interface Animal comportant une méthode makeSound et trois classes qui l’implémentent : Dog, Cat et GoblinShark. Examinons le programme simple ci-dessous.
En examinant uniquement cette méthode (sans tenir compte du code de createAnimal()), nous ne pouvons pas déterminer si un animal est un Dog, un Cat ou peut-être un GoblinShark.
Une façon de gérer cette situation consiste à envisager toutes les possibilités. Un algorithme de création de graphe d’appels fait précisément cela : l’analyse de hiérarchie de classes (CHA). Dans l’exemple ci-dessus, la CHA produirait le graphe d’appels suivant :
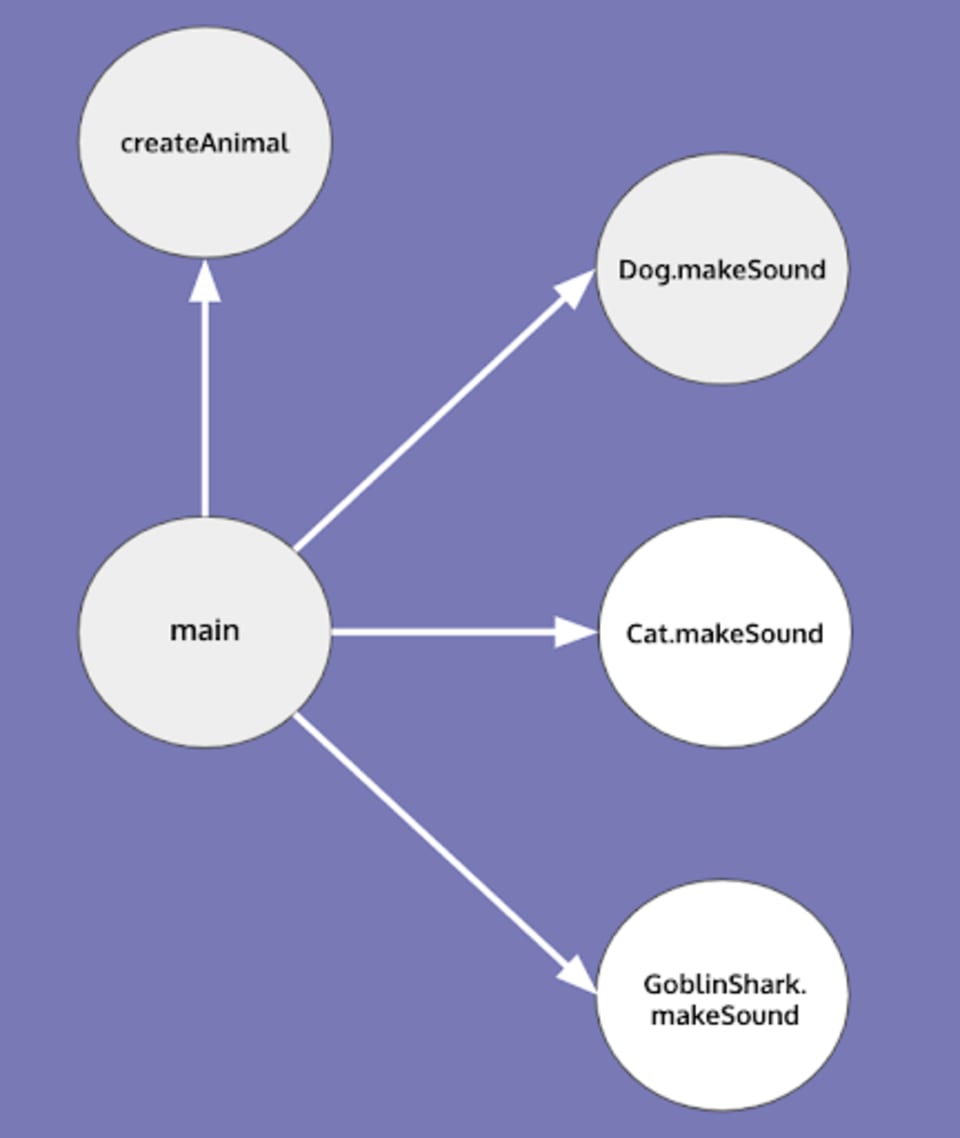
Ce graphe d’appels est fiable, mais peut manquer de précision. Prenons, par exemple, la fonction createAnimal précédemment omise, qui, comme il s’avère, ne crée que des chiens.
Comme la CHA envisage toutes les possibilités, le graphe d’appels ne change pas et reste imprécis. L’analyse qui résout ce problème s’appelle l’analyse points-to et nécessite de suivre les valeurs possibles vers lesquelles pointe une référence donnée.
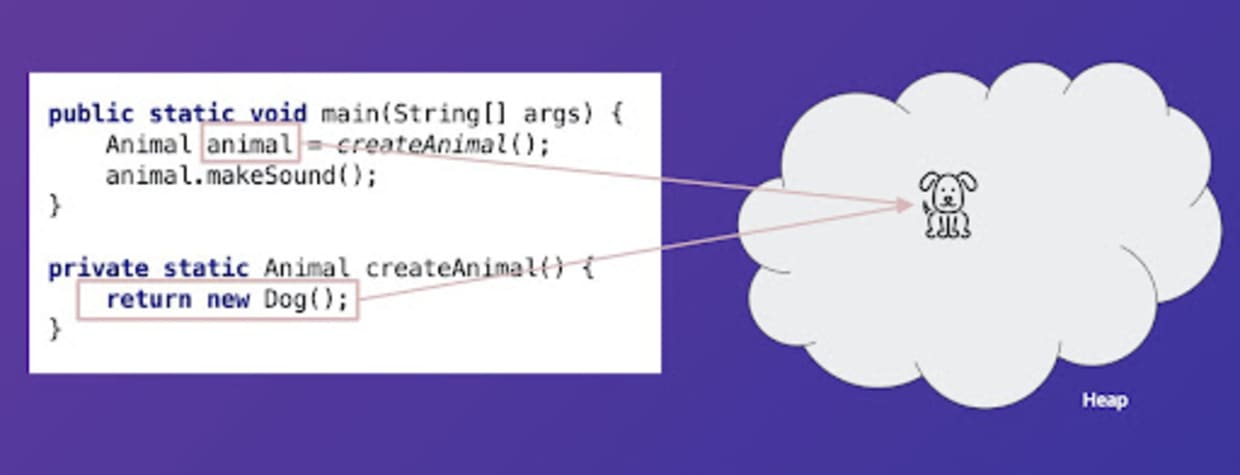
L’analyse points-to d’Andersen est un exemple d’analyse qui atteint cet objectif. Un algorithme de création de graphe d’appels utilisant l’analyse points-to d’Andersen produirait le résultat suivant.
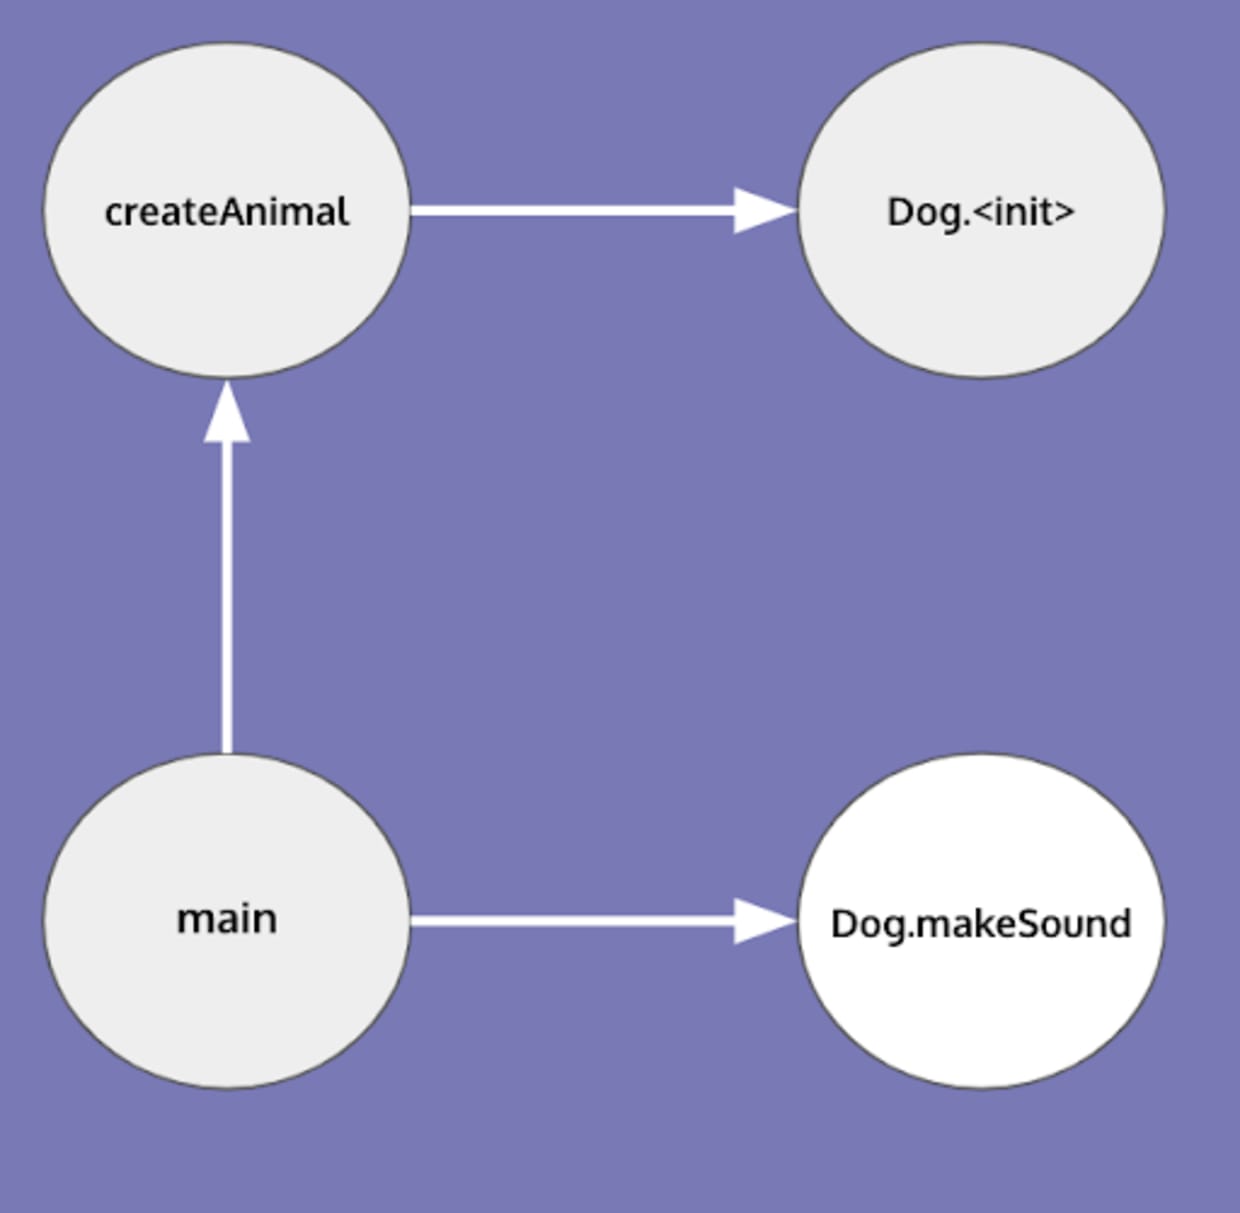
Flux de contrôle
Le suivi des pointeurs devient encore plus difficile lorsque nous prenons en compte le flux de contrôle du programme. Considérons le cas le plus simple :
Dans le programme ci-dessus, le chien n’émet jamais de son. Pour le déterminer correctement, l’analyse statique doit toutefois tenir compte de l’ordre des instructions. Pour des programmes aussi simples que celui-ci, nous pouvons recourir à une vieille astuce de compilateur et convertir le code en forme SSA (affectation statique unique). La SSA exige que chaque variable du programme soit affectée exactement une fois ; le problème ci-dessus disparaît alors.
Mais, en général, l’ordre des instructions influe sur l’état du programme et peut donc modifier le graphe d’appels. Par exemple, il est courant d’appeler une fonction init d’une bibliothèque tierce avant d’invoquer ses méthodes publiques.
La méthode init peut configurer un état interne complexe. Par conséquent, le graphe d’appels du programme ci-dessus pourrait être très différent de celui du programme ci-dessous.
Il faut également tenir compte des instructions de contrôle de flux, comme if, while, for, switch, etc. Considérons le programme suivant :
Ici, il est raisonnable d’ignorer la condition et de considérer que les deux branches de l’instruction if sont atteignables. En raison de ces embranchements, l’analyse points-to suit en réalité un ensemble de valeurs possibles vers lesquelles chaque variable du programme peut pointer, plutôt qu’une seule.
Autres éléments à prendre en compte
La création de graphes d’appels pour les langages de programmation modernes présente de nombreuses autres difficultés ; les exemples ci-dessus ne font qu’effleurer le sujet. Parmi les autres défis :
Collections : suivre les éléments stockés à chaque index d’une collection.
Analyse des méthodes publiques d’une bibliothèque : dans des langages comme Java, les méthodes publiques des bibliothèques acceptent souvent des interfaces en entrée afin de permettre aux clients de personnaliser les fonctionnalités, ce qui complique l’analyse points-to pour ces méthodes.
Exécution dynamique de code : un modèle très répandu, en particulier dans les frameworks, consiste à construire le nom de la fonction à l’exécution, à le stocker sous forme de chaîne de caractères, puis à utiliser une bibliothèque spéciale qui prend ce nom en entrée et exécute la fonction (par exemple, la réflexion en Java).
En pratique, lorsque vous utilisez l’analyse statique, vous devez décider explicitement de ce que vous souhaitez prendre en charge, car tout prendre en charge serait irréalisable sur le plan informatique. Autrement dit, les applications de l’analyse statique impliquent toujours un compromis entre précision et faisabilité informatique (temps et ressources nécessaires pour calculer le résultat). Par exemple, pour l’analyse de l’accessibilité du graphe d’appels de programmes Java, un compromis possible consisterait à exécuter une analyse points-vers d’Andersen standard avec SSA, à toujours supposer que toutes les branches des conditions sont prises (par exemple, les instructions if), à analyser toutes les collections comme s’il s’agissait de sacs (sans tenir compte des indices) et à ignorer l’exécution dynamique de code (sauf dans les frameworks populaires tels que Spring).
Conclusion
Dans cet article de blog, nous avons montré comment identifier les vulnérabilités atteignables en combinant recherche spécialisée en sécurité et analyse statique automatisée. Le résultat de cette analyse est toujours une approximation de la réalité. Mais cette approximation est utile, en particulier lorsque vous êtes développeur et que vous cherchez à repérer les vulnérabilités présentant le plus grand risque immédiat pour votre entreprise.
Chez Snyk, nous faisons tout notre possible pour aider les développeurs à résoudre leurs problèmes de sécurité. Nous avons récemment lancé plusieurs fonctionnalités destinées à les aider à prioriser les vulnérabilités. Évaluer l’accessibilité des vulnérabilités est l’une d’entre elles. Pour découvrir comment l’utiliser, consultez l’annonce de lancement ici.
Restez prudents et en sécurité !
Lancez-vous dans les compétitions Capture The Flag
Apprenez à résoudre des défis Capture The Flag en regardant à la demande notre atelier virtuel d’initiation.


