Opérateurs Kubernetes : automatiser le processus de publication

Arthur Granado
20 novembre 2020
0 minutes de lectureSnyk aide ses clients à intégrer la sécurité à leurs pipelines CI/CD ; nous consacrons donc beaucoup de temps à l’automatisation. Pour publier nos propres logiciels, nous cherchons constamment à adopter les meilleures pratiques en matière de tests et de publication.
Dans cet article, je vais parler du processus de publication de notre opérateur Kubernetes et montrer comment nous avons automatisé le déploiement de la version dans plusieurs dépôts.
Qu’est-ce qu’un opérateur Kubernetes ?
Un opérateur est une « … méthode permettant de conditionner, de déployer et de gérer une application Kubernetes… ». Les opérateurs encapsulent essentiellement les actions liées au cycle de vie d’une application dans du code, ce qui nous permet de les contrôler à l’aide de l’API native de Kubernetes.
Pourquoi les opérateurs Kubernetes sont-ils importants ?
Le modèle des opérateurs nous permet de contrôler les applications une fois qu’elles sont en cours d’exécution, à l’aide des API Kubernetes. Si nos applications doivent faire davantage que simplement démarrer ou s’arrêter, nous pouvons ainsi les contrôler pendant leur fonctionnement, de la même manière déclarative que celle utilisée pour gérer toutes nos autres ressources Kubernetes.
Qu’est-ce que l’automatisation de la publication d’applications ?
Avec l’essor des catalogues en ligne sur lesquels nous déployons nos logiciels pour que les utilisateurs puissent les adopter, le processus de distribution d’une version publiée peut devenir très complexe. Plusieurs étapes peuvent être nécessaires pour distribuer nos artefacts dans différents dépôts, et nous pouvons devoir fournir plusieurs types de métadonnées afin que notre application puisse être utilisée de différentes manières. L’automatisation de ces processus est essentielle pour garantir une distribution sans erreur de chaque version et permettre à nos utilisateurs d’adopter les nouvelles versions dès qu’elles sont disponibles.
Entrons dans le vif du sujet
Il y a quelques mois, l’équipe à l’origine de Container Scanning a lancé Snyk Operator, un opérateur pour Snyk Controller qui facilite son déploiement sur les clusters Kubernetes natifs et OpenShift.
Snyk Controller est une application Snyk déployée dans le cluster de l’utilisateur, qui analyse les images des conteneurs qui y sont exécutés. Pour en savoir plus sur cet outil remarquable, cliquez ici, et pour découvrir comment il peut vous aider à détecter les vulnérabilités dans vos images et applications, cliquez ici.
Il existe de nombreuses façons de créer des opérateurs pour Kubernetes. L’une des plus courantes est le framework Operator, créé à l’origine par CoreOS et désormais un projet de la CNCF. En plus de fournir un SDK pour le développement d’opérateurs, le framework Operator propose également un dépôt d’opérateurs développés par la communauté.
Snyk Operator est créé à l’aide de ce framework, et nous publions chaque version dans les dépôts en amont. La publication d’une nouvelle version de l’opérateur implique de nombreuses étapes, qui pourraient être sources d’erreurs si elles étaient effectuées manuellement.
Commençons par comprendre le processus de publication de Snyk Controller et la façon dont nous y intégrons la compilation de l’opérateur.
Dès qu’une Pull Request soumise par un contributeur est fusionnée dans notre dépôt Snyk Controller, notre pipeline d’intégration et de déploiement continus démarre. Il compile l’opérateur et son image, puis exécute les tests unitaires, les tests système et tous les tests d’intégration pour tester l’opérateur dans différents environnements.
Nous devons effectuer des tests dans une grande variété d’environnements, notamment différentes versions d’OpenShift et différentes versions de Kubernetes en amont. Dans tous ces environnements, nous utilisons Operator Lifecycle Manager, qui fait partie du framework Operator et étend Kubernetes afin de fournir une méthode déclarative pour installer, gérer et mettre à niveau les opérateurs et leurs dépendances dans un cluster.
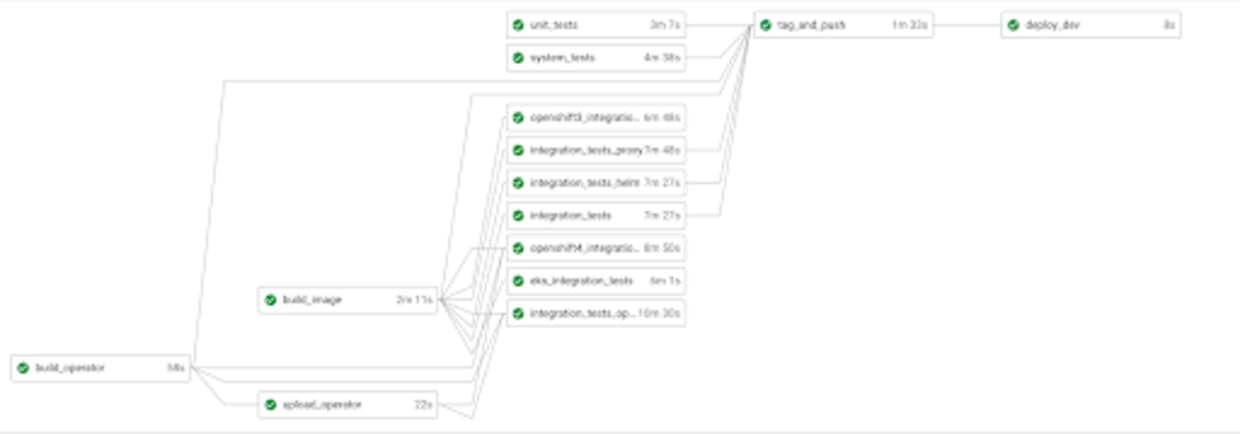
Une fois la version de Snyk Operator testée, nous devons distribuer la version finale. Nous publions actuellement Snyk Operator sur Operator Hub, ce qui permet aux utilisateurs de l’installer sur tout cluster Kubernetes exécutant Operator Lifecycle Manager, et nous le publions également dans le catalogue OpenShift.

Ce processus de publication implique deux Pull Requests distinctes, ce qui ajouterait beaucoup de travail si nous les créions manuellement : l’une pour ajouter Snyk Operator au dossier community-operators, et l’autre pour l’ajouter au dossier upstream-community-operators. La première publie Snyk Operator sur OperatorHub.io, et la seconde le publie dans le catalogue OpenShift.
Pour éviter le travail supplémentaire lié à ces étapes, nous voulons automatiser entièrement le processus de publication dans ces deux dépôts. Nous avons donc créé un script qui exécute toutes ces opérations dans notre pipeline CircleCI.
Tout d’abord, nous copions tous les fichiers nécessaires dans le dossier snyk-operator, en remplaçant la version de l’application par la plus récente. Nous téléchargeons l’outil operator-sdk et l’utilisons pour compiler l’image de Snyk Operator. Une fois cette étape terminée, nous transférons l’image vers notre registre public sur Docker Hubs.

Source : GitHub
Cette image nous permet d’exécuter les tests d’intégration dans le pipeline et de nous assurer que la version publiée fonctionne dans les clusters OpenShift 3.x et 4.x, ainsi que dans les clusters Kubernetes avec OLM. Nous utilisons ici une astuce pour exécuter les tests d’intégration. Nous transférons l’image de l’opérateur vers le registre Quay, créons un fichier operator-source.yaml, puis l’installons dans le cluster en appliquant ce fichier install.yaml.
Nous voulons ici reproduire le processus suivi par les utilisateurs lorsqu’ils installent l’opérateur depuis l’interface. Nous considérons le processus comme une boîte noire et suivons les étapes qu’OpenShift exécuterait lorsque l’utilisateur clique sur « installer » dans l’interface.

Source : GitHub

Source : GitHub

Source : GitHub
Enfin, une fois tous les tests réussis, nous pouvons publier Snyk Operator. Pour cela, nous devons créer des métadonnées supplémentaires. Elles ajoutent le ClusterServiceVersion et les définitions CustomerResource, qui servent à renseigner la page de Snyk Controller dans Operator Hub et à permettre l’intégration avec Operator Lifecycle Manager. OLM permet à l’utilisateur de s’abonner à un opérateur, réunissant ainsi l’installation et les mises à jour en une seule étape.
Comme ces métadonnées changent rarement, nous utilisons un modèle pour mettre à jour uniquement le numéro de version et le faire correspondre à la dernière version de Snyk Operator.

Source : GitHub
Une fois toutes ces étapes terminées, nous pouvons enfin créer nos commits : l’un pour ajouter les nouvelles métadonnées de l’opérateur dans le dossier community-operators, l’autre pour le dossier upstream-community-operators. Pour chaque commit, nous ouvrons une Pull Request dans le dépôt des opérateurs communautaires et y ajoutons le message demandé.

Source : GitHub
Vous trouverez ici et ici des exemples de ces Pull Requests automatisées.
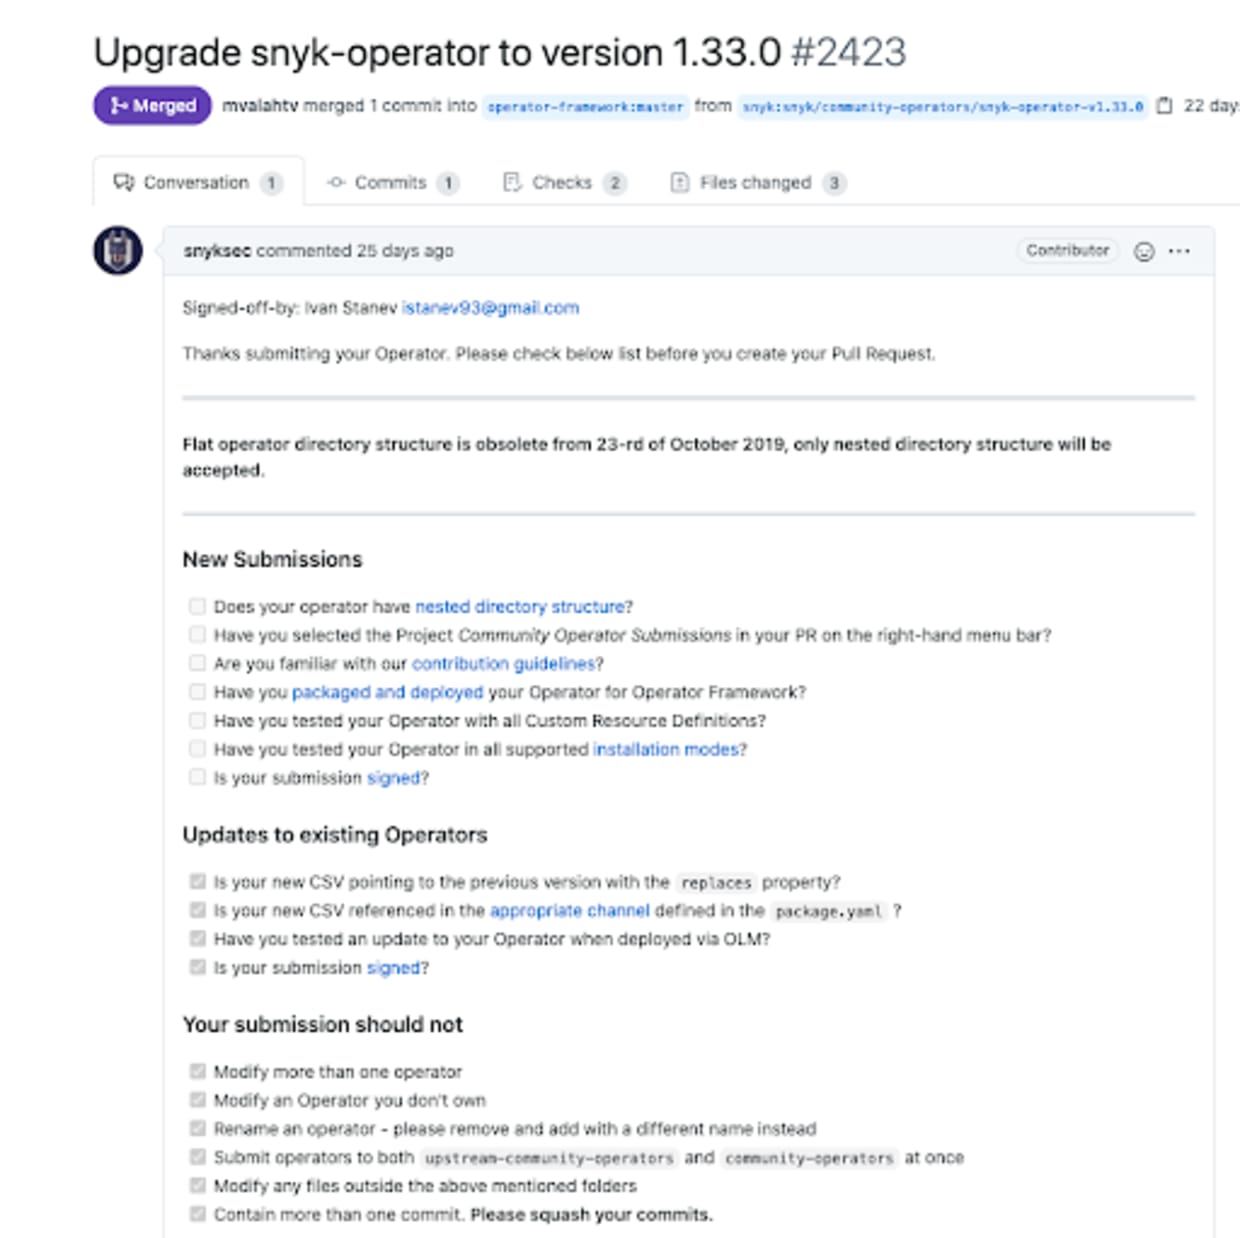
Une fois les Pull Requests créées, des tests automatisés sont exécutés dans OperatorHub et OpenShift. Les responsables de ces dépôts finissent ensuite par fusionner notre nouvelle version.
Pour conclure
En automatisant entièrement le processus de publication de notre opérateur, nous économisons beaucoup de temps et de ressources au sein de l’équipe d’ingénierie et pouvons continuer à fournir de nouvelles versions de nos logiciels aussi rapidement et efficacement que possible.
Snyk Controller intègre l’analyse Snyk à vos clusters Kubernetes. Vous pouvez ainsi importer et tester vos workloads en cours d’exécution, puis détecter les vulnérabilités dans les images et les configurations qui leur sont associées et qui pourraient réduire leur niveau de sécurité. Pour en savoir plus, cliquez ici et commencez à utiliser Snyk en créant un compte gratuit.
Lancez-vous dans les compétitions Capture The Flag
Apprenez à résoudre des défis Capture The Flag en regardant à la demande notre atelier virtuel d’initiation.


