Démystifier le désynchronisation HTTP

Sam Sanoop
30 juin 2020
0 minutes de lectureLe smuggling de requêtes HTTP est un type de vulnérabilité intéressant qui a gagné en popularité au cours de l’année écoulée. Cette vulnérabilité peut permettre à un attaquant d’exploiter certaines caractéristiques du protocole HTTP/1.1 afin de contourner les protections de sécurité, de mener des attaques de phishing et d’obtenir des informations sensibles issues de requêtes autres que les siennes.
Il convient également de noter que le smuggling de requêtes a suscité un vif intérêt au sein de la communauté, avec de nombreux rapports de bug bounty très rémunérateurs ces derniers mois. Snyk a par ailleurs observé que 18 vulnérabilités liées au smuggling de requêtes HTTP dans des dépendances avaient été publiées en 2020 à ce jour.
Cette vulnérabilité a été abordée pour la première fois par Watchfire dans son livre blanc de 2005 intitulé « HTTP Request Smuggling ». Ces travaux ont ensuite été approfondis par le chercheur Regis Leroy, puis par James Kettle, de l’équipe de sécurité de Portswigger, lors de la conférence BlackHat USA 2019, ce qui lui a valu une attention médiatique accrue.
Cet article vise à démystifier cette vulnérabilité et à fournir aux responsables de projets open source des conseils de correction pour éliminer le smuggling de requêtes HTTP de leurs projets.
Contexte
À mesure que de nouvelles attaques et vulnérabilités gagnent en popularité et attirent l’attention des médias, les bibliothèques open source sont souvent ciblées par des attaquants qui cherchent à les exploiter dans des conditions réelles. En raison du manque de connaissances sur les mesures correctives, il faut souvent des semaines, voire des années, pour corriger ces vulnérabilités dans les bibliothèques concernées. Pour sécuriser la communauté open source, l’équipe Snyk Security mène régulièrement des recherches sur les vulnérabilités, notamment le smuggling de requêtes HTTP, afin de détecter celles qui touchent les dépendances open source et de fournir aux responsables de leur maintenance des conseils concrets pour les corriger.
Snyk a notamment cherché à déterminer l’impact du smuggling de requêtes HTTP sur l’écosystème des dépendances open source, et a ainsi découvert de nombreuses vulnérabilités. Vous trouverez ici plus d’informations sur les vulnérabilités découvertes.
Snyk a constaté qu’il existe trop peu de ressources publiques fournissant des conseils adaptés pour corriger le smuggling de requêtes HTTP. En outre, les responsables de la maintenance ont parfois dû publier plusieurs versions avant de corriger et de résoudre correctement cette vulnérabilité. Avec cet article, nous souhaitons combler cette lacune et fournir des conseils détaillés à toutes les personnes responsables de la maintenance qui souhaitent savoir comment traiter ce problème.
Explication de la vulnérabilité de smuggling de requêtes HTTP
Pour comprendre le smuggling de requêtes HTTP, il faut d’abord connaître les éléments suivants :
Keep-Alive et pipelining
Le concept de keep-alive et de pipelining a été publié initialement dans la RFC 2616.
L’en-tête Keep-Alive est un en-tête hop-by-hop qui fournit des informations sur une connexion persistante. Dans les serveurs Web, Keep-Alive peut être spécifié dans l’en-tête « Connection », ce qui permet au serveur Web de maintenir une socket/connexion TCP ouverte. Cet en-tête permet d’utiliser une seule connexion pour plusieurs requêtes et réponses, ce qui peut réduire la surcharge et améliorer les performances d’un serveur Web. Cette fonctionnalité est prise en charge par tous les navigateurs et serveurs actuels.
Le pipelining est une autre fonctionnalité introduite dans la RFC 2616. Elle permet à un serveur Web de traiter les requêtes de manière asynchrone, sous la forme d’un flux premier entré, premier sorti, plutôt que de traiter chaque requête individuellement. Le serveur peut ainsi envoyer une requête sans attendre la réponse à la précédente.
Content-Length et Transfer-Encoding
Les requêtes HTTP peuvent contenir un corps de message. La présence de ce corps dans une requête est indiquée par un champ d’en-tête Content-Length ou Transfer-Encoding. Ces en-têtes servent au cadrage des messages : ils indiquent au serveur où se termine un message et où commence le suivant.
Content-Length, défini dans la RFC 7230, section 3.3.2, est un en-tête HTTP qui indique la taille du corps de la requête. On le retrouve couramment dans les requêtes HTTP POST, qui contiennent des données dans leur corps. À noter que les requêtes GET ne devraient généralement pas contenir l’en-tête Content-Length, puisqu’elles n’ont pas de corps.
Transfer-Encoding, également défini dans la RFC 7230, a été créé pour permettre l’envoi de données binaires sur HTTP. Transfer-Encoding comporte plusieurs directives ; cet article se concentre sur la directive chunked.
La directive chunked permet d’envoyer les données sous la forme d’une série de blocs, accompagnés de la longueur de ces blocs indiquée au format hexadécimal, puis d’un retour chariot et d’un saut de ligne. La directive chunked prend fin avec 0 suivi d’une séquence vide. Vous trouverez ci-dessous un exemple de requête chunked.
Smuggling de requêtes
Une pile de serveurs Web moderne comprend souvent plusieurs serveurs Web, des équilibreurs de charge et des serveurs WSGI. Voici un schéma simple pour illustrer cela :
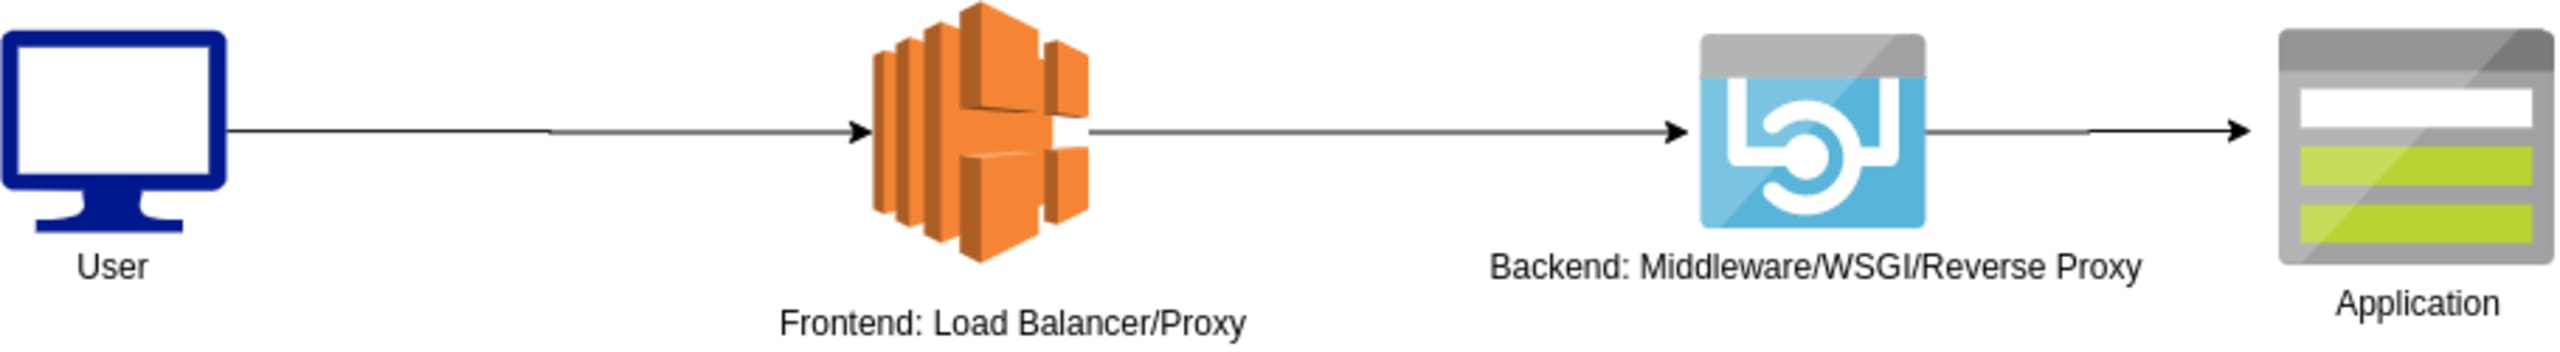
Les vulnérabilités de smuggling de requêtes HTTP apparaissent lorsque le frontal et le serveur dorsal n’interprètent pas de la même manière les limites d’une requête HTTP, ce qui entraîne une désynchronisation entre eux. Cela s’explique par le fait que de nombreuses bibliothèques frontales et dorsales s’écartent des spécifications RFC lorsqu’elles traitent les en-têtes Content-Length et Transfer-Encoding. Le corps des requêtes HTTP peut être délimité à l’aide de ces deux en-têtes, et des écarts par rapport aux spécifications peuvent se produire. Une partie d’une requête est alors ajoutée à la requête suivante ou dissimulée dans celle-ci, ce qui permet à un autre utilisateur de recevoir la réponse à la requête dissimulée.
Cette vulnérabilité peut être exploitée pour mener des attaques de phishing, empoisonner le cache, réaliser du cross-site scripting (XSS), et bien plus encore. James Kettle a publié l’année dernière de plus amples informations sur l’exploitation de cette vulnérabilité lors de BlackHat USA 2019, dans une présentation intitulée « HTTP Desync Attacks: Request Smuggling Reborn ». Cet article se concentre sur les deux techniques de smuggling de requêtes les plus courantes :
CL:CL : technique d’attaque par double Content-Length
CL:TE : Content-Length et Transfer-
Encoding : technique d’attaque
CL:CL : technique d’attaque par double Content-Length
Selon la RFC 7230, section 3.3.3#4 :
« Si un message est reçu sans Transfer-Encoding et avec plusieurs champs d’en-tête Content-Length dont les valeurs diffèrent, ou avec un seul champ d’en-tête Content-Length dont la valeur est invalide, le cadrage du message est invalide et le destinataire DOIT le traiter comme une erreur irrécupérable »
Cependant, la plupart des intergiciels et des serveurs Web traitent actuellement les requêtes GET contenant un corps avec une certaine tolérance. En outre, la RFC 7231, section 4.3#4.3.1 indique : « La charge utile d’un message de requête GET n’a pas de sémantique définie ; l’envoi d’un corps de charge utile dans une requête GET peut amener certaines implémentations existantes à rejeter la requête ». Cela indique que la plupart des serveurs et mandataires sont susceptibles de prendre ce comportement en charge. Dans certains cas, cela peut entraîner des attaques par smuggling de requêtes. Cet article examine une variante de cette attaque.
Lorsque deux en-têtes Content-Length sont présents, des attaques par smuggling peuvent se produire si le frontal et le serveur dorsal ne s’accordent pas sur l’en-tête Content-Length à privilégier.
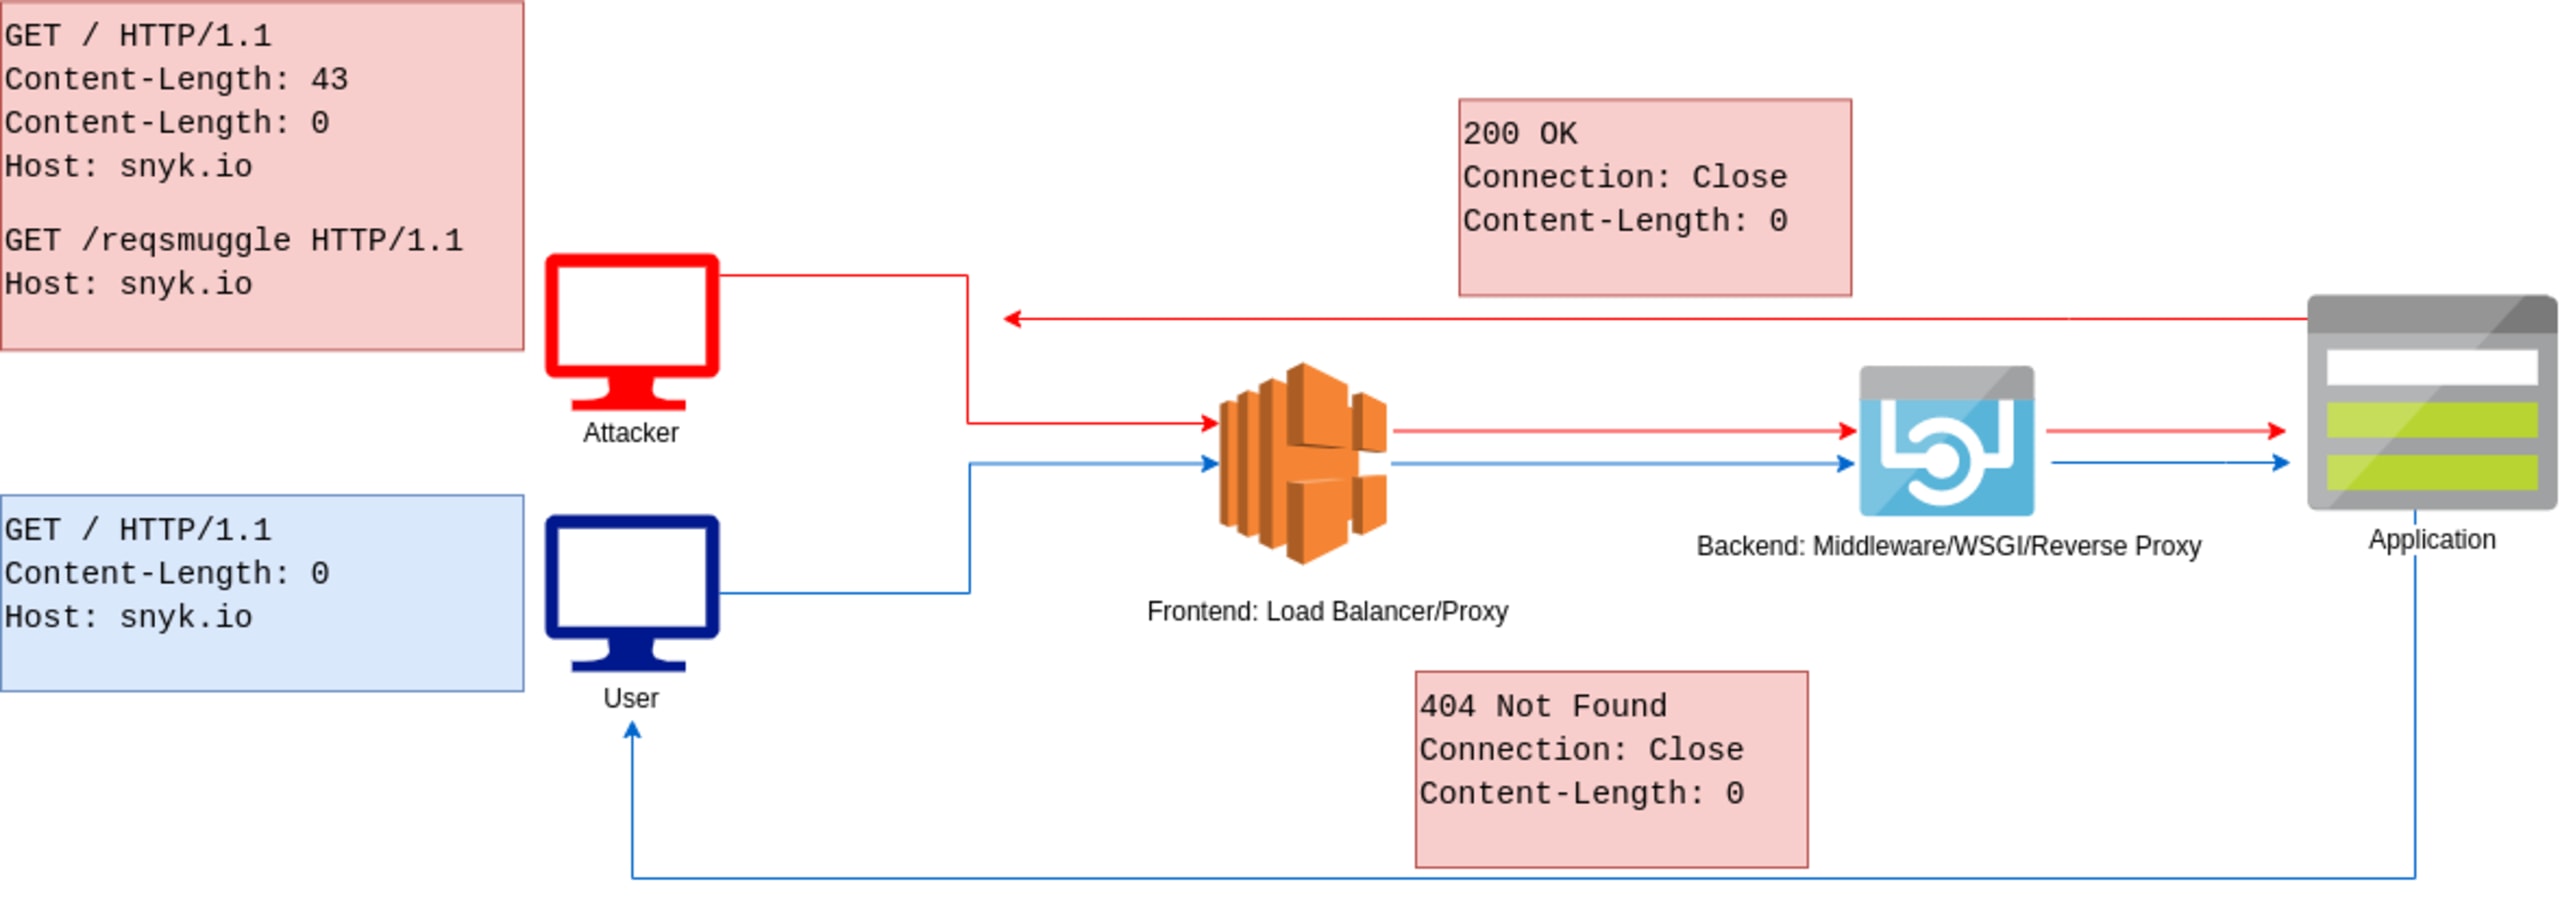
Dans la requête HTTP ci-dessus, une requête contenant deux en-têtes Content-Length est envoyée à une cible dont le frontal est un mandataire ou un équilibreur de charge. Le mandataire respecte le premier en-tête Content-Length et le privilégie ; il considère donc la requête dissimulée comme faisant partie du corps de la requête, même si une requête GET ne devrait pas avoir de corps et que deux en-têtes Content-Length sont présents. Lors du traitement par le serveur dorsal, le premier en-tête Content-Length est ignoré et le second est privilégié. Comme la valeur du second en-tête Content-Length est zéro, le serveur dorsal n’attend aucun corps de requête et traite la requête /reqsmuggle comme une autre requête pipelinée. Un autre utilisateur peut donc recevoir la réponse à cette requête dissimulée.
CL:TE : technique d’attaque Content-Length/Transfer-Encoding
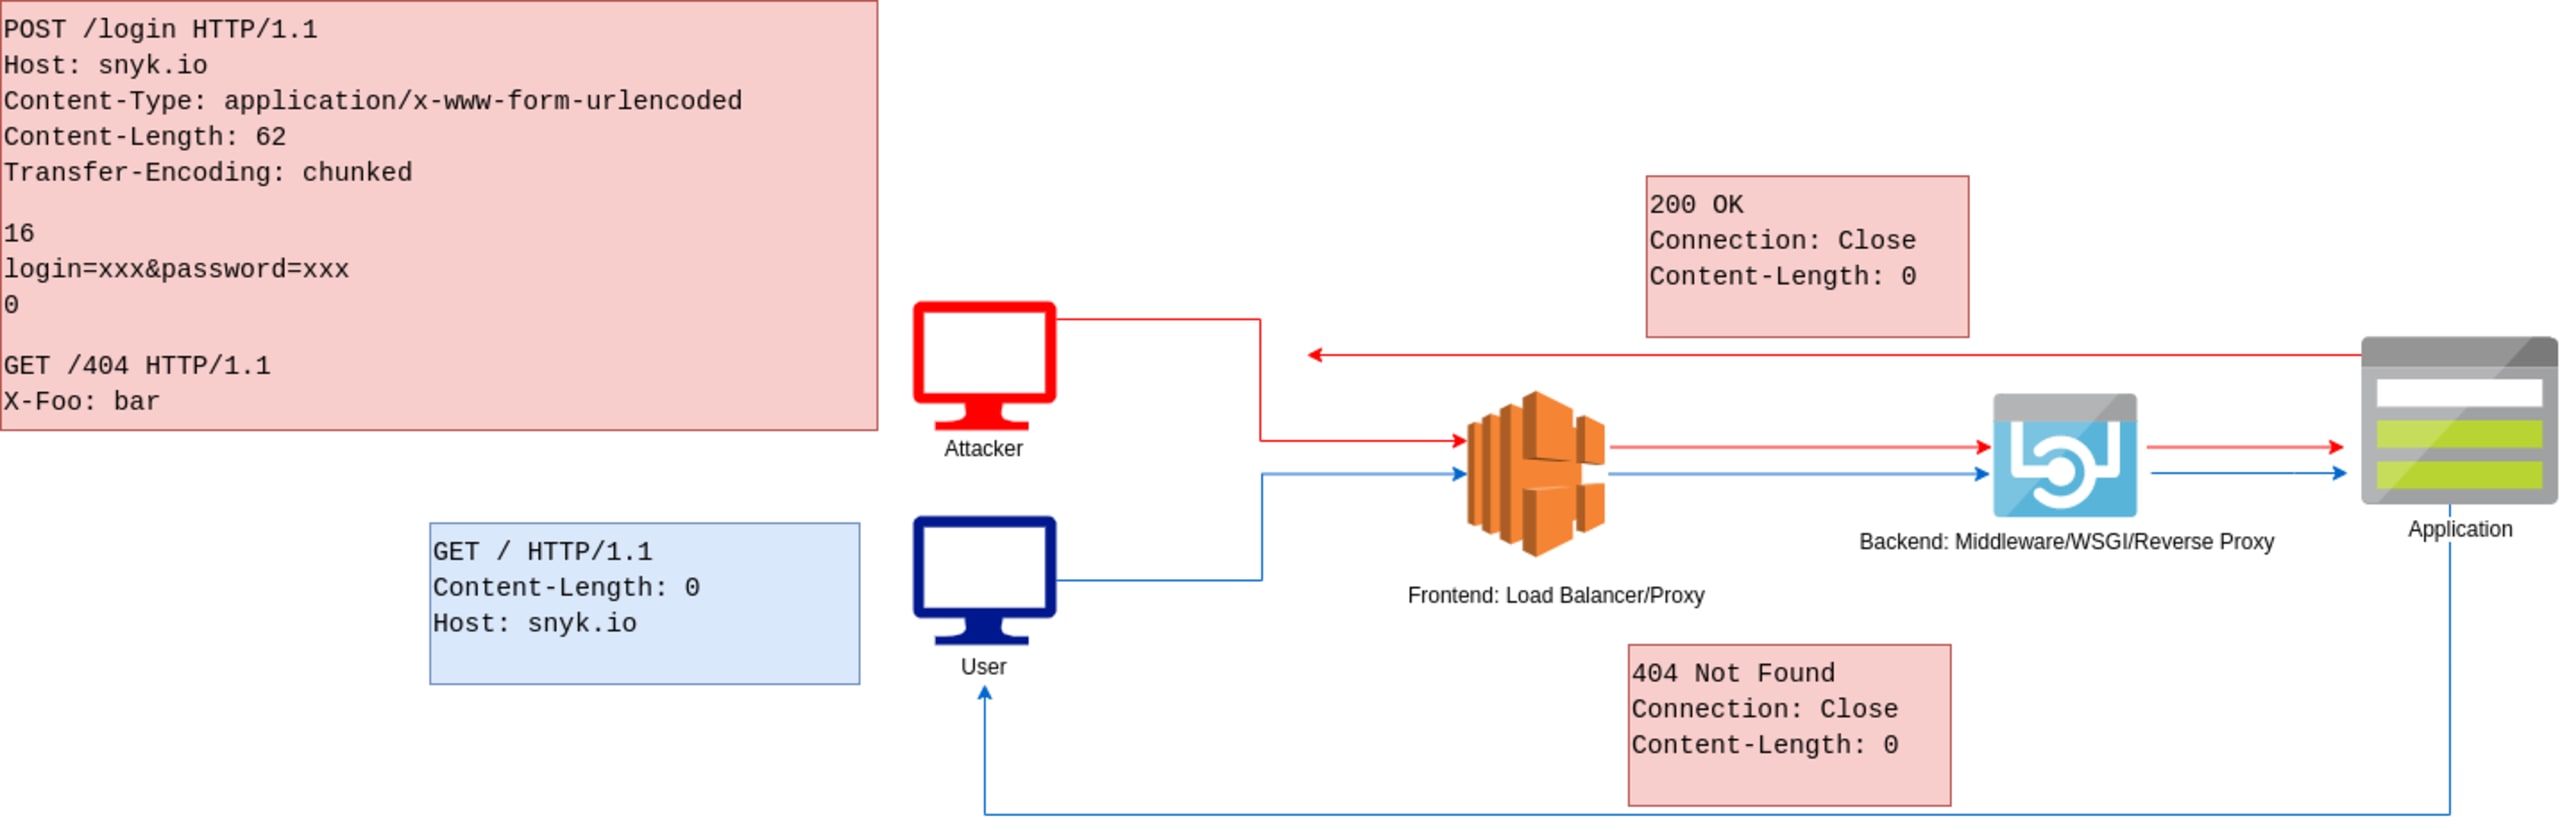
Cette technique répandue, découverte par James Kettle, de PortSwigger Labs, consiste à placer un en-tête Content-Length et un en-tête Transfer-Encoding dans une même requête HTTP et à les manipuler de sorte que le mandataire frontal et le serveur dorsal privilégient ces en-têtes différemment et traitent la requête dissimulée de façons distinctes. Voici un exemple de requête qui illustre cette vulnérabilité.
Lorsque le mandataire frontal traite cette requête, il respecte l’en-tête Content-Length et le privilégie par rapport à l’en-tête Transfer-Encoding. Le serveur dorsal, quant à lui, privilégie l’en-tête Transfer-Encoding. Il traite donc la requête jusqu’au caractère 0. La requête GET 404 est alors considérée comme une requête pipelinée distincte.
Ce problème se produit parce que le frontal privilégie l’en-tête Content-Length par rapport à l’en-tête Transfer-Encoding. Selon la section 3.3.3#3 de la RFC 7230, si un message contenant à la fois Content-Length et Transfer-Encoding est accepté, l’en-tête Transfer-Encoding prévaut sur Content-Length. Le frontal ne respecte pas cette règle.
Lorsque le frontal est susceptible de privilégier l’en-tête Transfer-Encoding, il peut être possible de contourner cette limitation en insérant un en-tête de transfert encodé malformé plutôt qu’un en-tête valide. Voici quelques exemples :
De nombreuses bibliothèques HTTP tolèrent différentes variantes de l’en-tête Transfer-Encoding et les normalisent afin d’améliorer l’expérience client. En déterminant les variantes de l’en-tête Transfer-Encoding que le serveur dorsal normalise, il peut être possible de faire passer un en-tête Transfer-Encoding malformé par le frontal et de mener une attaque par smuggling CL:TE.
Les exemples ci-dessus illustrent simplement la vulnérabilité. Dans le cadre d’une attaque réelle, une requête dissimulée peut être conçue pour mener des attaques de phishing ou voler les données de la requête d’une victime afin de les envoyer à un serveur contrôlé par un attaquant.
Périmètre et idées reçues
Au cours de cette recherche, Snyk a relevé de nombreux cas où la complexité manifeste des multiples vecteurs d’attaque a donné lieu à des idées reçues au sujet du smuggling de requêtes HTTP. Des chercheurs et des responsables de la maintenance en ont signalé à des responsables de projets open source sans toujours comprendre si les corrections requises relevaient du périmètre de la bibliothèque dont ils avaient la charge ou s’il fallait plutôt les apporter à une dépendance utilisée par cette bibliothèque.
Voici quelques points qui nécessitaient des éclaircissements supplémentaires :
Les mandataires, les équilibreurs de charge et les autres composants pouvant être classés comme frontaux sont les plus touchés par cette vulnérabilité. Toutefois, la réussite d’une attaque par smuggling de requêtes nécessite l’exploitation d’un frontal et d’un serveur dorsal vulnérables.
La responsabilité de la correction incombe autant aux responsables de la maintenance du serveur dorsal qu’à ceux du frontal. On pourrait faire valoir qu’un serveur dorsal devrait normaliser les en-têtes malformés et tolérer davantage les erreurs des utilisateurs, et que le véritable problème réside dans les mandataires qui transmettent ces requêtes sans les normaliser au préalable. Toutefois, compte tenu de la grande diversité de l’écosystème des dépendances et du nombre de bibliothèques pouvant jouer le rôle de serveur dorsal ou frontal, les deux parties devraient idéalement tenter de corriger le problème.
Les intergiciels, les serveurs Web prenant en charge les fonctions de mandataire inverse et les serveurs WSGI/haute performance répondent aux critères d’un serveur dorsal. Ce n’est pas le cas d’un serveur Web qui se contente de traiter les requêtes malformées sans prendre en charge le pipelining.
Les rapports de sécurité signalent souvent des problèmes de smuggling de requêtes HTTP parce que des serveurs répondent à plusieurs requêtes envoyées, et que ces réponses apparaissent comme deux réponses distinctes. À noter que de nombreux serveurs prennent en charge Keep-Alive et le pipelining ; cela ne suffit pas, à lui seul, à constituer une vulnérabilité de smuggling de requêtes HTTP. C’est le cas de la CVE-2020-12440 signalée pour NGINX.
Correction
Les problèmes de désynchronisation des requêtes HTTP sont dus à des écarts par rapport aux spécifications HTTP actuelles et au fait que plusieurs bibliothèques ne respectent pas la RFC 7230. De plus, la correction de cette vulnérabilité peut s’avérer délicate selon que vous maintenez un projet côté frontal ou côté serveur. Snyk a donc étudié les mesures correctives actuellement mises en œuvre par des projets open source et les a classées comme suit. Pour simplifier, chaque mesure est présentée avec une explication du type d’attaque par désynchronisation qu’elle permet de contrer. Dans l’idéal, toutes les mesures ci-dessous devraient être appliquées afin d’assurer une défense en profondeur.
Donner la priorité à Transfer-Encoding plutôt qu’à Content-Length — Mesure corrective :Cette mesure permet de prévenir les attaques CL:TE et TE:CLPérimètre : Front-end, back-endDétails :Lorsqu’une requête contenant à la fois un en-tête Transfer-Encoding: chunked et un en-tête Content-Length est reçue, l’en-tête Transfer-Encoding doit avoir priorité sur Content-Length. Ce comportement est défini dans la section 3.3.3#3 de la RFC 7230.
Rejeter les requêtes contenant à la fois Content-Length et Transfer-Encoding, ainsi que celles avec plusieurs en-têtes Content-Length — Mesure corrective : Cette mesure permet de prévenir les attaques CL:CL, CL:TE et TE:CLPérimètre : Back-end, front-end, back-end, bibliothèques en amontDétails :Cette solution peut être considérée comme une meilleure option que « Donner la priorité à Transfer-Encoding plutôt qu’à Content-Length ». Des environnements d’exécution tels que Node.js ont adopté cette solution pour contrer la désynchronisation des requêtes : toute requête contenant les deux en-têtes reçoit une réponse HTTP 400.
Snyk estime que cette technique constitue une solution idéale pour prévenir les problèmes de désynchronisation. Il convient toutefois de réfléchir à la manière dont la correction est appliquée, en particulier si elle concerne une bibliothèque HTTP de bas niveau ou un moteur en amont dont dépendent de nombreux packages, comme un frontal.
Pour corriger les problèmes de désynchronisation des requêtes HTTP, il convient de suivre la RFC 7230 #3.3.3. La section 3.3.3#3 de la RFC 7230 indique :
« Si un message est reçu avec un champ d’en-tête Transfer-Encoding et un champ d’en-tête Content-Length, Transfer-Encoding prévaut sur Content-Length. Un tel message peut indiquer une tentative de désynchronisation des requêtes (section 9.5) ou de fractionnement des réponses (section 9.4) et doit être traité comme une erreur. Un expéditeur DOIT supprimer le champ Content-Length reçu avant de transférer le message en aval. »
Cela diffère toutefois de ce qu’indique la RFC 2616 4.4#3 :
« Si un message est reçu avec un champ d’en-tête Transfer-Encoding et un champ d’en-tête Content-Length, ce dernier DOIT être ignoré. »
Il convient de noter que la RFC 2616 4.4#3 est obsolète et a été remplacée par la RFC 7230. Il faut tenir compte de la RFC 7230 lors de la mise en œuvre d’une correction. Ainsi, lorsqu’une requête HTTP contient à la fois un en-tête Content-Length et un en-tête Transfer-Encoding, le comportement correct consiste pour le frontal à supprimer l’en-tête Content-Length avant de transmettre la requête à un serveur en aval, et non à renvoyer une réponse HTTP 400. Il faut procéder de la même manière pour les requêtes contenant plusieurs en-têtes Content-Length, comme le précise la RFC 7230#3.3.2.
Comme indiqué dans la section 3.3.2 de la RFC 7230, si une requête HTTP reçue contient plusieurs en-têtes Content-Length avec des valeurs différentes, il est possible de renvoyer une réponse HTTP 400 ou de remplacer les valeurs de champ dupliquées par un seul champ Content-Length valide. Snyk recommande aux bibliothèques HTTP de bas niveau de remplacer les en-têtes multiples par un seul en-tête valide.
Rejeter les en-têtes Transfer-Encoding mal formés et traiter correctement plusieurs valeurs TE — Mesure corrective :Cette mesure permet de prévenir les attaques TE:TE.Périmètre : Front-end, back-endDétails :Si le frontal et le back-end donnent tous deux la priorité à l’en-tête Transfer-Encoding, cela peut permettre des attaques par désynchronisation où un attaquant insère deux en-têtes Transfer-Encoding : l’un est ignoré par le frontal et traité par le back-end, ou inversement. Les variantes d’en-tête suivantes doivent donc être rejetées.
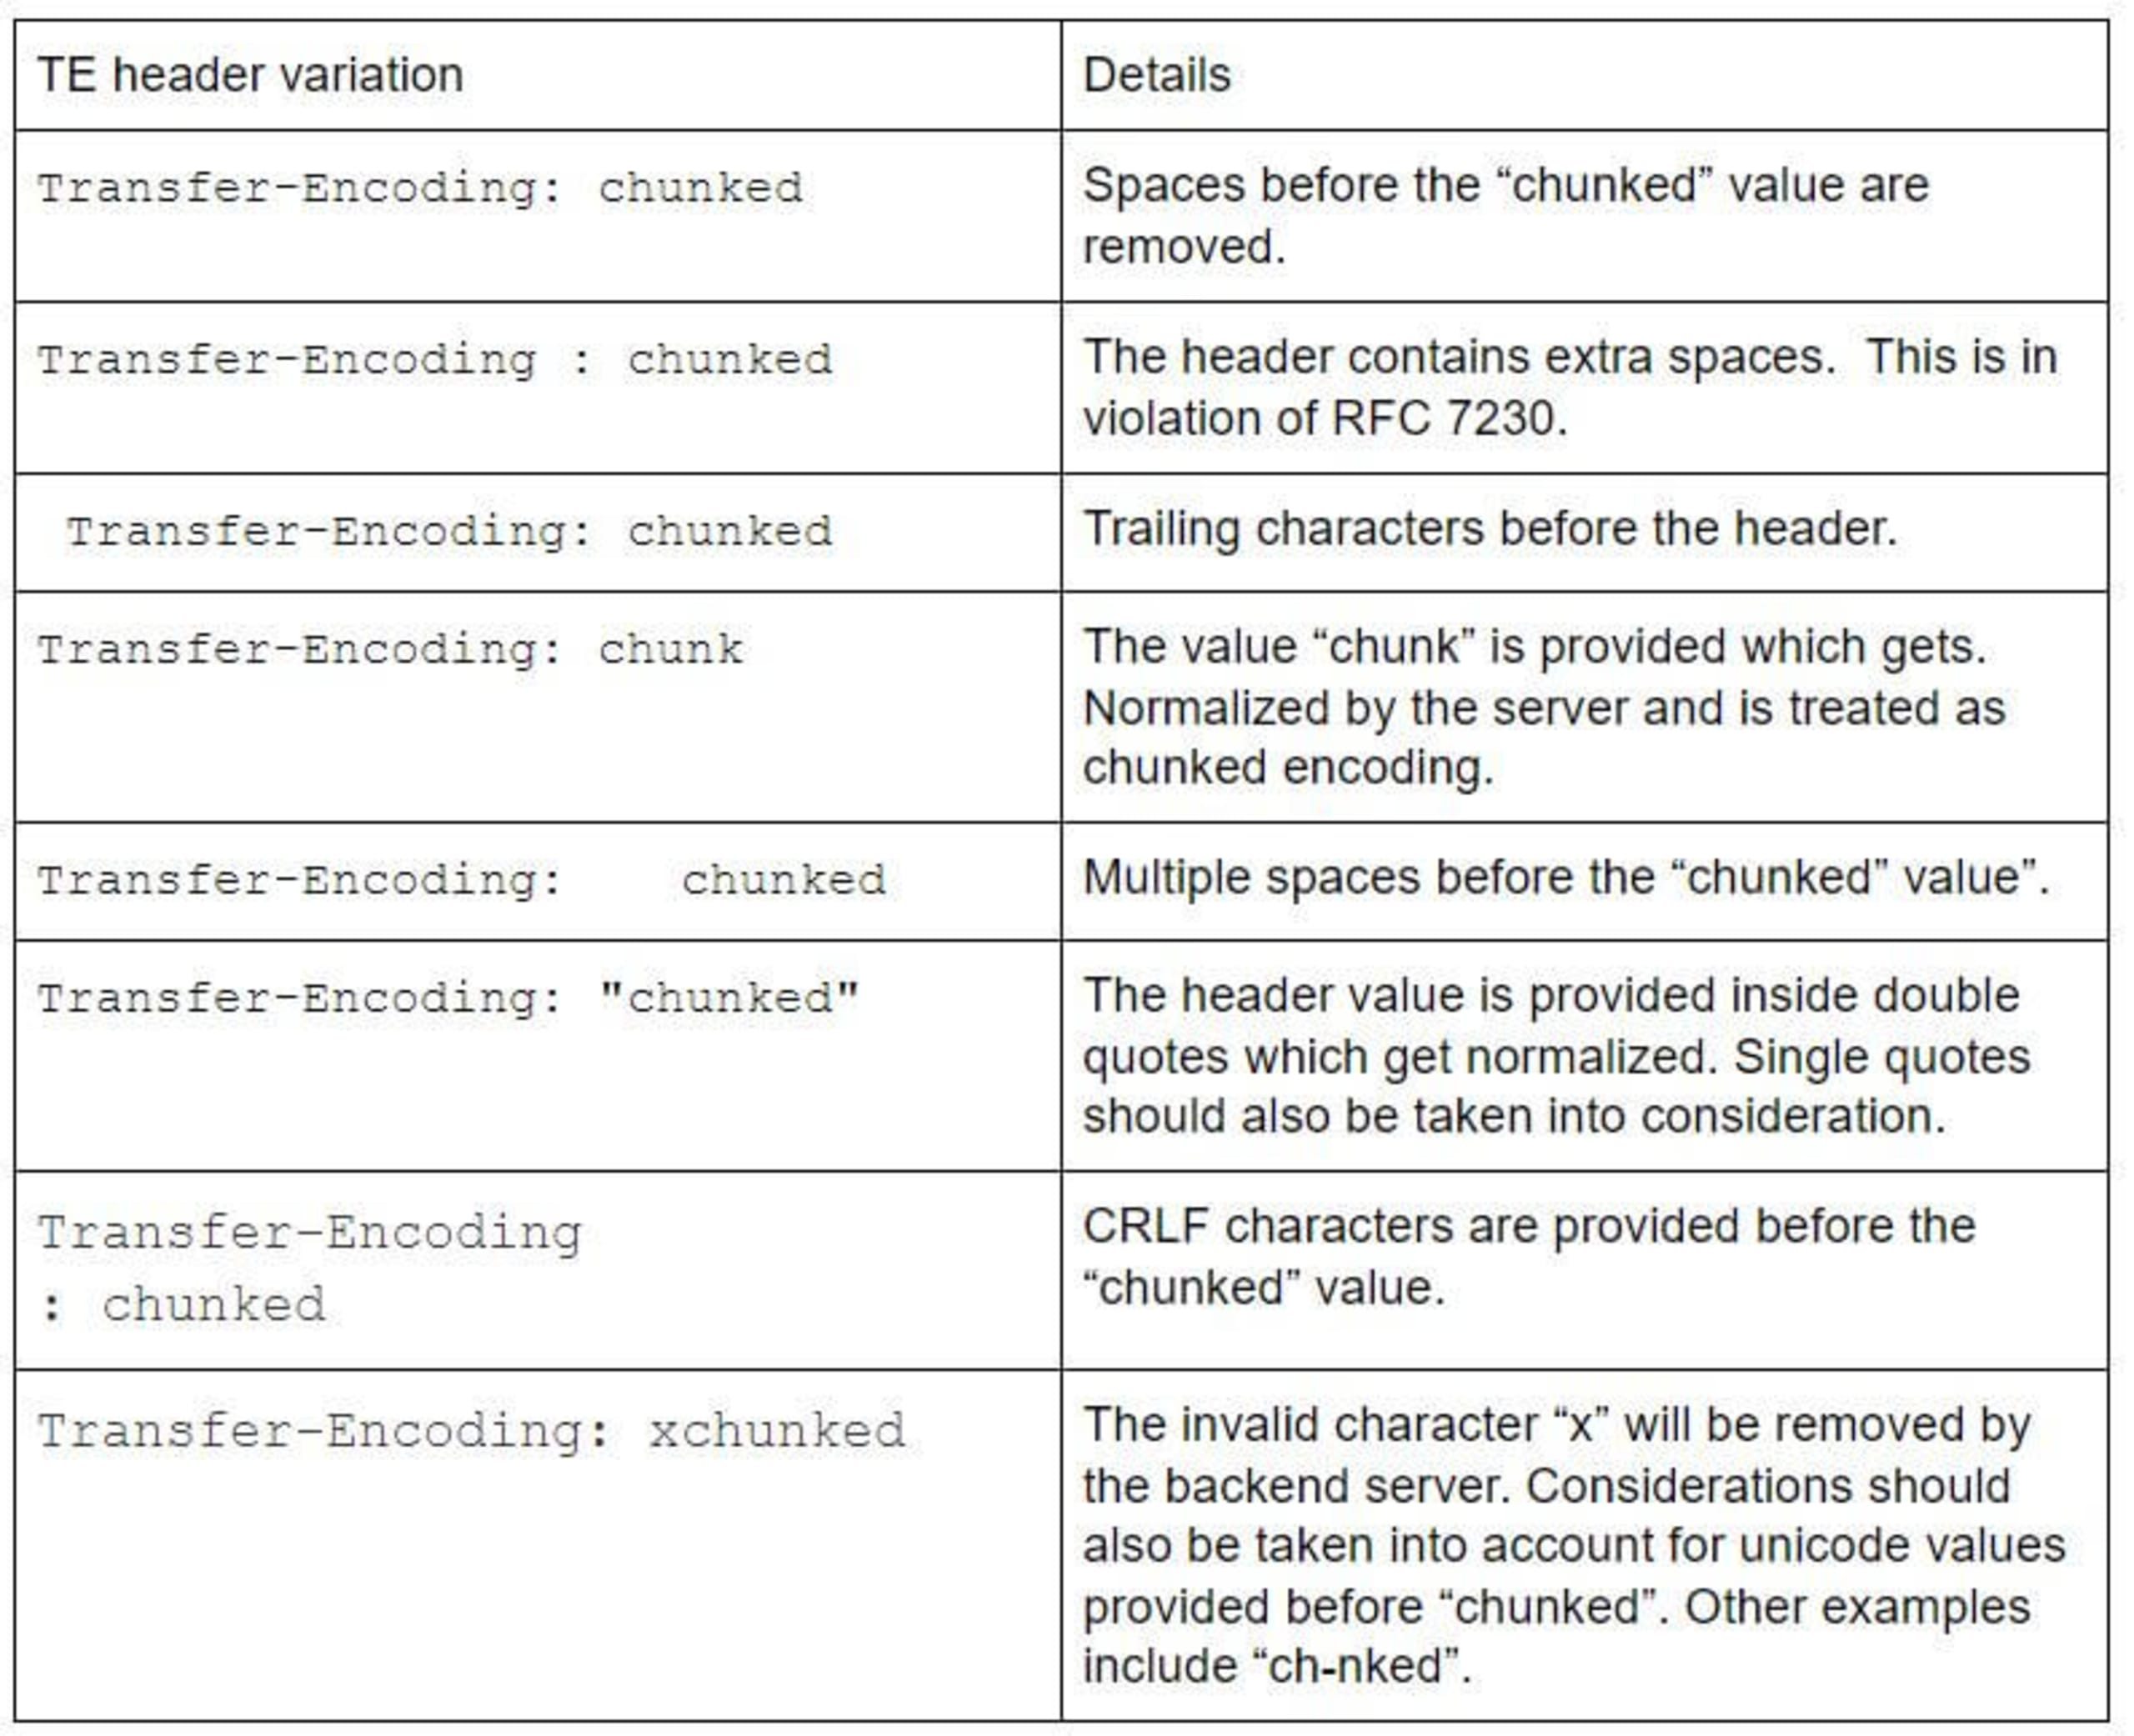
Il convient toutefois de noter que des attaquants peuvent toujours trouver une variante mal formée de l’en-tête utilisant l’encodage « chunked » qui n’est pas documentée ci-dessus. Cette mesure ne suffit donc pas, à elle seule, à corriger la vulnérabilité. Une meilleure approche consiste à rejeter les requêtes contenant à la fois Content-Length et Transfer-Encoding, ainsi que les en-têtes mal formés.
Enfin, il convient également de noter que si la valeur « chunked » est spécifiée avec d’autres valeurs Transfer-Encoding, telles que « gzip » ou « deflate », il ne faut pas la négliger et Transfer-Encoding doit avoir priorité sur Content-Length. La CVE-2019-16786 est un exemple de cette vulnérabilité. Si une requête HTTP est envoyée avec les valeurs Transfer-Encoding suivantes, la valeur « chunked » doit être correctement détectée et priorisée :
Transfer-Encoding: gzip, chunked
Plusieurs valeurs peuvent être indiquées dans un en-tête Transfer-Encoding, séparées par une virgule. Cependant, il peut arriver qu’un frontal ne détecte que la valeur « gzip » et donne ainsi la priorité à l’en-tête Content-Length, tandis que le back-end traite la requête comme une requête chunked, ce qui entraîne une attaque CL:TE. Snyk recommande de vérifier correctement les requêtes comportant plusieurs valeurs et, si « chunked » est spécifié, de donner la priorité à Transfer-Encoding. De plus, lorsque plusieurs en-têtes Transfer-Encoding sont spécifiés, la valeur « chunked » ne doit apparaître qu’en dernier, après les autres valeurs Transfer-Encoding. C’est ce qu’indique la section 3.3.1 de la RFC 7230.
Pour conclure
En conclusion, la désynchronisation des requêtes HTTP est une vulnérabilité qui peut être difficile à comprendre et à corriger. Cet article vise à aider les mainteneurs à écrire des correctifs efficaces et à sécuriser leurs projets open source.
Il convient également de noter que cet article ne présente que deux techniques de désynchronisation des requêtes HTTP et ne détaille pas les différents scénarios d’exploitation. L’article suivant du chercheur en sécurité ZeddYu traite en détail de la désynchronisation HTTP et présente chaque vecteur d’attaque : Zeddy Yu : Vous aider à comprendre la désynchronisation HTTP en un article.
Lancez-vous dans les compétitions Capture The Flag
Apprenez à résoudre des défis Capture The Flag en regardant à la demande notre atelier virtuel d’initiation.


