VulnBump: agentes de IA conseguem corrigir dependências vulneráveis sem quebrar o build?


15 de outubro de 2026
0 minutos de leituraAgentes de IA conseguem corrigir dependências vulneráveis sem quebrar o build? A correção em si raramente é o mistério. Ao longo de seis meses em 2026, o Snyk Open Source registrou 459 milhões de vulnerabilidades em cerca de 300 mil organizações. 94% dessas vulnerabilidades tinham uma versão corrigida conhecida, mas apenas cerca de 10% haviam sido resolvidas.
Isso acontece porque a parte difícil é atualizar com segurança: a maioria dos pacotes vulneráveis é importada de forma transitiva, cerca de um quarto das correções exige uma atualização para uma versão principal e até mesmo versões secundárias e de patch, que deveriam ser compatíveis com versões anteriores, frequentemente incluem mudanças incompatíveis.
VulnBump, uma nova pesquisa publicada pela Snyk, põe agentes de IA à prova em 307 atualizações reais de dependências vulneráveis. Uma atualização só é considerada APROVADA se eliminar as vulnerabilidades e o projeto ainda instalar, compilar e passar nos testes.
O que há de novo: até onde sabemos, o VulnBump é o primeiro benchmark de agentes de IA focado em atualizações motivadas por segurança: cada tarefa começa com vulnerabilidades reais encontradas pela Snyk em um projeto real, em seis gerenciadores de pacotes. Benchmarks anteriores de atualização verificam apenas se algo foi quebrado, não se a vulnerabilidade foi eliminada.
Então, agentes de IA conseguem corrigir dependências vulneráveis sem quebrar o build? Na maioria das vezes, sim, mas o modelo, por si só, não determina o resultado. Usando o mesmo modelo, Claude Sonnet 5.5, o Evo Remediation Agent da Snyk foi aprovado em 90,2% das atualizações. O Claude Code, da Anthropic, foi aprovado em 77,5% quando recebeu a atualização recomendada e a análise da Snyk (Claude Code + análise da Snyk), e em 59,6% sem dados da Snyk (Claude Code sem assistência). A diferença passa de 30 pontos percentuais. Para comparação, a atualização pelo gerenciador de pacotes, uma referência sem IA que apenas aplica a versão recomendada pela Snyk, já foi aprovada em 46,9% dos casos.
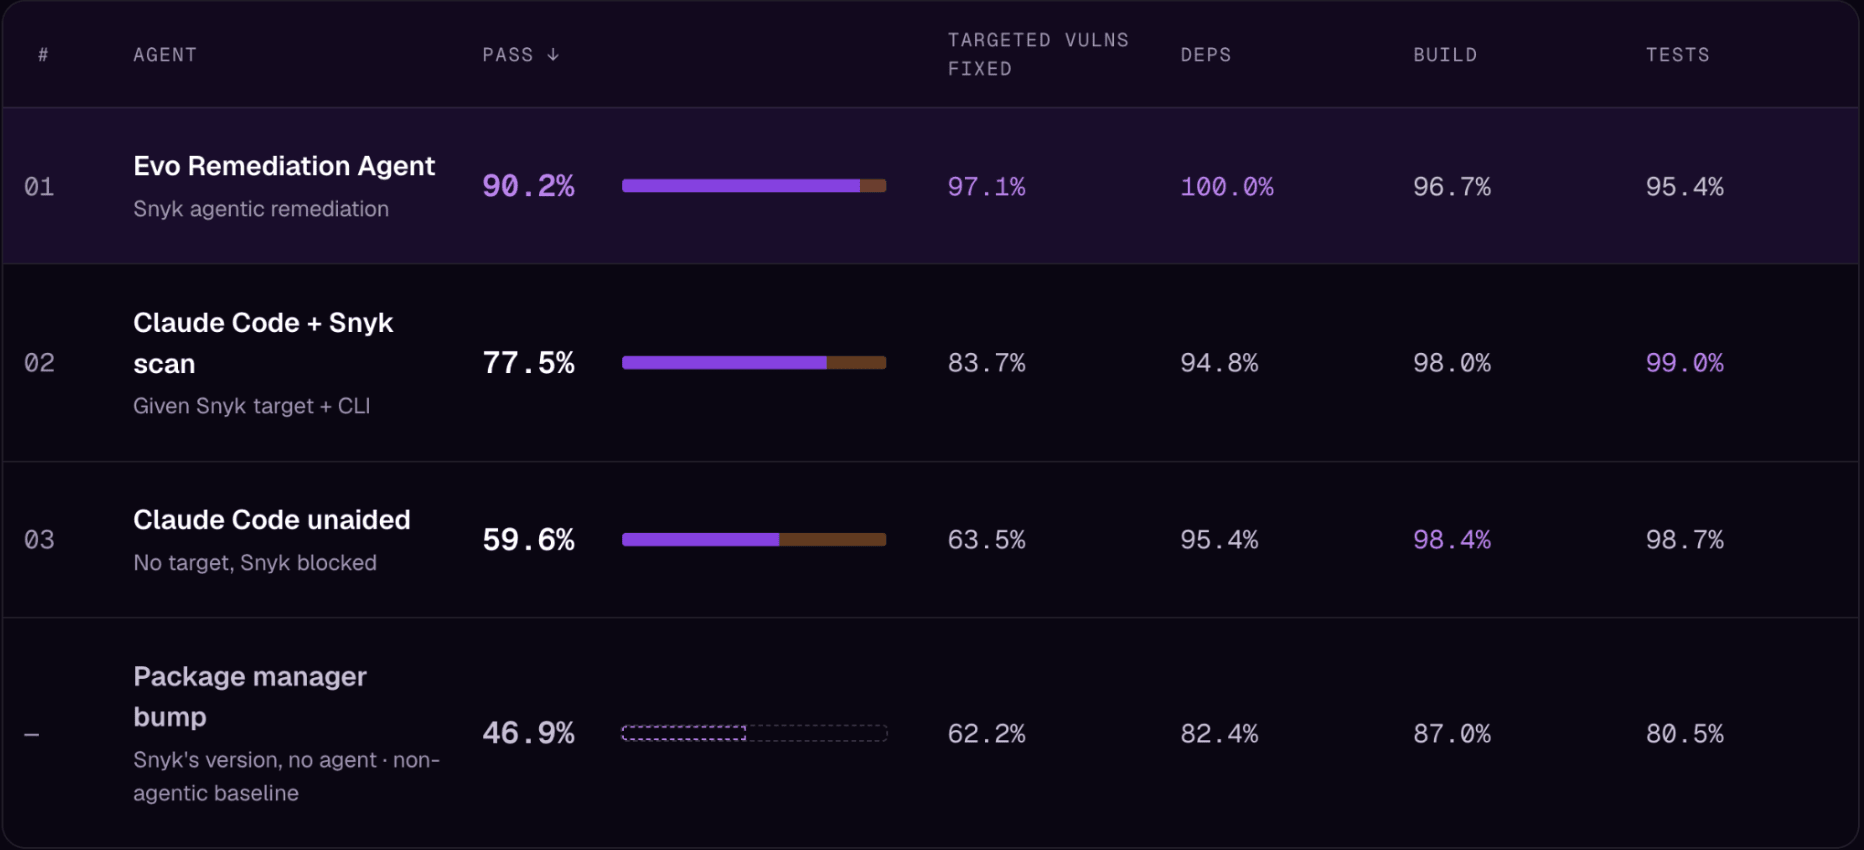
Principais resultados do VulnBump
Manter o build funcionando não foi a parte difícil: os três agentes conseguiram isso em cerca de 93% dos casos. O desafio foi eliminar a vulnerabilidade. Em 70 das 124 falhas, o Claude Code, sem assistência, afirmou ter corrigido vulnerabilidades que continuaram aparecendo em uma nova análise.
Nossos resultados reforçam o que vimos no VulnBench, nosso benchmark de junho sobre análise de segurança por IA: Claude e Snyk Code deixam passar vulnerabilidades diferentes, e os dois funcionam melhor em conjunto. O VulnBump testa outra tarefa — atualizar dependências de código aberto vulneráveis — e aponta na mesma direção: com a versão recomendada e a análise da Snyk, a taxa de aprovação do Claude Code subiu 17,9 pontos. O Evo Remediation Agent mostra até onde um agente desenvolvido para essa finalidade pode chegar: 12,7 pontos acima do Claude Code com a mesma análise da Snyk. O VulnBump também dá continuidade a os resultados de correção que compartilhamos em maio, agora com um modelo mais recente e seis gerenciadores de pacotes.
Como criamos o VulnBump
Partimos de projetos reais, alinhados à produção. Reunimos 767 projetos candidatos do GitHub, incluindo projetos populares de código aberto e repositórios que fixam versões de pacotes sabidamente vulneráveis. Antes de qualquer alteração, cada projeto precisava instalar, compilar e passar em mais de 85% dos testes, e a Snyk precisava encontrar pelo menos uma vulnerabilidade. Dos 99 projetos que atenderam aos critérios, escolhemos 43 que refletem os dados de produção da Snyk em relação ao ecossistema, à gravidade das vulnerabilidades, às dependências diretas versus transitivas e ao tamanho do salto de versão.

Comparação do conjunto de dados do VulnBump com os dados de produção do Snyk Open Source
Transformamos cada atualização recomendada em uma tarefa. Cada tarefa pede ao agente que aplique uma atualização recomendada pela Snyk: um pacote, atualizado para uma versão que corrige suas vulnerabilidades. Cada tarefa começa com uma cópia nova do projeto e é avaliada separadamente. Os 43 repositórios geram 307 tarefas que abrangem 2.066 vulnerabilidades corrigíveis, em Maven, Gradle, npm, Yarn, pip e Poetry — os seis gerenciadores de pacotes responsáveis por cerca de 92% das ocorrências em produção.
Adicionamos um verificador que não confiava no agente. Quando o agente terminava, copiávamos suas alterações para um contêiner limpo e verificávamos tudo do zero. Nessa etapa, uma tentativa só era considerada APROVADA se passasse pelos quatro critérios:
As dependências são instaladas com o comando que o CI executaria.
Uma nova análise da Snyk confirma que as vulnerabilidades foram eliminadas.
O projeto compila.
Todos os testes que passavam antes continuam passando.

O pipeline do VulnBump
Os ambientes de teste avaliados. Os três agentes usaram o Claude Sonnet 5.5, com limite de 110 turnos por atualização e o mesmo contêiner para cada linguagem:
Evo Remediation Agent é o mecanismo de correção agentiva da Snyk. Ele usa a inteligência da Snyk e pode executar suas próprias análises, compilações e testes, além de corrigir erros antes de concluir. Usamos o modo de aprovação automática, então ele aplicou todas as correções, incluindo atualizações que a Snyk considera propensas a quebrar o build.
Claude Code com análise da Snyk é o agente de programação de uso geral da Anthropic, que recebeu a recomendação de atualização da Snyk: o pacote a atualizar, a versão de destino e as vulnerabilidades corrigidas. Ele também pode executar uma análise do Snyk Open Source para verificar o próprio trabalho.
Claude Code sem assistência recebe a mesma tarefa, mas sem a versão de destino nem acesso à Snyk. Ele precisa determinar sozinho qual versão corrige as vulnerabilidades, por exemplo, pesquisando em bancos de dados de vulnerabilidades na web.
A atualização pelo gerenciador de pacotes é a referência sem agente: aplica a versão recomendada pela Snyk com o próprio gerenciador de pacotes do projeto e não altera mais nada.
Como os repositórios foram escolhidos, os prompts exatos e as ferramentas disponíveis para cada agente, além dos controles contra vazamento de dados, estão descritos no artigo de pesquisa: VulnBump: um benchmark para corrigir dependências vulneráveis em projetos reais sem deixar de manter o build e os testes funcionando, junto com as limitações: testamos um único modelo, executamos cada atualização uma vez e usamos o Snyk Open Source como avaliador. Isso só pode prejudicar o Claude Code sem assistência, já que os outros dois agentes trabalham com os mesmos resultados da Snyk. Também não penalizamos novas vulnerabilidades introduzidas pela atualização.
Resultado 1: o mesmo modelo, três resultados diferentes
O Evo Remediation Agent passou por todos os critérios em 90,2% das atualizações (e corrigiu 95,9% das 2.066 ocorrências de vulnerabilidade). Isso representa 12,7 pontos a mais que o Claude Code + análise da Snyk — aproximadamente uma correção funcional a mais a cada oito atualizações — e 30,6 pontos a mais que o Claude Code sem assistência.
E a classificação não depende apenas de alguns repositórios grandes: calculadas como média por repositório, as taxas de aprovação foram de 93,1% para o Evo Remediation Agent, 80,1% para o Claude Code + análise da Snyk, 68,0% para o Claude Code sem assistência e 51,3% para a atualização pelo gerenciador de pacotes.
Principal descoberta:
O Evo Remediation Agent resolve de ponta a ponta 9 em cada 10 atualizações motivadas por vulnerabilidades.
Resultado 2: os agentes precisam saber qual versão é realmente segura
Com o mesmo modelo, fornecer ao Claude Code a análise e a atualização recomendada pela Snyk aumentou sua taxa de aprovação em 17,9 pontos, de 59,6% para 77,5%.
A diferença mais clara está na versão escolhida. Sem assistência, o Claude Code escolheu uma versão que a Snyk ainda sinaliza em 64 casos. Com a análise da Snyk, esse número caiu para 13. Nem sempre os bancos de dados de vulnerabilidades concordam sobre qual versão corrige uma vulnerabilidade. Por isso, uma versão que parece segura em uma fonte ainda pode ser sinalizada por outra.
As orientações da Snyk são mais importantes para vulnerabilidades transitivas, em pacotes que o projeto não declara diretamente. Considerando apenas as atualizações aprovadas em todos os critérios, elas mais que dobraram a proporção corrigida pelo Claude Code, de 28% para 59%.
Principal descoberta:
A verificação e a versão-alvo do Snyk aumentaram em 17,9 pontos a taxa de aprovação do Claude Code e mais que dobraram o número de vulnerabilidades transitivas corrigidas.
Resultado 3: as recomendações da Snyk resolvem cerca de metade dos casos, e depois os agentes se diferenciam
A atualização pelo gerenciador de pacotes divide as 307 atualizações em duas partes: nas 144 aprovadas, basta aplicar a versão recomendada pela Snyk, e um agente só pode manter ou perder uma correção simples. As outras 163 exigem mais do que uma atualização de versão, como adaptar o código a mudanças incompatíveis ou resolver conflitos entre dependências.

Agentes nas 144 atualizações resolvidas pela recomendação da Snyk e nas outras 163
Com as orientações da Snyk, os agentes raramente desfazem o que a atualização simples resolve. Já o Claude Code sem assistência regrediu em 20 das 144 atualizações — em 15 delas, por escolher uma versão que a Snyk ainda sinaliza. A diferença real fica evidente na metade mais difícil: entre as outras 163 atualizações, o Evo Remediation Agent foi aprovado em 82,2%, o Claude Code + análise da Snyk em 61,3%, e o Claude Code sozinho em 36,2%.
Principal descoberta:
Das 163 atualizações que exigem mais do que apenas mudar a versão, o Evo Remediation Agent teve uma taxa de sucesso de 82,2%, contra 61,3% do Claude Code + Snyk scan e 36,2% do Claude Code sem auxílio.
Resultado 4: um build funcionando pode esconder uma vulnerabilidade não corrigida
A maneira mais fácil de manter o build funcionando é deixar a vulnerabilidade como está — e foi principalmente aí que vimos o Claude Code falhar. A nova análise foi o primeiro critério a falhar em 107 das 124 falhas do Claude Code sem assistência, em 48 das 69 falhas do Claude Code + análise da Snyk e em 9 das 30 falhas do Evo Remediation Agent.
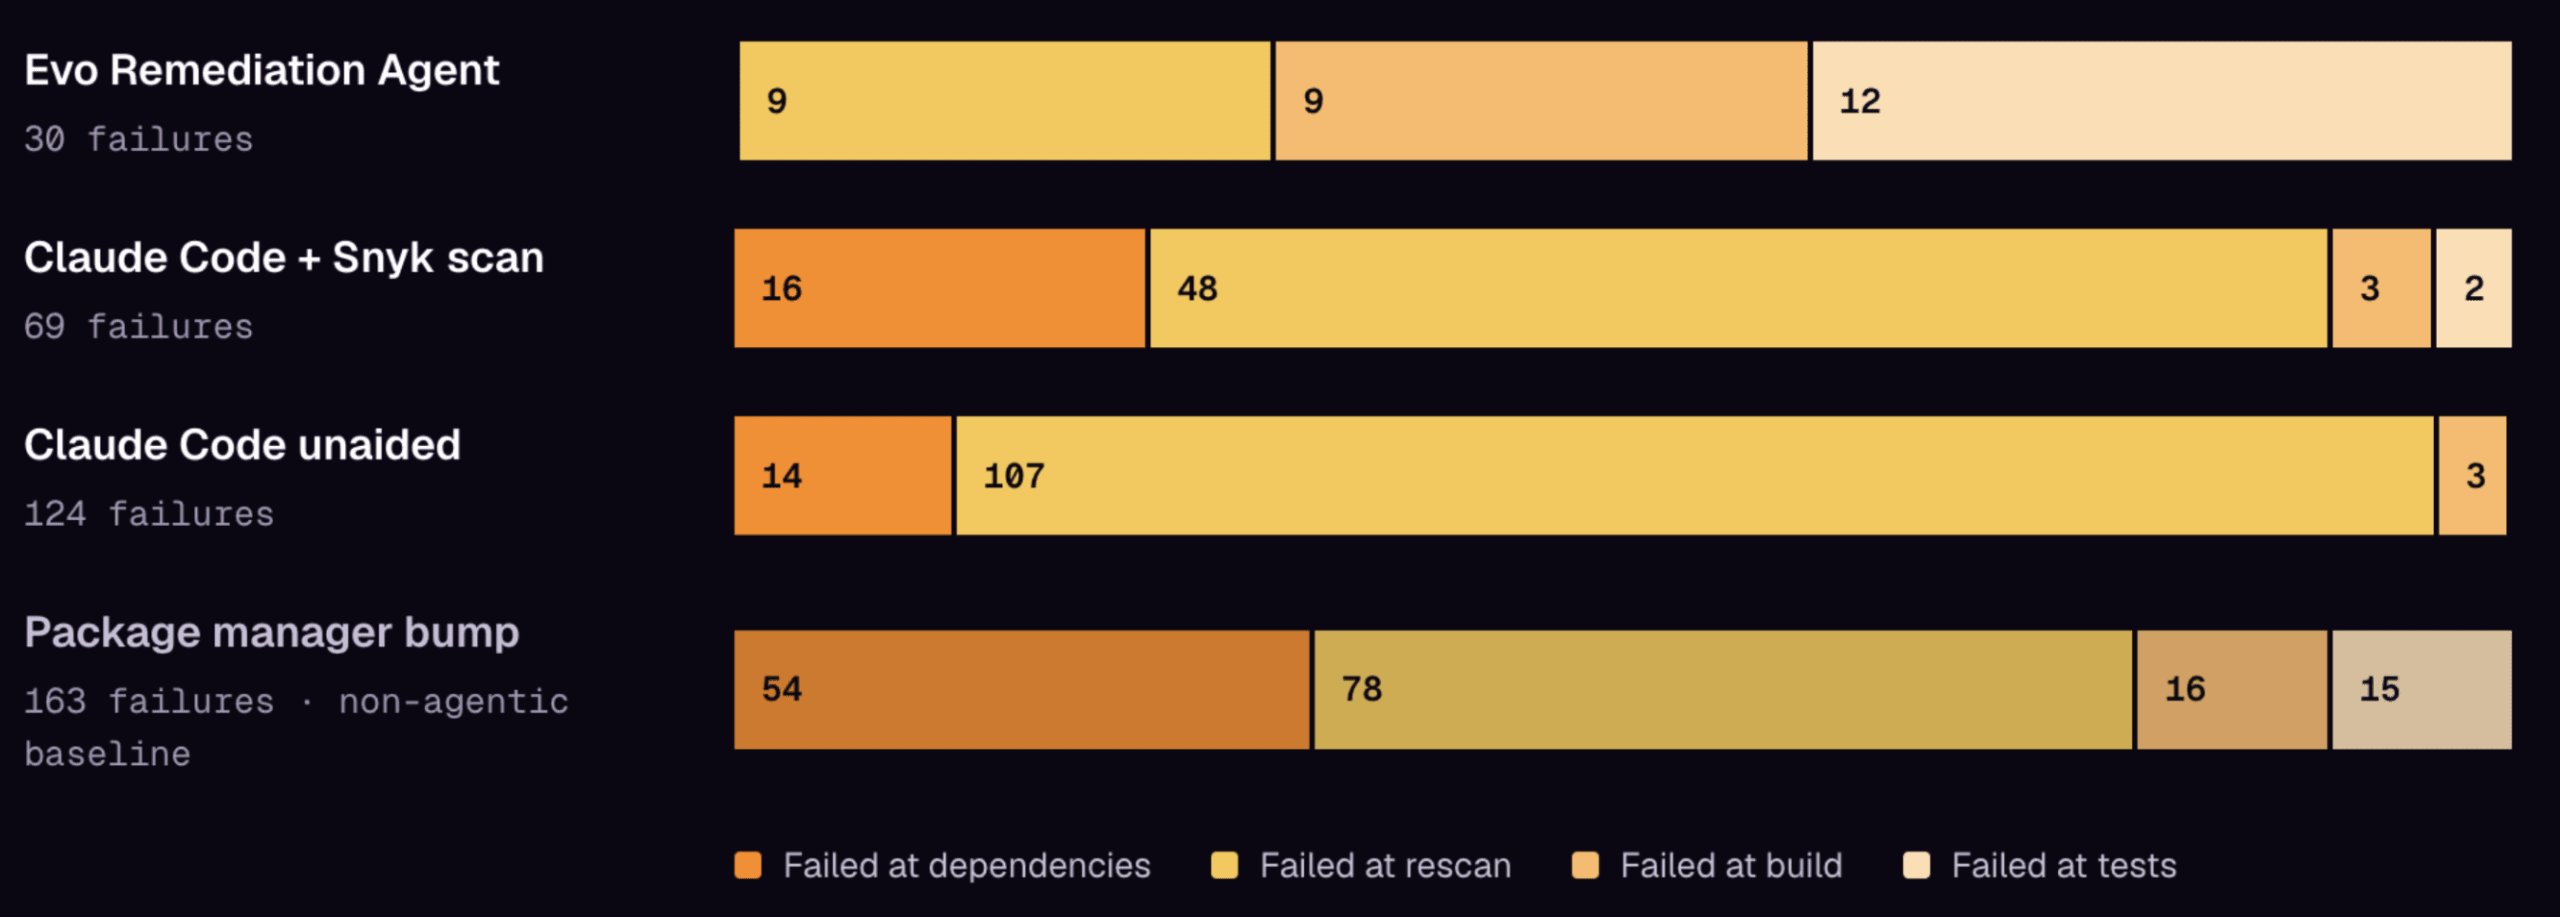
Primeiro critério de verificação não atendido em cada tentativa com falha
As falhas do Evo Remediation Agent ficam visíveis (e isso é bom). 21 das 30 falhas ocorreram porque o build ou os testes foram interrompidos, principalmente em atualizações para versões principais que os outros agentes muitas vezes evitaram. Uma falha explícita é muito mais segura do que uma silenciosa: quando uma atualização dá errado, o próprio build e os testes do projeto mostram o problema, onde um desenvolvedor pode vê-lo e, por fim, tomar providências.
Principal descoberta:
Agentes de uso geral falham sem avisar; o Evo Remediation Agent detecta a falha onde a CI a identifica.
Resultado 5: saber a versão de destino não é suficiente
A análise da Snyk ajuda bastante o Claude Code, mas acertar a atualização exige mais do que isso: com as mesmas descobertas e versões de destino, o Evo Remediation Agent foi aprovado em 39 atualizações a mais que o Claude Code com análise da Snyk, 23 delas com salto para uma versão principal.
O Evo Remediation Agent combina a inteligência da Snyk com um ciclo em que compila, testa e corrige o projeto antes de concluir. Embora nossa configuração não permita isolar qual componente faz a diferença, ela mostra o quanto o sistema ao redor de um modelo pode afetar o resultado, em linha com o DepBench, no qual mudar apenas o ambiente de execução alterou os resultados em até 16,3 pontos.
Principal conclusão:
Mesmo modelo, mesmas descobertas do Snyk: o Evo Remediation Agent ainda tem uma pontuação 12,7 pontos maior.
Resultado 6: grandes saltos de versão e dependências transitivas continuam sendo os desafios mais difíceis
Todos os agentes ainda têm dificuldades com migrações de frameworks para versões principais: 23 atualizações, em sua maioria migrações de Spring, Spring Boot e Dropwizard, derrotaram os três agentes.
Nas atualizações para versões principais, as taxas de aprovação caíram de 96% para 81% no Evo Remediation Agent, de 88% para 61% no Claude Code + análise da Snyk e de 70% para 42% no Claude Code sem assistência, em comparação com atualizações que não envolvem versões principais. Também é nas atualizações principais que o código precisa mudar: cerca de metade das aprovações do Evo Remediation Agent nesse grupo incluíram alterações no código-fonte da aplicação, contra 5% nas aprovações de atualizações que não eram principais.
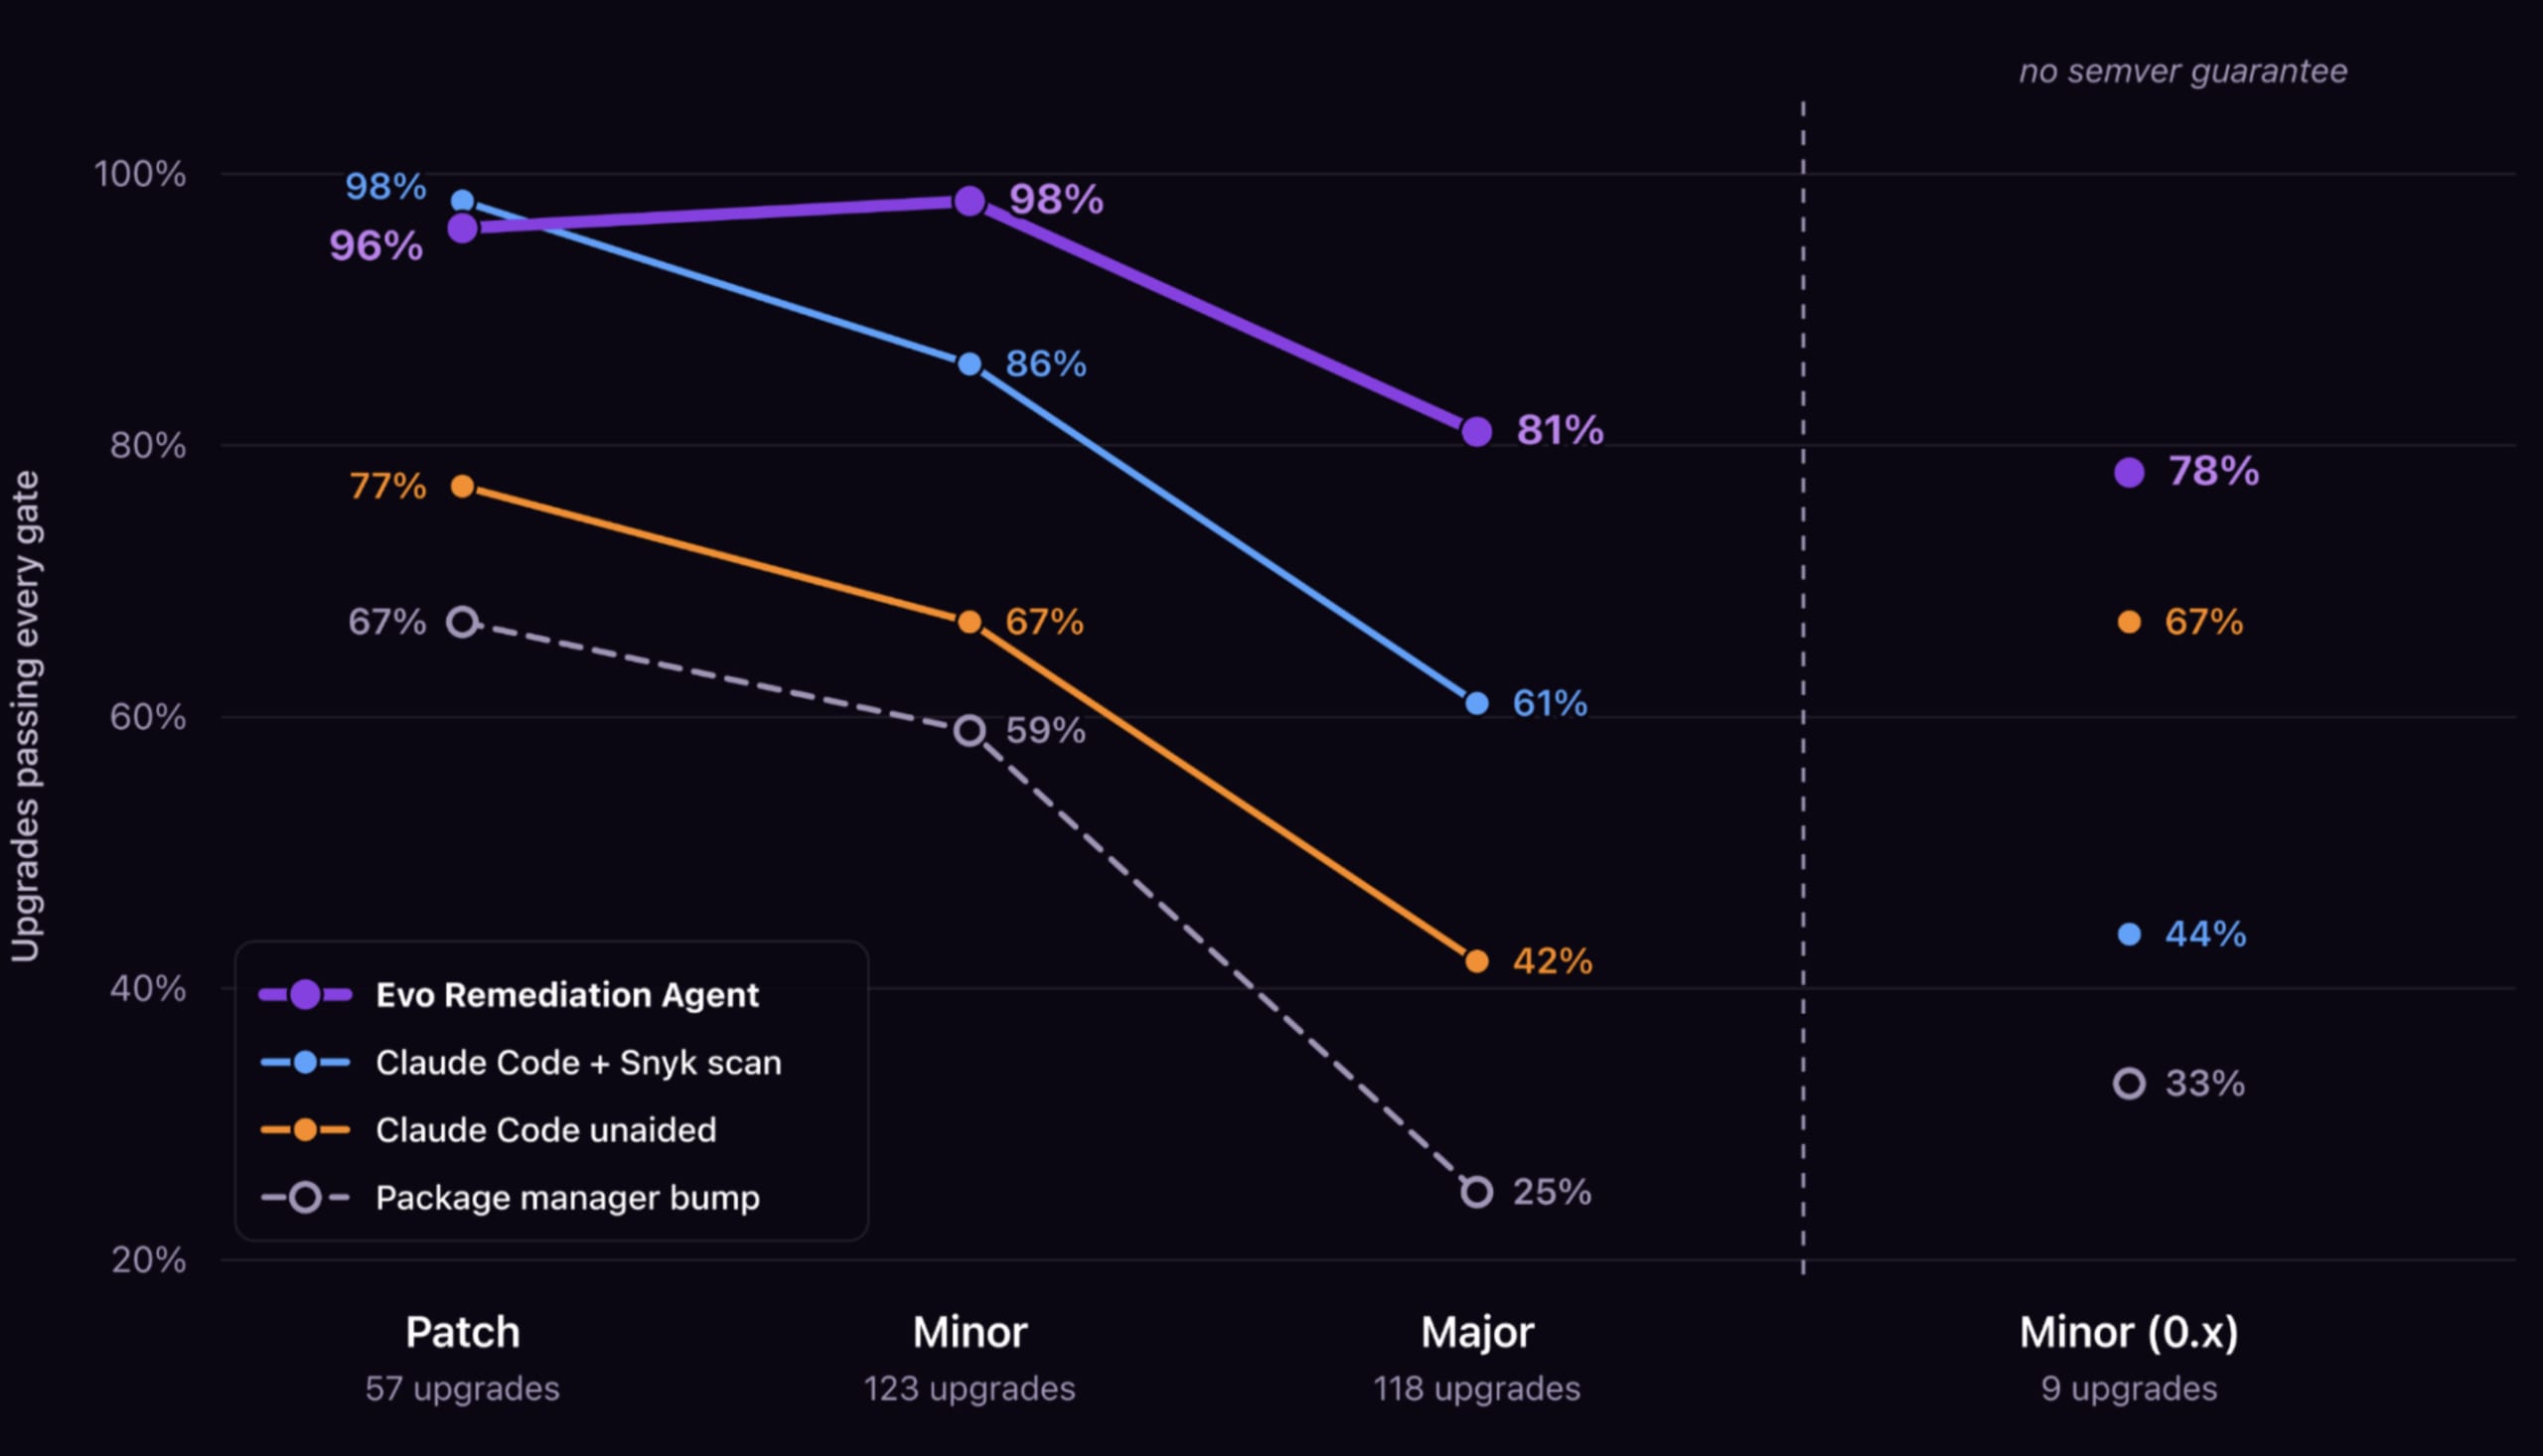
Atualizações aprovadas em todos os critérios, por tamanho do salto de versão
Vulnerabilidades transitivas, em que o pacote vulnerável não está declarado no manifesto, representam 70% das ocorrências corrigíveis e são mais difíceis para todos os ambientes de execução testados. Considerando apenas correções de tentativas aprovadas em todos os critérios, o Evo Remediation Agent corrigiu 73% das ocorrências transitivas, o Claude Code + análise da Snyk, 59%, e o Claude Code sem assistência, 28%. Para ocorrências diretas, os índices foram, respectivamente, 91%, 71% e 62%.
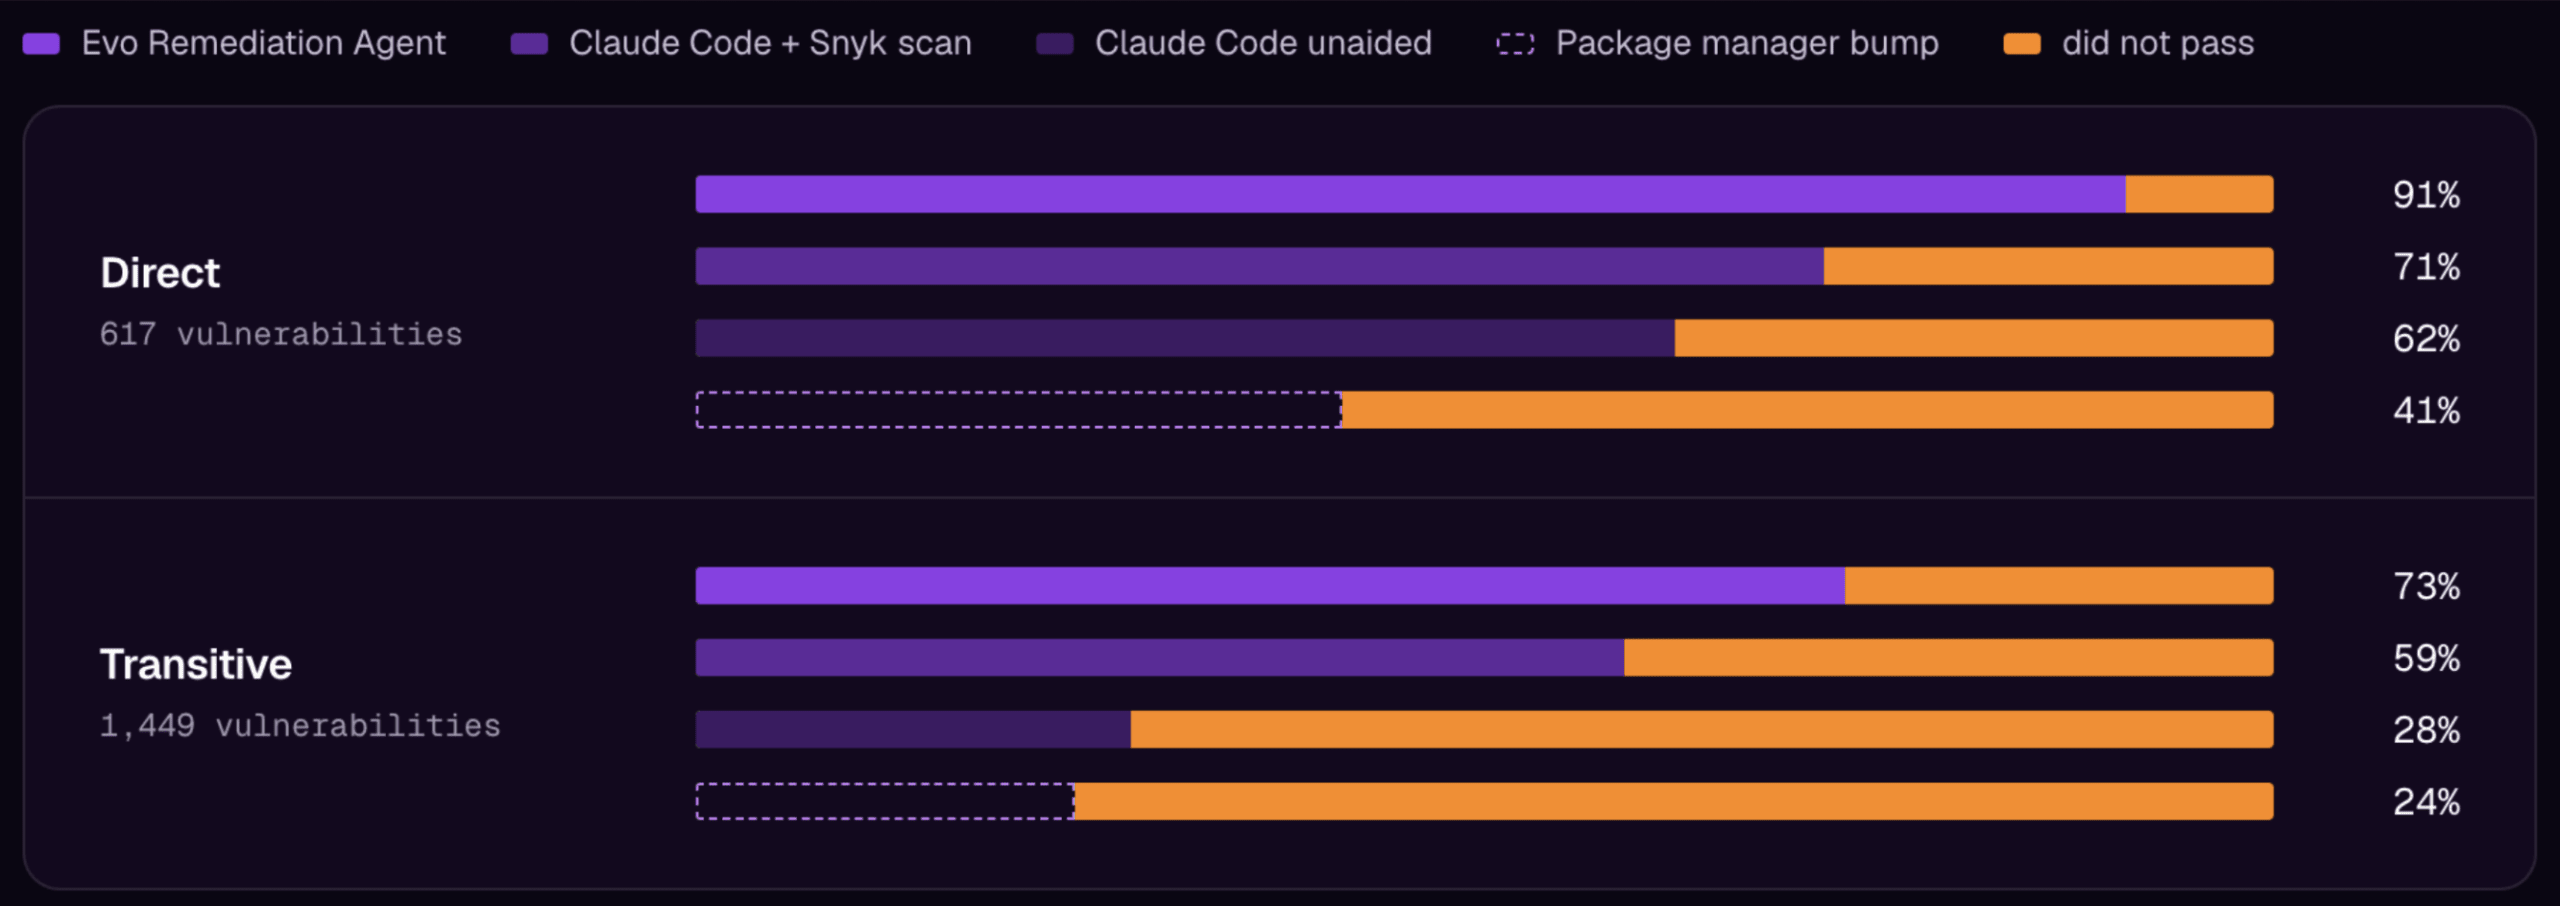
Taxa de aprovação por tipo de dependência (direta ou transitiva)
Principal descoberta:
O Evo Remediation Agent se destaca nas atualizações mais difíceis, nas versões principais e nas dependências transitivas, mas migrações importantes de frameworks ainda superam qualquer agente.
Como o VulnBump se relaciona com o VulnBench?
VulnBench avalia como agentes de programação com IA encontram vulnerabilidades no código que você escreve: com que consistência detectam os mesmos problemas em execuções repetidas e o quanto suas descobertas se aproximam de uma referência determinística de SAST. VulnBump avalia se eles conseguem corrigir vulnerabilidades no código de que você depende: atualizando dependências vulneráveis de código aberto sem quebrar o build ou os testes.
Quando você analisa os dois em conjunto, eles apontam na mesma direção: os modelos oferecem uma capacidade de raciocínio que as ferramentas determinísticas simplesmente não têm. Sozinhos, eles apresentam resultados diferentes entre execuções e muitas vezes não chegam a corrigir o problema. Em toda a plataforma, resumimos a lição compartilhada de forma simples: quem gera não pode validar.
O que isso significa para equipes que delegam tarefas de segurança a agentes?
Avalie uma correção pelas evidências que o agente não produziu: o relato do agente sobre a própria correção é uma afirmação; uma nova análise, uma compilação e uma execução de testes são evidências. Se um agente está corrigindo seu backlog, exija que ele passe pelas mesmas verificações.
Avalie a vulnerabilidade e o build em conjunto: Avaliar apenas um deles oculta falhas. Verificar somente se houve quebra não detecta correções que nunca foram feitas, enquanto verificar somente a vulnerabilidade não percebe quando a correção quebra o projeto.
Forneça os dados de segurança ao agente: A análise do Snyk e a atualização recomendada renderam 17,9 pontos a mais para um agente de uso geral, usando o mesmo modelo.
O Evo Remediation Agent é o mecanismo de correção agentiva do Snyk, disponível pela CLI do Snyk e como serviço na nuvem. Ele é um dos agentes do Evo Agentic AppSec, lançado hoje.
Teste seu agente com o VulnBump
O harness do VulnBump e os 43 casos de avaliação são de código aberto em github.com/snyk-labs/snyk-vulnbump.
A metodologia completa, a análise de falhas e as limitações estão no artigo de pesquisa. Se você estiver desenvolvendo seu próprio agente de correção, teste-o com o VulnBump e conte para a gente o que descobrir.
VulnBump foi desenvolvido por Gabija Pasiunaite, Ryan McMorrow, Brian Clark, Liran Tal e Luke Tu.
PESQUISA