Quando “privado” não é: o risco de segurança de conversas com GPT aparecerem nos mecanismos de busca

1 de agosto de 2025
0 minutos de leitura“Eu nunca quis tornar essa conversa pública — como ela foi parar no Google?”
No fim de julho de 2025, usuários descobriram que conversas do ChatGPT compartilhadas inicialmente por link estavam aparecendo nos resultados de mecanismos de busca como Google, Bing e DuckDuckGo. Essas conversas compartilhadas incluíam conteúdo pessoal relacionado à saúde mental, preocupações profissionais, questões jurídicas e muito mais, sem qualquer indício de violação de dados. A exposição foi causada, na verdade, por um recurso já desativado que permitia que as conversas fossem encontradas por meio da indexação em mecanismos de busca.

Dica rápida
Você pode excluir esses links compartilhados da sua conta a qualquer momento. Acesse as configurações do ChatGPT e vá até “Controles de dados”. Clique no botão “Gerenciar”, à direita da opção “Links compartilhados”. Você verá quantas conversas compartilhou publicamente e poderá excluir esses links.
Como funcionam o armazenamento de conversas com LLMs e as expectativas de privacidade
A maioria dos usuários presume que as interações com LLMs são privadas por padrão. Isso vale para sessões comuns, mas muitas plataformas incluem recursos que permitem compartilhar conversas por meio de URLs públicas.
Links compartilhados do ChatGPT: O aplicativo lançou a opção “Tornar esta conversa localizável” para quem compartilhava conversas. Foi um experimento de curta duração. Embora as conversas fossem anonimizadas, elas eram indexadas por padrão quando os usuários ativavam a opção de descoberta.


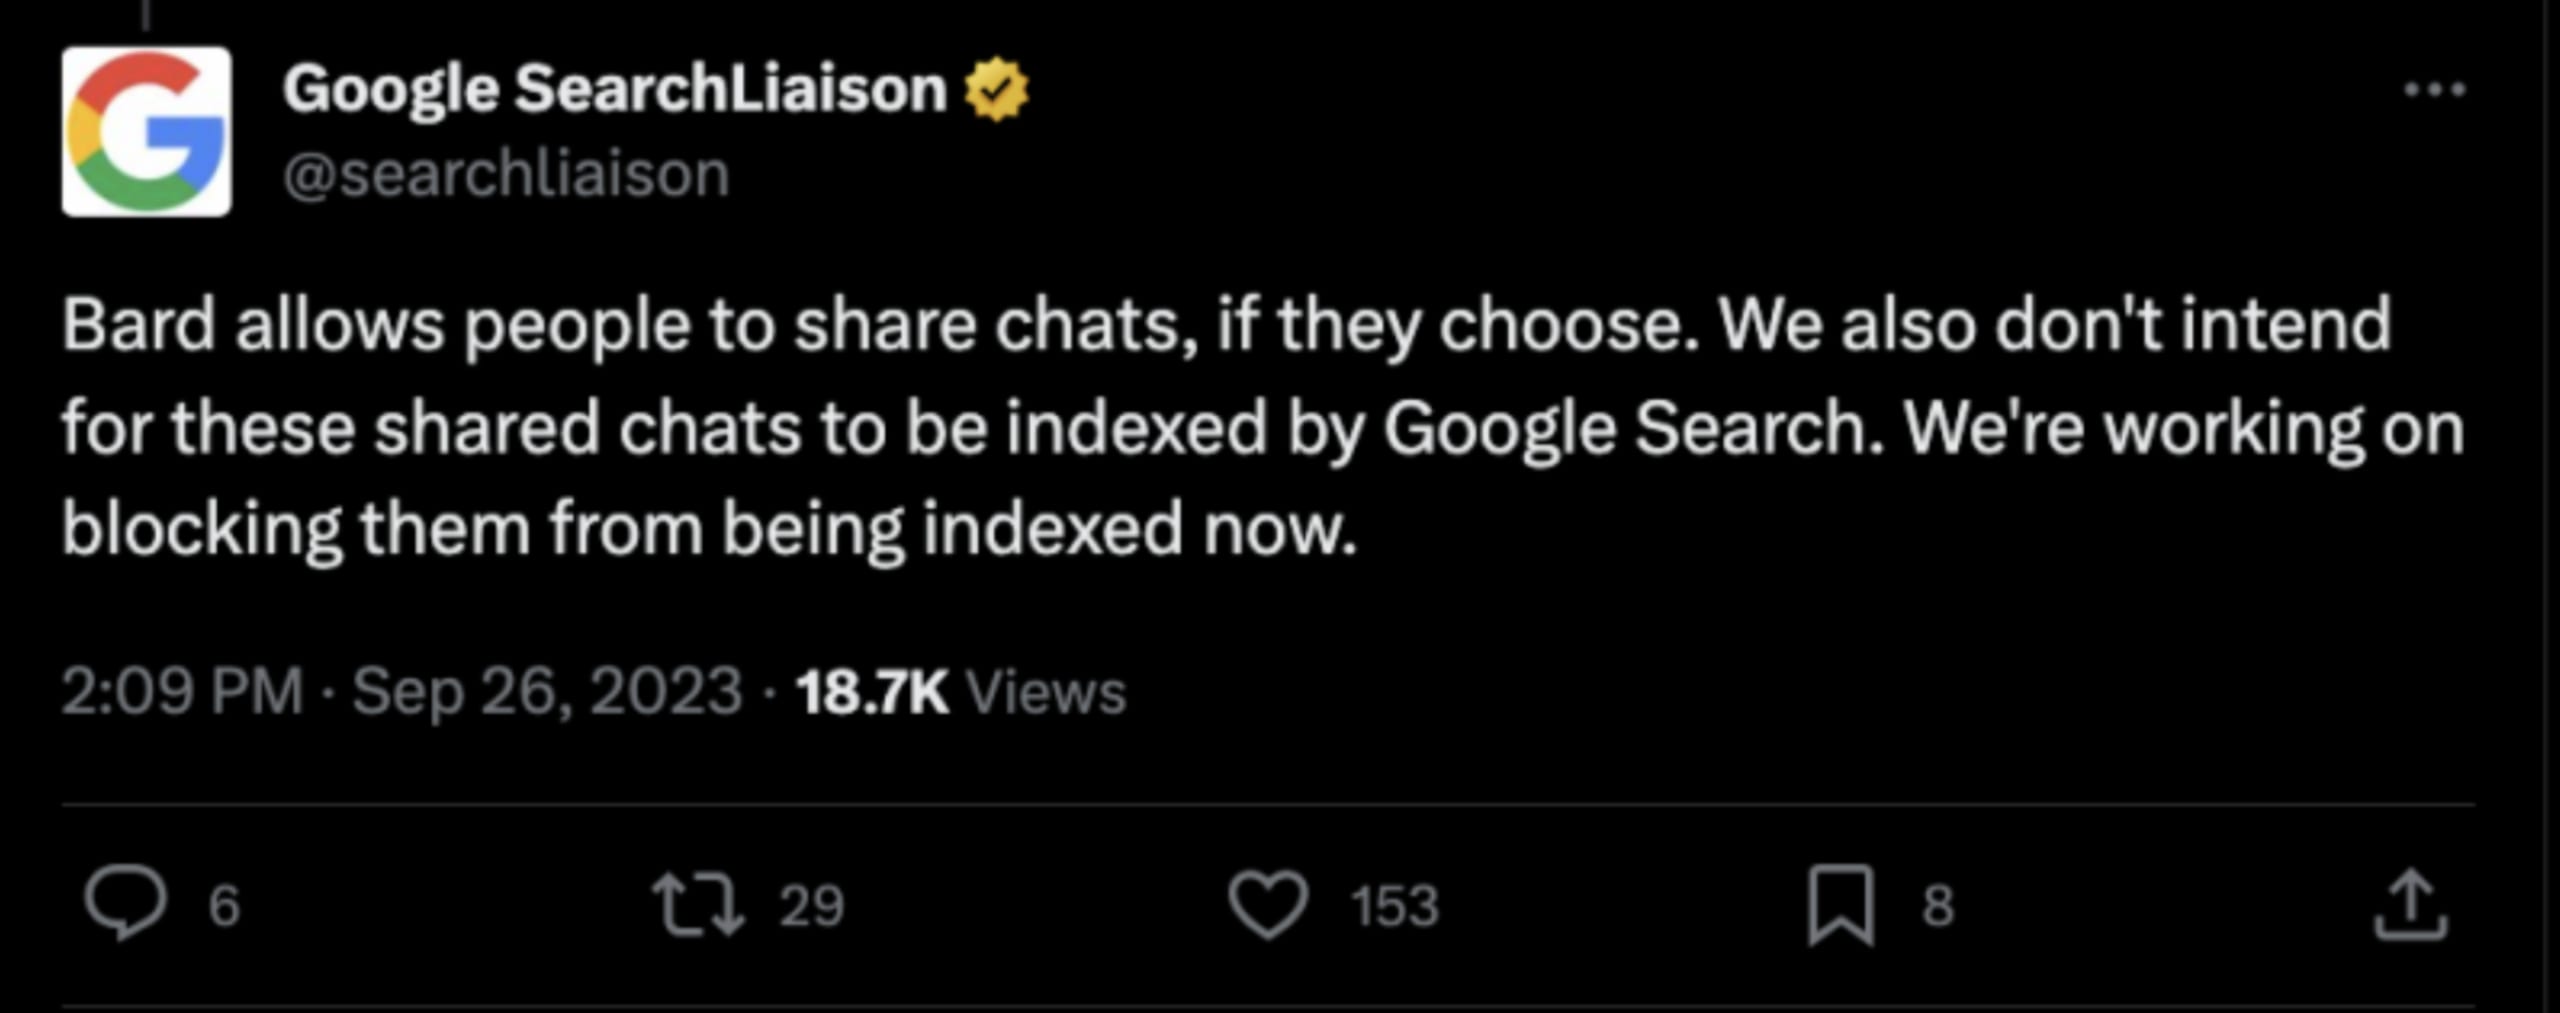
Antecedentes do Google Bard: Incidentes semelhantes foram relatados entre 2023 e 2024, quando links de conversas do Bard não tinham as tags noindex/noarchive ou as exclusões do robots.txt adequadas, o que levou à indexação pública. Desde então, o Google corrigiu o problema e removeu as transcrições indexadas, mas não antes que cópias fossem armazenadas em cache.

O que aconteceu: os incidentes de indexação
OpenAI / ChatGPT (julho a agosto de 2025)
Em uma implementação experimental, a OpenAI permitiu que os usuários marcassem conversas compartilhadas como “localizáveis”.
O recurso, criado para incentivar o compartilhamento de conhecimento entre a comunidade, tornou essas conversas visíveis para mecanismos de busca. Muitas continham perguntas pessoais, políticas e sensíveis.
O recurso de descoberta foi retirado rapidamente após receber muitas críticas relacionadas à privacidade. A OpenAI também trabalhou com mecanismos de busca para remover da indexação as conversas que já tinham sido indexadas.

Análise de riscos: consequências para a segurança e a privacidade
Esses incidentes não são “vazamentos” no sentido tradicional. Não houve comprometimento externo. Ainda assim, as implicações para a segurança são significativas:
Exposição acidental: as conversas indexadas continham dados pessoais sensíveis.
Persistência dos dados: mesmo após a remoção, cópias em cache ou coletadas por scrapers muitas vezes podem manter o conteúdo indefinidamente.
Confiança mal depositada: as expectativas de privacidade padrão (“privado por padrão”) foram frustradas por um recurso de descoberta opcional, sem que os usuários fossem informados adequadamente.
Falhas no consentimento da interface: a opção de descoberta não apresentava avisos claros sobre os riscos e não oferecia controle granular nem uma confirmação explícita.
Estratégias de mitigação
Responsabilidades das plataformas
Desativar por padrão a descoberta por mecanismos de busca
Usar rótulos claros na interface, com avisos e confirmação de consentimento ao ativar o compartilhamento público
Aplicar automaticamente os cabeçalhos noindex e nofollow, a menos que a descoberta seja ativada explicitamente
Definir uma expiração automática (TTL) ou permitir que os usuários escolham por quanto tempo os links públicos de compartilhamento ficam ativos
Recomendações para organizações
Orientar os funcionários a não compartilhar dados internos regulamentados ou sensíveis por meio de ferramentas públicas de LLM
Adotar LLMs de nível empresarial (ChatPGT Enterprise, Anthropic Claude Team) sem recursos de compartilhamento por link
Integrar ferramentas de prevenção contra perda de dados (DLP) para interceptar e sinalizar conteúdo enviado antes que ele seja encaminhado a canais públicos
Boas práticas para usuários
Presumir que o conteúdo compartilhado pode se tornar público, a menos que haja comprovação em contrário
Evitar compartilhar informações de identificação pessoal (PII) ou conteúdo altamente sensível em sistemas de chat
Revisar e auditar regularmente as listas de links compartilhados
Desativar o compartilhamento de dados para treinamento de modelos quando a plataforma permitir
Lições aprendidas e perspectivas futuras
Este incidente evidencia um problema mais amplo: configurações padrão inseguras e um design de consentimento inadequado. Muitas vezes, os usuários não têm uma compreensão clara dos limites entre conteúdo privado e público. As plataformas precisam adotar uma experiência de uso segura desde a concepção, eliminando consentimentos implícitos e opções ambíguas.
É essencial implementar painéis de transparência de busca que permitam aos usuários auditar e gerenciar a exposição de conteúdo público, além de enviar notificações proativas quando o conteúdo se tornar público. Plataformas como Microsoft Copilot, Google Gemini e LLaMA, da Meta, também precisam avaliar suas arquiteturas de compartilhamento por links públicos para evitar os mesmos problemas.
Conclusão
O episódio de indexação de conversas com GPT representa um marco importante para a governança da privacidade em IA. Até mesmo escolhas de design de interface bem-intencionadas podem levar à exposição sistêmica de conteúdo sensível. Agora, as equipes de segurança precisam incluir os buffers de interação com LLMs nos modelos de ameaças, tratando o conteúdo das conversas com o mesmo rigor aplicado aos dados tradicionais gerados por usuários. Em uma era de adoção de IA nos setores empresarial e público, transparência, controle e privacidade precisam ser o padrão, não uma preocupação posterior.
22 de outubro de 2025
DevSecCon2025 — O Summit de Segurança de IA
Garanta sua vaga e proteja a transição para a IA nativa


