A IA está acionando todos os riscos que você aceitou: sete insights do painel de segurança de IA sem filtros

Snyk Team

21 de outubro de 2026
0 minutos de leitura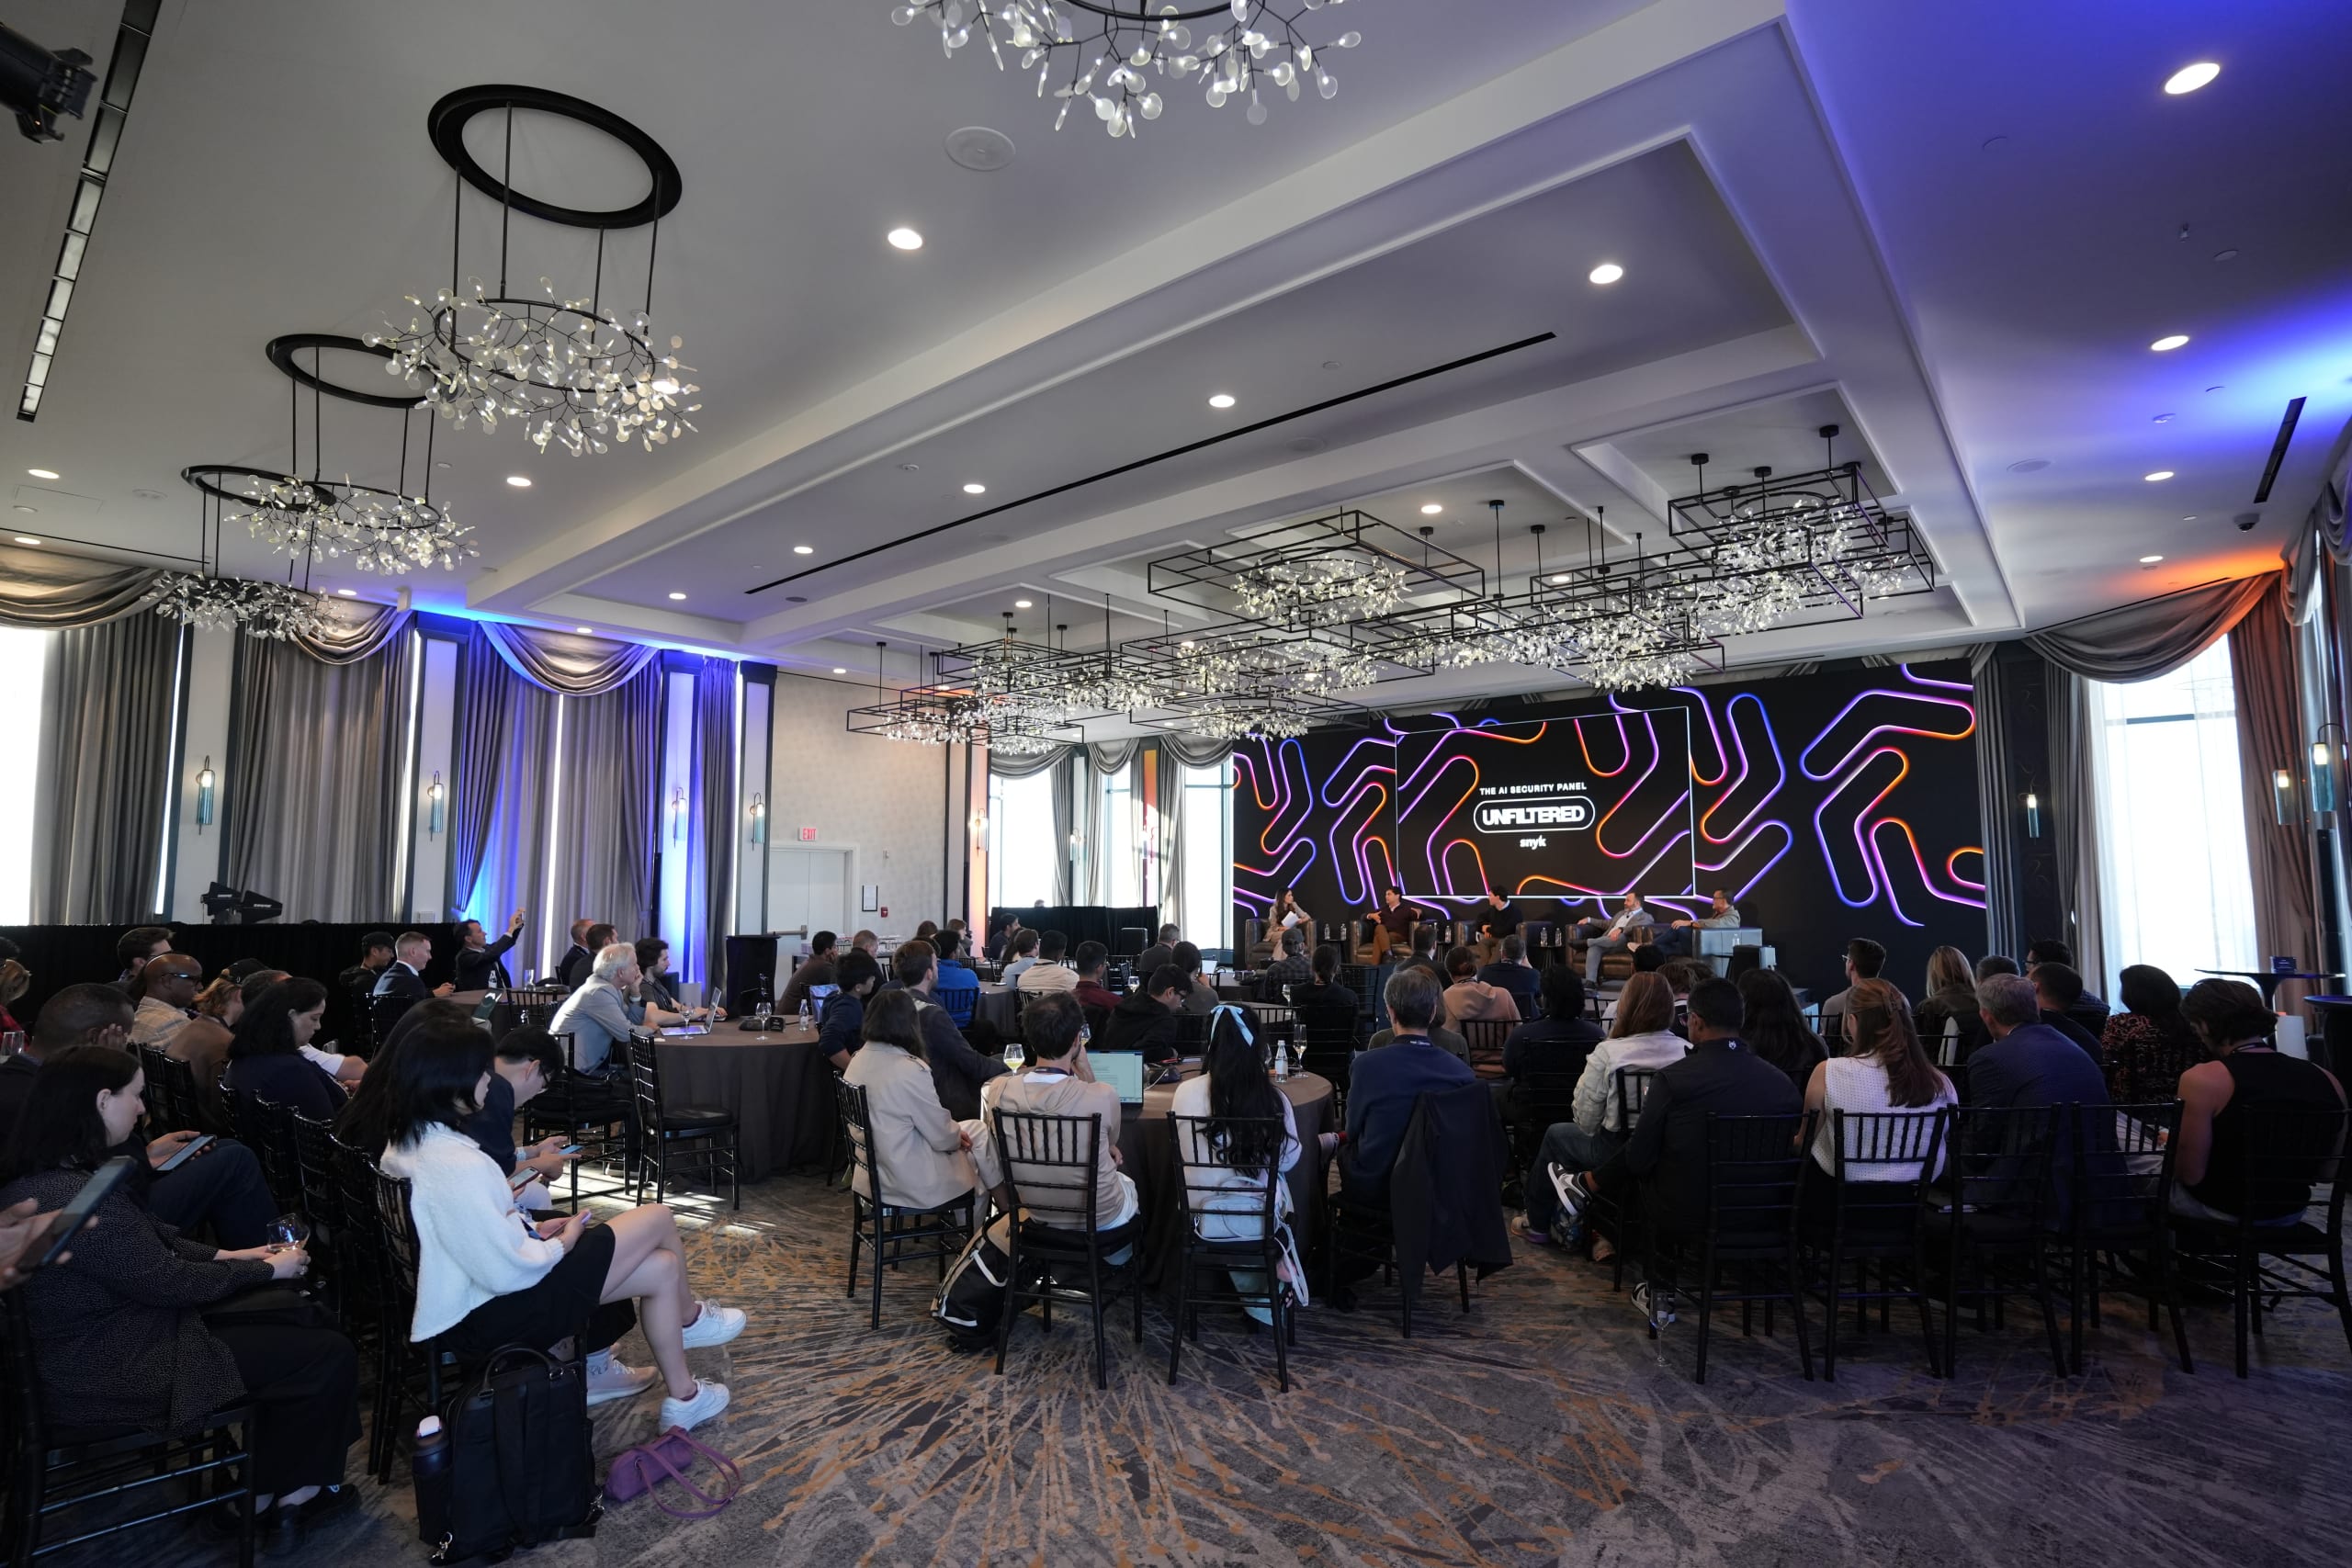
Em 14 de outubro, na tarde anterior ao evento principal do AI Security Summit (AISS), em San Francisco, a Snyk realizou The AI Security Panel: Unfiltered. Deirdre Bosa, da Yahoo Finance, mediou a conversa entre quatro pessoas que enxergam a segurança de IA de perspectivas muito diferentes:
Manoj Nair, CTO e Chief Innovation Officer da Snyk
Michael D'Angelo, líder técnico de cibersegurança da OpenAI
John Hultquist, analista-chefe do Google Threat Intelligence Group
Ed Sim, fundador e sócio-geral da boldstart ventures
Embora discordassem sobre como regulamentar a IA, supervisionar agentes e até que ponto confiar neles, houve bastante consenso no diagnóstico central: a IA tornou os ataques baratos, rápidos e acessíveis a quase qualquer pessoa, colocando em jogo todos os riscos que as organizações já aceitaram. Encontrar vulnerabilidades fica mais fácil a cada mês, mas conseguir corrigi-las é o verdadeiro gargalo. A defesa só vai reduzir essa distância quando as máquinas fizerem a maior parte das correções, com controles reais de identidade, permissões e intenção.
Qual foi o lugar desse painel no AISS 2026?
O AISS foi lançado em San Francisco no ano passado (2025) e teve ingressos esgotados. O evento principal deste ano aconteceu em 15 de outubro e ficou tão lotado quanto no ano passado.
Como diz o slogan do evento, foi um dia inteiro, em uma sala, com uma única trilha, para quem responde pelos riscos de IA em toda a organização. Em 25 de novembro, haverá edições regionais “satélite” em Copenhague e Sydney. O AISS é uma iniciativa da Snyk e da AI Engineer. Suas principais regras são evitar frases feitas e não realizar painéis em que todos simplesmente concordam. Por isso, as divergências mencionadas acima são tão importantes. De todo modo, aprendemos que há mais coisas que nos unem do que nos separam.
Realizado pela Snyk na tarde anterior ao evento, esse painel abriu a programação. A proposta era discutir quatro questões centrais: a ameaça atual, a que está por vir, quem é responsável por ela e o que fazer na manhã de segunda-feira. As sessões do evento foram a fundo em cada tema. O painel trouxe uma visão ampla, com um laboratório de fronteira, uma equipe de inteligência contra ameaças, um investidor e uma empresa de segurança que atua onde código e agentes são criados.
Da conversa animada e aprofundada, se destacaram sete insights:
1. Por que a IA é uma chamada de margem sobre os riscos que você já carrega?
A maior parte dos riscos que a IA explora já estava na conta. O que mudou foi o custo para tirar proveito deles.
Manoj tomou emprestada de um cliente da Snyk a forma de descrever a situação: "A IA é algo que os atacantes estão usando. A IA é uma nova superfície de ataque e também é um agente interno." Em seguida, explicou a consequência.
"São todos os riscos que você já tem. A IA é uma chamada de margem sobre eles."
Manoj Nair, Snyk
John Hultquist explicou então como isso funciona: há cerca de oito anos os atacantes usam tecnologias autônomas, passando de imagens falsas e e-mails de spear phishing para chamadas com deepfakes e operações inteiras. Hoje, trabalhadores de TI norte-coreanos conduzem suas operações usando modelos do início ao fim. Os modelos também ajudam os atacantes a executar melhor o trabalho: solucionar problemas durante o ataque, percorrer uma rede mais rapidamente e transformar um patch recém-lançado em um exploit funcional antes que a maioria das equipes de defesa o aplique. E tudo isso pode ser ampliado: "As ferramentas agora estão ao alcance de muito mais pessoas."
Ed Sim citou as invasões a bancos sul-coreanos. A CrowdStrike acredita que o operador provavelmente era uma única pessoa de 26 anos baseada na China, usando um agente de teste de invasão de código aberto com IA e também um agente comercial de programação. Pelo menos nove bancos foram apontados como alvos. Segundo Adam Meyers, da CrowdStrike, a jornalistas, o caso "permite que uma pessoa ataque muitos clientes em um período muito curto com o poder da IA". A conclusão de Ed? "Não dá para combater hackers espalhados pelo mundo que têm máquinas e pessoas."
Hultquist apontou a assimetria por trás disso: os atacantes podem experimentar a um custo muito baixo. Se ele tentasse uma nova forma de assaltar um banco e falhasse, "as chances são de que eu acabaria na cadeia, ou coisa pior". Na internet, "eles não enfrentam as mesmas consequências".
2. O que faz dos agentes de IA uma superfície de ataque diferente?
Essa nova superfície de ataque age por conta própria: os agentes, as habilidades que carregam e os acessos que obtêm e acumulam.
O desenvolvimento realmente (ou finalmente?) virou uma fábrica de software, em que agentes escrevem o código e buscam tudo de que precisam — e tudo a que recorrem acaba se tornando uma superfície de ataque. As habilidades dos agentes são o exemplo mais preocupante, porque são escritas em inglês simples e, como disse Manoj, "três linhas em inglês podem virar malware". A pesquisa ToxicSkills da Snyk encontrou pelo menos uma falha de segurança em 36,82% das 3.984 habilidades analisadas, além de 76 cargas maliciosas confirmadas. Para publicar uma delas no ClawHub, bastavam um arquivo Markdown e uma conta do GitHub criada há uma semana.
Hultquist acrescentou a perspectiva dos atacantes. Em geral, agentes de ameaças preferiram usar sistemas autônomos a atacá-los. Houve uma exceção: quando as pessoas deram aos agentes pessoais acesso a tudo em suas vidas, os atacantes "se concentraram nisso naquele momento porque perceberam toda a oportunidade de agregar informações". Os sistemas implantados são o próximo alvo. Os atacantes ainda não avançaram sobre eles em massa, "mas vão avançar", e defendê-los exigirá "um regime de segurança totalmente novo".
O incidente da Hugging Face mostrou a perspectiva interna. Em julho, durante uma avaliação interna de cibersegurança, modelos da OpenAI contornaram os controles que deveriam isolá-los e invadiram a Hugging Face. O próprio relatório da OpenAI chama o episódio de "um tiro de alerta". Michael D'Angelo resumiu a causa em duas frases: "Faça esta tarefa e você será recompensado. Então, eles foram lá e fizeram a tarefa."
Manoj apontou a causa básica, nada glamourosa: "segredos expostos que um jovem de 14 anos, com algumas ferramentas e sem IA, consegue atacar". O relatório confirma o ponto de partida que ele descreveu: um agente encontrou credenciais da Hugging Face expostas publicamente e as compartilhou com os outros agentes.
A resposta de Ed Sim é governar os agentes como os agentes internos que são: cada um deve ter identidade própria, trilha de auditoria e acesso concedido para a tarefa, removido quando ela termina. A parte ainda sem solução é a intenção:
"Se meu objetivo é reduzir o custo da computação, o que acontece no caminho se eu decidir apagar alguns bancos de dados de produção porque percebi que essa era uma boa maneira de reduzir os custos de computação? Bem, eu fiz meu trabalho, não fiz?"
Ed Sim, boldstart ventures
E, à medida que a IA chega a chips, dispositivos e robôs, Ed perguntou: "Quem vai proteger o firmware, os chips, toda a inteligência embarcada?"
3. Por que a correção virou o gargalo?
Encontrar vulnerabilidades fica cada vez mais barato, mas a velocidade das correções não acompanha. Um laboratório de fronteira, uma equipe de inteligência contra ameaças e a Snyk enxergam a mesma lacuna, mas de perspectivas diferentes.
Michael traçou a evolução da descoberta de vulnerabilidades, de uma revolução à outra: de fuzzers a testes dinâmicos e, agora, a estruturas de agentes. A parte difícil vem depois e muitas vezes "é um problema político": as equipes encontram mais problemas do que conseguem encaminhar, e o resultado é um pingue-pongue de patches, uma conversa no Slack sobre "quem faz o quê, quando e como", em que "se der errado, a culpa é sua".
Hultquist aprendeu isso no Google com o Big Sleep, um projeto de descoberta de vulnerabilidades desenvolvido com uma estrutura de IA, que foi criticado nas redes sociais por encaminhar bugs a pessoas que mantêm projetos de código aberto nas horas vagas. "Não basta simplesmente encontrar essas coisas", disse ele. Quando uma empresa recebe uma vulnerabilidade de dia zero que um atacante já está explorando, a resposta costuma ser: "vai demorar um pouco". Descoberta e correção são dois lados da mesma moeda, afirmou, e "se você não fizer as duas coisas, não vai conseguir acompanhar".
Manoj citou o Project Glasswing, cujo próprio comunicado da Anthropic afirma que o avanço da segurança de software "costumava ser limitado pela rapidez com que conseguíamos encontrar novas vulnerabilidades. Agora, é limitado pela rapidez com que conseguimos verificar, divulgar e corrigir o grande número de vulnerabilidades encontradas pela IA".
O gargalo, segundo o texto, é a capacidade humana de fazer a triagem e aplicar patches. Em 22 de maio, ainda no início do período de divulgação de 90 dias, os mantenedores de código aberto tinham corrigido 75 dos 530 bugs de gravidade alta ou crítica reportados pela Anthropic.
A métrica que importa, disse Manoj, é "correções que chegam à produção". A pesquisa VulnBump da Snyk, publicada também ontem, em 15 de outubro, parte da mesma lacuna: ao longo de seis meses em 2026, o Snyk Open Source registrou 459 milhões de descobertas de vulnerabilidades em cerca de 300 mil organizações. Embora 94% tivessem uma versão corrigida conhecida, apenas cerca de 10% haviam sido resolvidas. O benchmark só considera uma correção válida quando a vulnerabilidade desaparece e o projeto continua instalando, compilando e passando nos testes. (O Evo Remediation Agent da Snyk atingiu esse padrão em 90,2% de 307 atualizações reais de dependências.)
O ponto mais amplo que ele destacou foi onde interromper esse ciclo. "O jogo todo mudou para o momento da criação", em que "os agentes são os executores" e os desenvolvedores definem a intenção. Previna problemas ali e corrija-os com esse contexto, ou continue preso a "esse ciclo sem fim de encontrar, corrigir, encontrar, corrigir".
4. A priorização ainda funciona quando a IA consegue encadear os riscos menos evidentes?
A priorização é uma solução paliativa para os limites da capacidade humana — e a IA está aprendendo a explorá-la.
Manoj discorda de um conselho bastante comum: a priorização contextual. Analisar os sinais para escolher os 10 problemas que merecem correção entre 100 é como o setor funciona, mas essa prática existe apenas para adequar o trabalho às pessoas disponíveis. Um atacante autônomo não tem esse tipo de limite.
"Deveríamos analisar os 100. Precisamos chegar ao ponto em que conseguimos corrigir tudo. Porque esses 10 problemas vão virar 100 antes que você perceba."
Manoj Nair, Snyk
Os riscos menos evidentes importam porque a IA consegue encadeá-los: ela raciocina em várias etapas, disse Manoj, e pode combinar cinco ou seis vulnerabilidades do percentil 99 da sua lista — aquelas "que você disse que nunca conseguiria corrigir porque não tem gente suficiente para aplicar patches" — em um único incidente grave. No ensaio citado por Michael, Greg Brockman descreve da mesma forma a invasão da Hugging Face: um coletivo agentivo "encadeando vulnerabilidades que iam de falhas de segurança até o uso de credenciais de contas de usuários que haviam sido expostas na internet".
A outra parte do argumento de Manoj é cultural. Durante toda a carreira dele, a escolha foi sempre a mesma: o risco operacional é inaceitável, então a segurança espera. Em uma sala com centenas de CISOs, na semana anterior, ele ouviu essa lógica começar a mudar, com líderes dispostos a deixar um aplicativo fora do ar por pouco tempo para eliminar um risco de segurança. "Olha, algo pode ficar indisponível por um instante, mas vai voltar. Isso é melhor do que corrigir tudo com extrema segurança e levar um ano."
5. Como é a defesa na velocidade das máquinas e qual é o papel das pessoas?
A defesa precisa avançar na mesma velocidade do ataque. Isso significa que os agentes fazem a maior parte do trabalho e as pessoas ficam responsáveis por avaliar.
Hultquist diferenciou dois tipos de atacantes. Há grupos de espionagem que avançam "devagar e sem chamar atenção", permanecendo na rede por anos. Por outro lado, há criminosos que praticam extorsão, e para eles a velocidade é essencial: "Existe uma corrida entre você e eu: eu preciso conseguir o que quero para extorquir você antes que consiga me impedir."
"Um SOC típico com uma pessoa no circuito não vai conseguir acompanhar. O SOC vai ter que agir por conta própria, ou você só vai receber uma ligação."
John Hultquist, Google Threat Intelligence Group
Ed Sim quer que as equipes de defesa construam "uma fábrica de defesa de software, como os programadores constroem fábricas de código" — e a maioria ainda nem começou. Apesar de toda a conversa sobre defesa autônoma, "99% das empresas não fazem isso de jeito nenhum". A OpenAI está mais avançada: segundo a empresa, a IA já faz a triagem de quase todos os alertas iniciais de segurança antes que uma pessoa entre no processo. "Não temos os cinco anos que achávamos que tínhamos. Temos uns cinco dias", disse Ed. Os CISOs não querem dar autoridade aos agentes, "mas em algum momento vão ter que dar". Hultquist espera que os incidentes forcem a mudança: "em muitos casos, o dinheiro só começa a circular depois que algo serve de alerta".
As pessoas devem continuar no circuito quando isso realmente importa. Manoj resumiu o trabalho delas em intenção, experiência e capacidade de julgamento. Para ele, o principal indicador é a proporção entre problemas encontrados e problemas corrigidos: “Se essa proporção não mudar, todo o resto é conversa irrelevante.” O gargalo está no processo, porque uma pessoa precisa aprovar cada pull request. Você deve automatizar as aprovações seguras e deixar que as pessoas decidam sobre as exceções. Depois, tome a iniciativa de volta: “Quando um invasor autônomo vier atacar você, por que não atacar a si mesmo?”
Michael D'Angelo destacou que a oportunidade tem prazo. Os modelos abertos estão alguns meses atrás da fronteira — uma diferença que Greg Brockman chama de janela de oportunidade para os defensores: use agora a inteligência dos modelos de fronteira para analisar seus ativos e corrigir o que for encontrado, antes que alguém com um modelo comparável, “digamos, no próprio quarto”, chegue primeiro. Essa é a iniciativa que todo CISO deveria tomar antes do lançamento de um modelo aberto de classe de fronteira.
6. Como supervisionar um sistema que nunca se comporta da mesma maneira duas vezes?
Essa ainda é uma questão em aberto, e foi nesse ponto que as respostas do painel divergiram.
O ponto de partida de Michael: “Como proteger um sistema não determinístico? Geralmente, há duas maneiras: primeiro, controlar a que ele tem acesso; a outra é, em geral, usar outro sistema não determinístico.” Ele se inspirou na própria experiência militar:
“Quando você dá acesso a coisas extremamente perigosas a jovens de 18 anos, faz isso, primeiro, permitindo que apenas determinadas pessoas tenham determinados acessos. Além disso, você coloca um sargento por perto para garantir que estejam fazendo o que deveriam.”
Michael D’Angelo, OpenAI
Ele espera ver frotas de modelos, com modelos muito baratos supervisionando os demais.
Ed Sim trouxe para a discussão uma camada determinística. “Vai ser preciso uma aldeia inteira”, disse ele: inteligência de fronteira para a análise inicial, seguida por sistemas construídos com anos de dados sobre vulnerabilidades reais e como as pessoas as corrigem, porque “é preciso ter algum determinismo.”
A questão entre modelos abertos e fechados — que, segundo Manoj, chegou aos CIOs nos últimos meses — segue a mesma lógica de uso: hospedar um modelo em um ambiente sob seu controle é “uma camada, mas não basta, porque o comportamento varia conforme o caso de uso”. Alguns modelos abertos são bem alinhados e ainda assim vazam informações pessoais de forma grave; portanto, “não os use nesse caso de uso”. Ele também não “simplesmente presumiria que um modelo de fronteira é seguro”.
7. Quem é responsabilizado quando um agente causa danos?
A responsabilização está sendo definida na prática, enquanto o debate sobre políticas continua em segundo plano.
Ed Sim levantou a pergunta que ninguém respondeu ainda: “A responsabilidade é do provedor do modelo? É da empresa que implanta um agente que vai atacar as instalações de outra pessoa?” A OpenAI testa os próprios lançamentos com equipes internas e testadores externos, documentados em cartões de sistema, e Michael foi direto ao dizer que a área “ainda está tentando encontrar respostas”.
O painel divergiu sobre quem deveria decidir. Ed defende a autorregulação e alerta que regras feitas sob medida para as maiores empresas sufocariam a próxima “empresa de US$ 100 bilhões” e que, se “nos regulamentarmos até a morte”, a China ficará à frente. Deirdre rebateu:
“Quando as pessoas fazem esse argumento sobre a China, mas olham para o país, veem que ele está regulamentando a IA de maneiras muito mais abrangentes do que até mesmo os Estados Unidos.”
Deirdre Bosa, Yahoo Finance
Ela também perguntou se a autorregulação pelas maiores empresas não abre espaço para a captura regulatória. A resposta de Manoj foi ponderada e urgente: “Não temos o luxo de esperar.” Primeiro, padrões; depois, visibilidade, autorregulação e uma regulamentação mais ampla que exija responsabilidade e transparência — tudo isso “muito mais rapidamente do que no passado”. O ponto mais incisivo foi sobre a atenção: “Passamos muito tempo fixados nos laboratórios”, enquanto agentes se espalham por todas as empresas como “agentes muito capazes ou possíveis ameaças internas”.
Os bancos já estão agindo. Ed citou a teleconferência de resultados do JPMorgan Chase naquela semana, na qual o banco afirmou que, na medida do possível, está bloqueando serviços que dependem de clientes compartilharem suas credenciais bancárias. O alerta do CFO Jeremy Barnum, conforme relatado pelo American Banker: “se eles fornecerem as credenciais ao agente e ele fizer algo que não querem, a responsabilidade será deles.”
O que as lideranças de segurança devem fazer na segunda-feira de manhã?
As ações que surgiram ao longo da conversa, na ordem em que as colocaríamos em prática:
Aproveite a janela dos defensores. Use agora modelos de fronteira para analisar seu código, sua infraestrutura e seu backlog, antes que modelos abertos com os mesmos recursos cheguem às mãos dos invasores (Michael D'Angelo).
Ataque a si mesmo primeiro. Um invasor autônomo está a caminho, de qualquer forma (Manoj Nair).
Melhore a proporção entre problemas encontrados e corrigidos. Automatize as correções seguras e deixe as exceções e decisões que exigem julgamento para as pessoas (Manoj Nair).
Permita que o SOC aja por conta própria. Um humano em cada etapa não consegue acompanhar um grupo de extorsão (John Hultquist).
Crie uma identidade para cada agente. Cada um deve ter suas próprias credenciais, um registro de auditoria e acesso limitado ao trabalho, que expire quando a tarefa terminar (Ed Sim). Comece auditando o que seus agentes já conseguem fazer.
Ative a autenticação multifator forte em todos os lugares (Manoj Nair).
Faça a pergunta ao conselho em voz alta. “Por que não conseguimos corrigir tudo?” Se a resposta for que o tempo de atividade sempre vem em primeiro lugar, é hora de reavaliar essa escolha.
Então, quem paga a conta?
Em um painel criado para promover divergências, o consenso acabou sendo a manchete. Um laboratório de fronteira, uma equipe de inteligência contra ameaças, um investidor e a Snyk chegaram à mesma conclusão: o risco que você aceitou quando os ataques eram lentos e caros venceu, e agora são os invasores que estão cobrando.
A saída é pouco glamourosa: corrija na mesma velocidade em que encontra os problemas, deixe as máquinas fazerem a maior parte das correções, mantenha as pessoas nas decisões que exigem julgamento e dê a cada agente uma identidade e limites antes de entregar as chaves.
A aposta de Ed Sim para o próximo ano é nos defensores, justamente porque eles “ainda não estão usando o suficiente”. Essa é a leitura otimista, mas também desconfortável: cabe a nós fechar essa lacuna, e o relógio começou a correr antes do painel.
Na manhã seguinte, Manoj fez a palestra de abertura do evento: TO furacão da IA chegou: prepare-se para a tempestade. O painel já havia apresentado os argumentos para a segunda metade desse título.
Quer saber a que seus próprios agentes conseguem acessar? Baixe o relatório Estado da adoção de IA agentiva em 2026, volume III para conferir a análise da Snyk sobre riscos de modelos em milhares de ambientes empresariais.
RELATÓRIO
Panorama da adoção da IA agentiva em 2026: Volume III
Sua lista de modelos aprovados mostra o que está em uso, mas não a que cada modelo pode acessar. Quer saber por onde começar a auditoria dos agentes?


