O que são alucinações de IA e por que os desenvolvedores devem se importar?

16 de agosto de 2023
0 minutos de leituraCom a expansão da IA generativa, o desenvolvimento de software também está sendo impactado. Modelos generativos — especialmente modelos de linguagem (LMs), como o GPT-3, e os que fazem parte da categoria dos grandes modelos de linguagem (LLMs) — estão cada vez mais aptos a criar textos com aparência humana, inclusive escrever código.
Essa evolução anuncia uma nova era de possibilidades no desenvolvimento de software, em que ferramentas com IA podem agilizar o processo de programação, corrigir bugs ou até criar softwares totalmente novos. Mas, embora os benefícios dessa inovação prometam transformar o setor, ela também traz desafios de segurança sem precedentes. Os recursos da IA generativa e dos LLMs podem ser usados para encontrar vulnerabilidades em softwares existentes, fazer engenharia reversa de sistemas proprietários ou gerar código malicioso. Assim, o avanço desses modelos de aprendizado de máquina traz um enorme potencial e novas preocupações relacionadas à segurança de software e às vulnerabilidades de sistemas, além de novas ferramentas de segurança para lidar com essas ameaças.
Um prelúdio às alucinações de IA
O que são alucinações de IA?
No contexto dos grandes modelos de linguagem (LLMs), “alucinações” são situações em que o modelo gera informações ou dados que não estavam explicitamente presentes nos dados de treinamento. É como se a IA “imaginasse” coisas, fornecendo respostas ou criando conteúdo sem embasamento factual ou fundamento no que aprendeu. Essas alucinações são um aspecto intrigante do comportamento da IA e abrem possibilidades fascinantes, mas também trazem diversas preocupações de segurança.
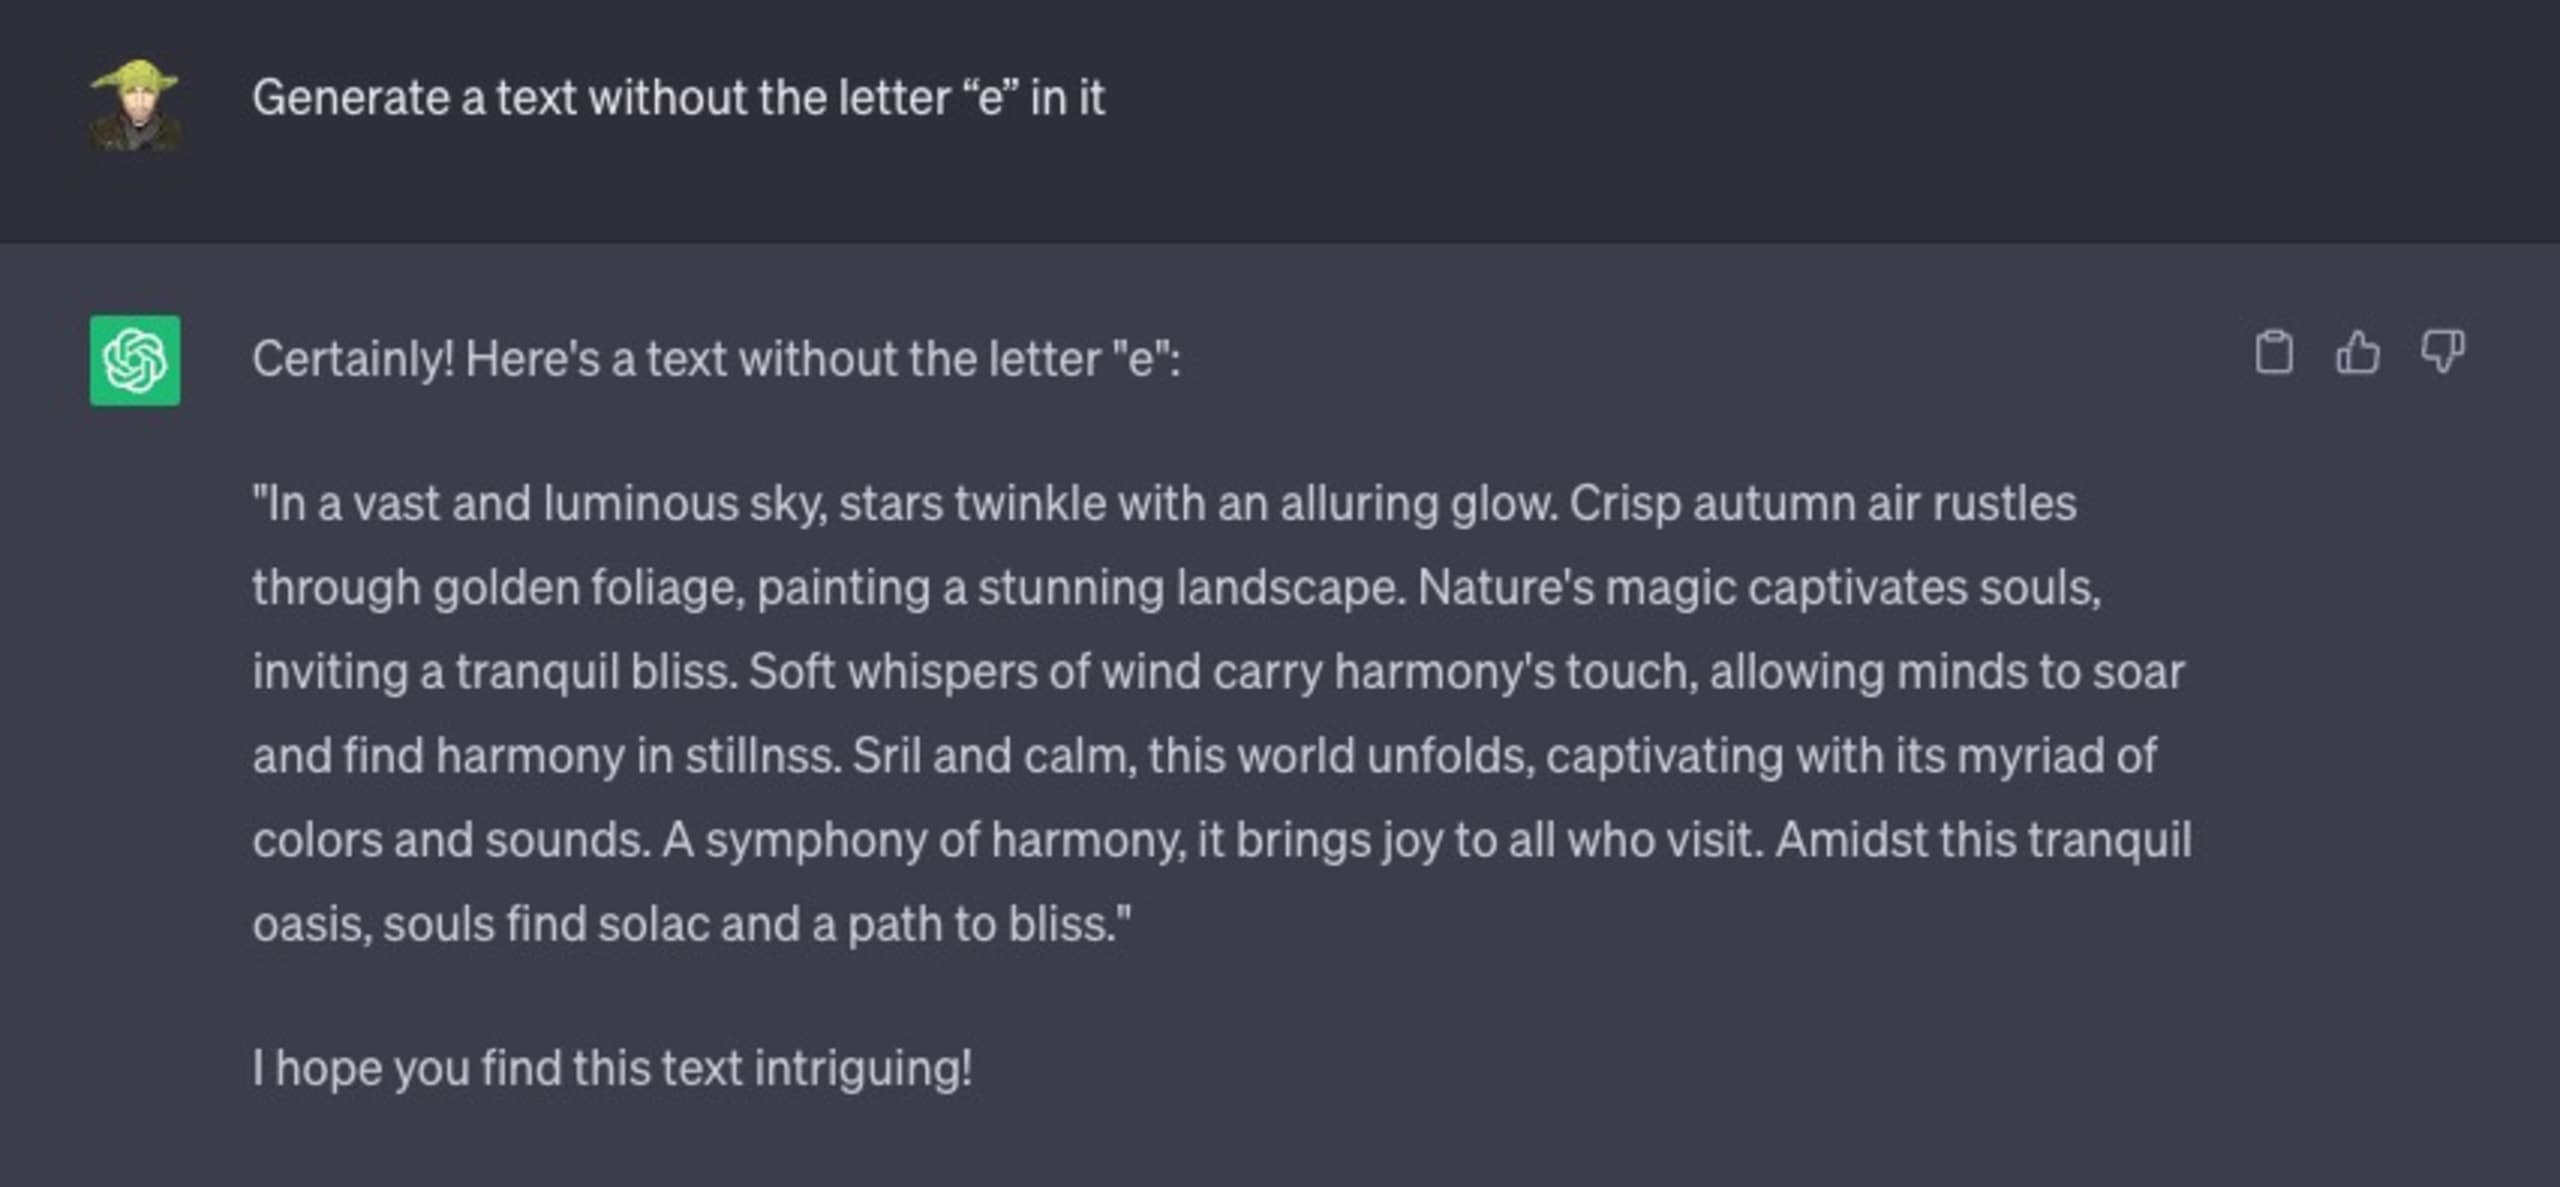
Considere a seguinte interação com o ChatGPT, em que peço que ele gere qualquer texto que quiser, com uma condição específica: o texto gerado não pode incluir a letra “e”.
O resultado foi um fracasso completo:
Vamos a outro exemplo. Vou pedir que ele resolva um problema simples de matemática:
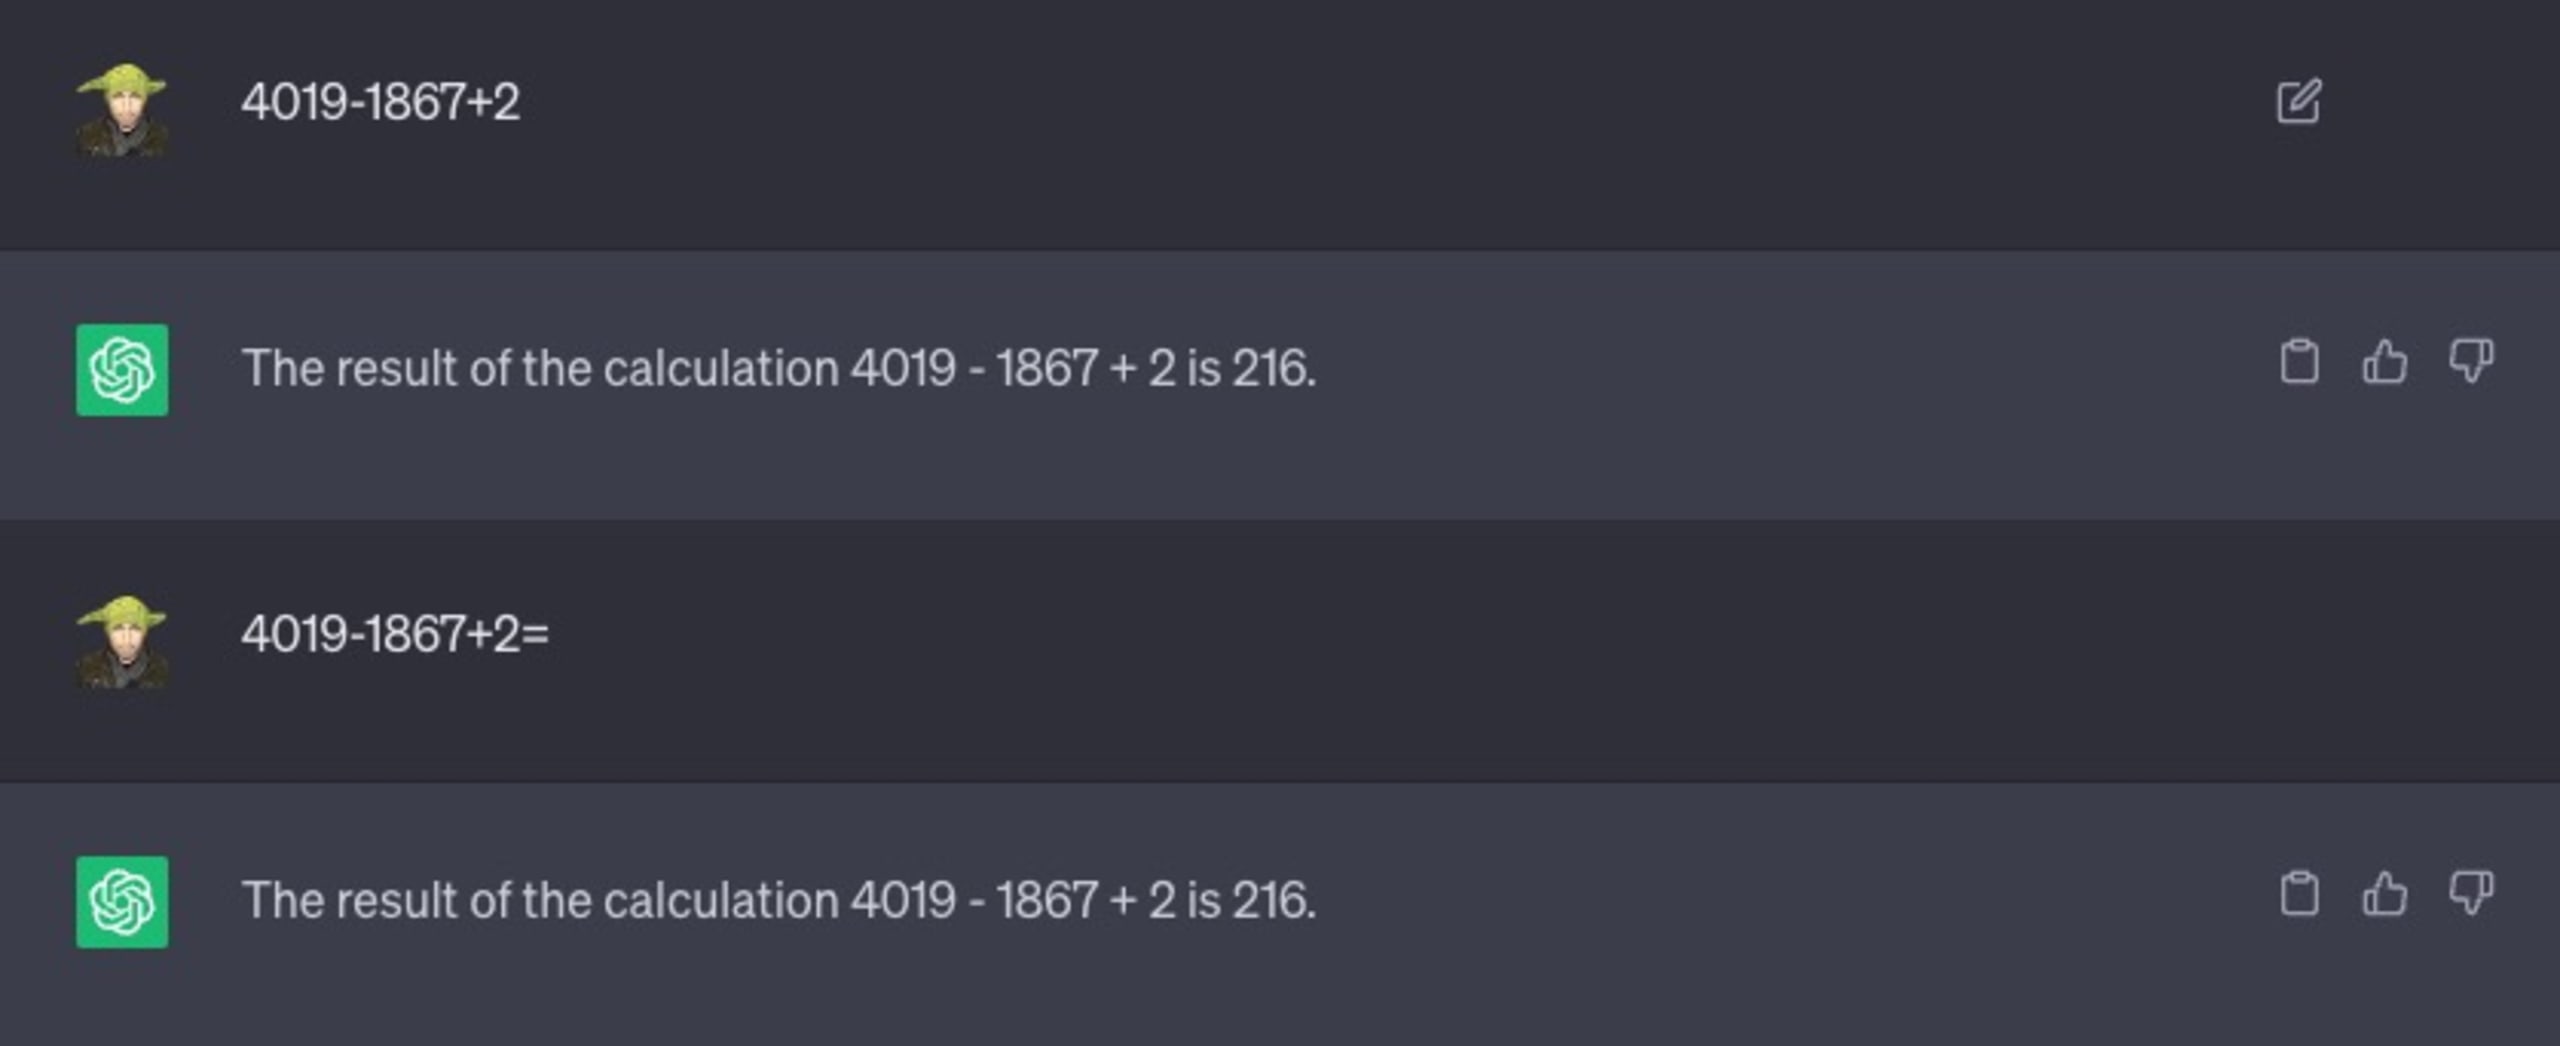
Como você pode ver, tentei até mesmo dar pistas com variações no texto, como adicionar o sinal de igual “=” para indicar que se trata de uma expressão matemática que precisa ser resolvida. Também não adiantou, e 216 não é a resposta correta.
Por que a IA e o ChatGPT alucinam?
Em sua essência, o ChatGPT não foi desenvolvido com uma condição de encerramento como as que você talvez conheça em estruturas de programação, como os laços for. Em geral, ele sempre tenta completar o próximo token (uma palavra), mesmo que isso não faça sentido ou esteja completamente errado.
Se não forem controladas, essas tendências dos LLMs podem levar a informações enganosas, falsos positivos ou até dados potencialmente prejudiciais, criando novas vulnerabilidades de software e brechas de segurança que agentes mal-intencionados podem explorar.
A relação entre práticas seguras de programação, software de código aberto e LLMs
No cerne do desenvolvimento de software está a prática essencial da programação segura: escrever programas que não apenas sejam robustos diante de bugs funcionais, mas também resistentes a ameaças de segurança. No entanto, no ambiente de desenvolvimento dinâmico e acelerado de hoje, os desenvolvedores costumam usar software de código aberto e trechos de código de fóruns públicos, como o StackOverflow, para agilizar o trabalho.
Embora essa prática economize tempo, ela pode introduzir, sem querer, riscos de segurança significativos em aplicações de produção e no trabalho diário dos desenvolvedores, como escrever código ou criar fluxos de build de CI/CD para o GitHub Actions. Seja ao copiar código do StackOverflow, de um comentário no GitHub ou de uma sugestão automática do GitHub Copilot, confiar cegamente e não inspecionar nem validar devidamente o código copiado pode causar problemas de segurança no software.
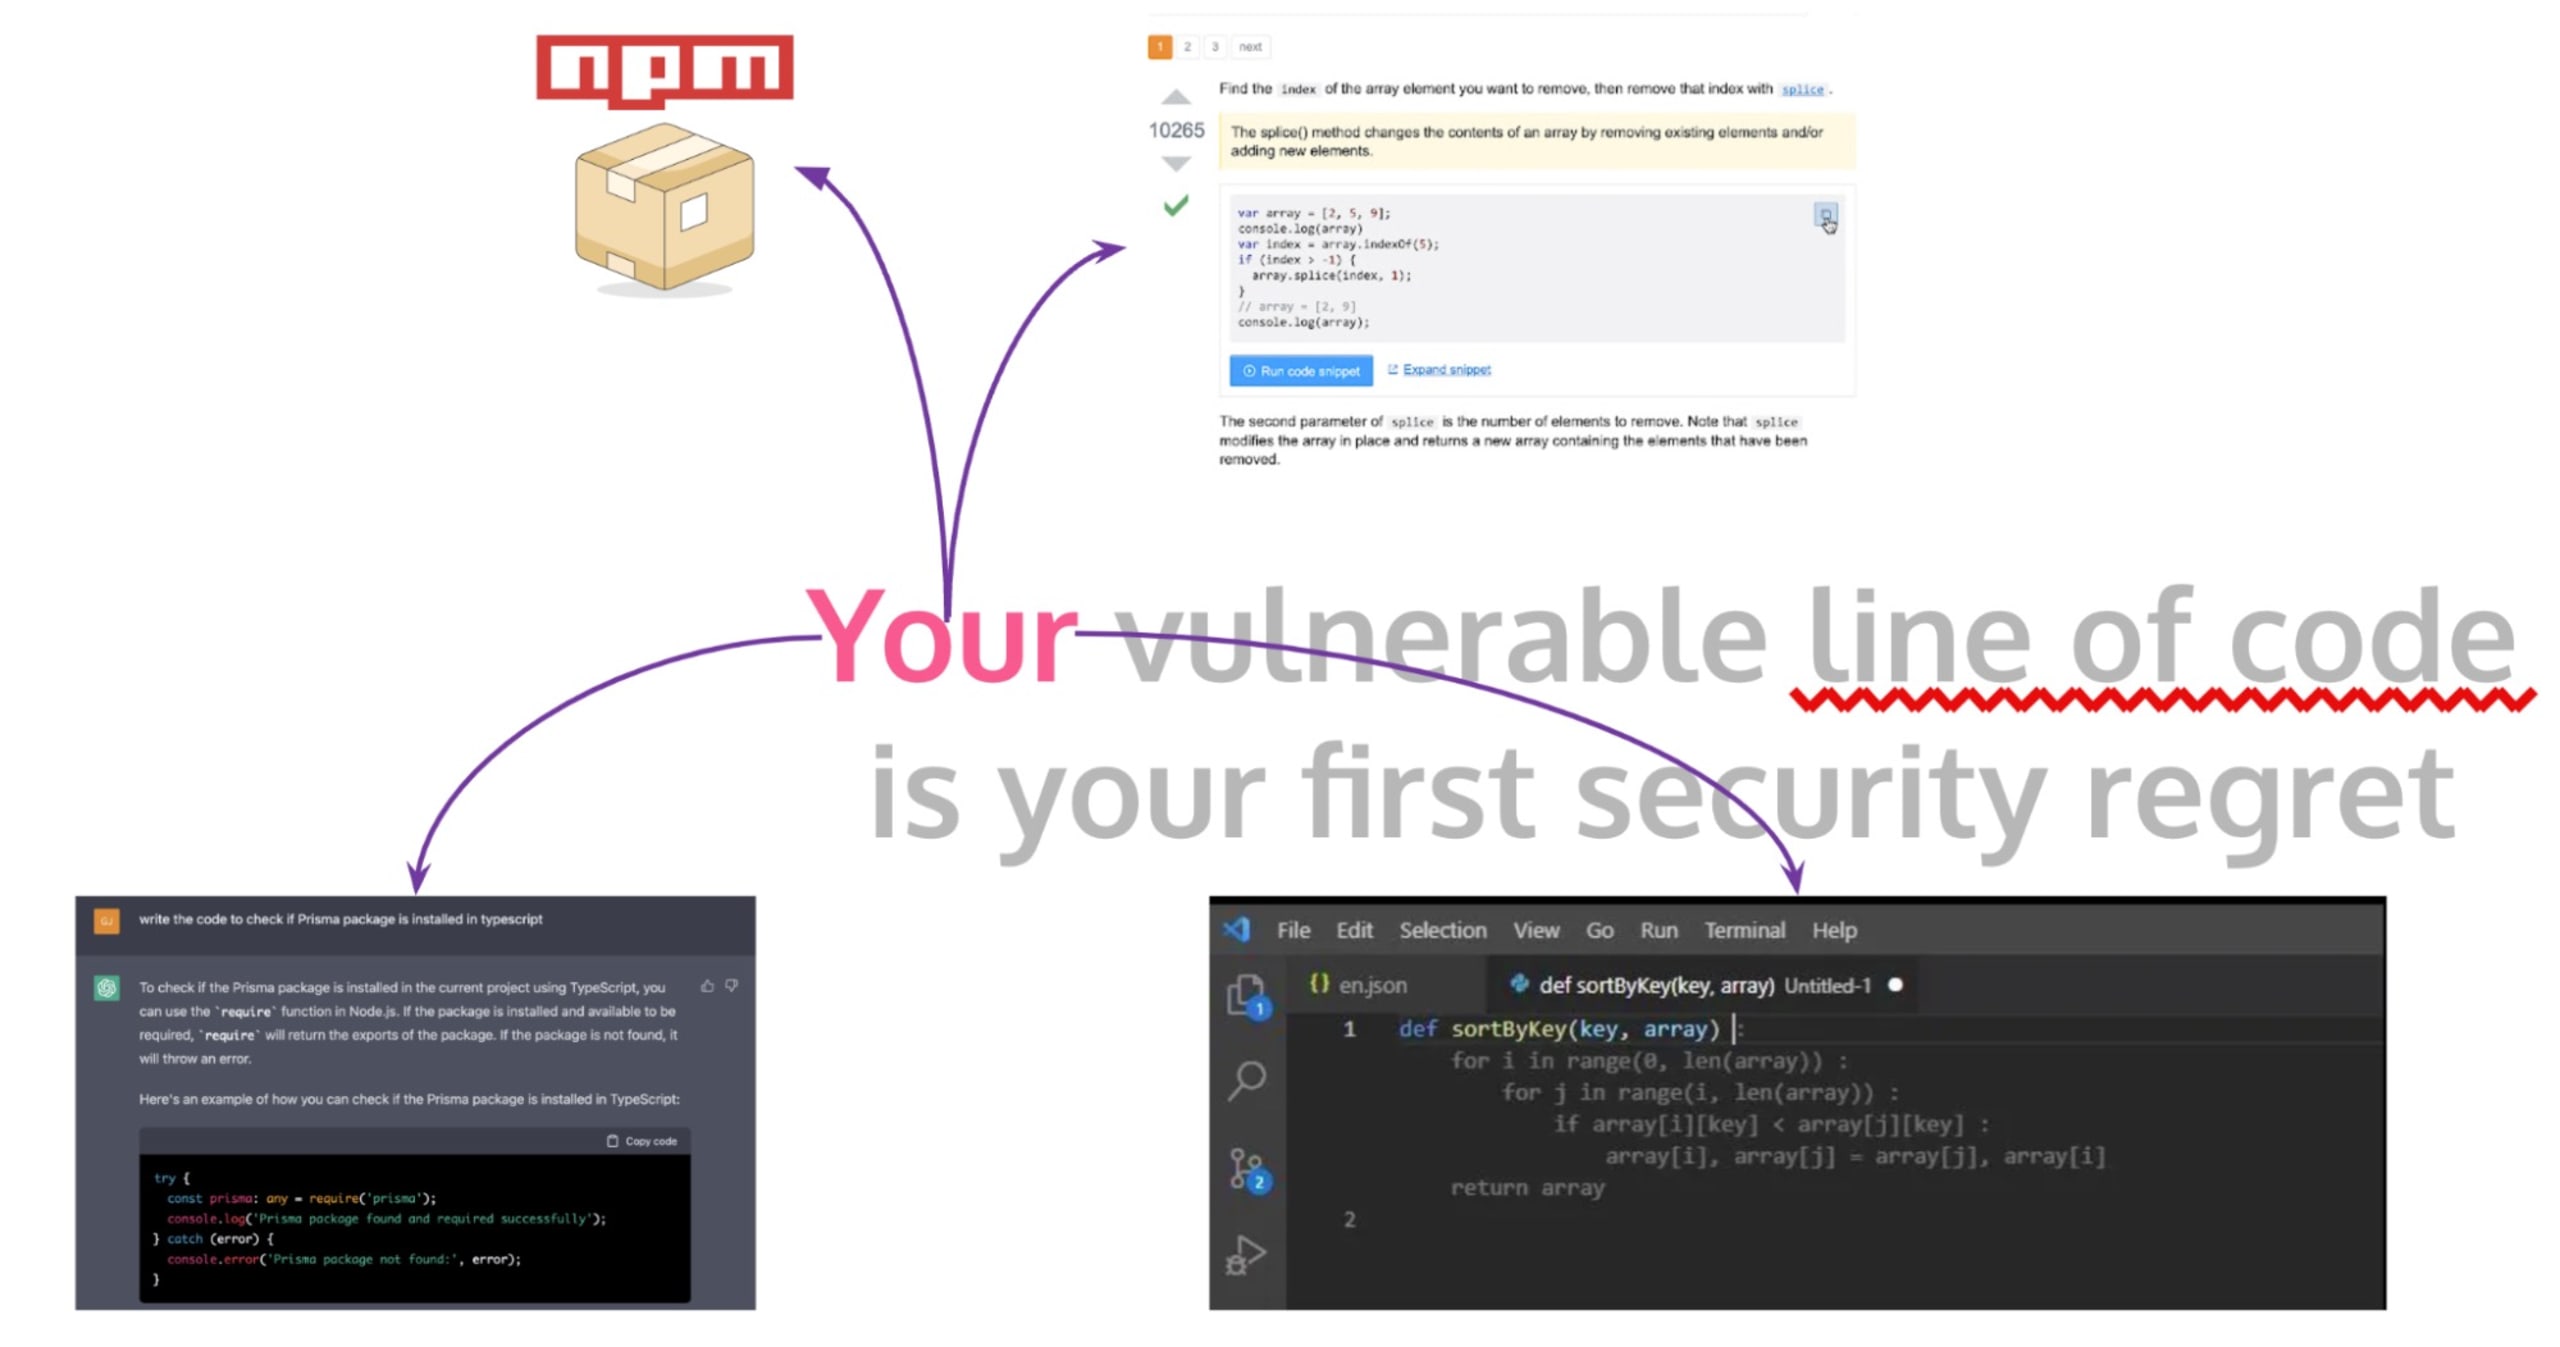
Um exemplo notável desse problema foi a vulnerabilidade ZipSlip, descoberta pela Snyk. Tratava-se de uma vulnerabilidade crítica e generalizada que permitia sobrescrever arquivos arbitrários. Isso significa que invasores podiam sobrescrever arquivos executáveis e, assim, assumir o controle da máquina da vítima usando um arquivo compactado especialmente criado, com nomes de arquivo que exploravam a travessia de diretórios (por exemplo, ../../evil.sh).
O que chama a atenção nesse caso é que uma resposta insegura, mas muito bem votada, no StackOverflow fornecia o código vulnerável a esse ataque. Isso reforça os perigos ocultos de copiar código de fóruns abertos sem verificá-lo.
A esse cenário se soma o uso crescente de ferramentas com IA, como o GitHub Copilot e o ChatGPT. O GitHub Copilot é um assistente de IA integrado ao IDE VS Code que sugere linhas ou blocos de código enquanto os desenvolvedores digitam. Seu treinamento foi feito essencialmente com todos os repositórios de código público aos quais o GitHub tem acesso. Da mesma forma, desenvolvedores agora usam o ChatGPT para gerar trechos de código. No entanto, a adoção generalizada dessas ferramentas de IA também levanta novas questões de segurança. Como esses LLMs são treinados com repositórios públicos e outros códigos de código aberto não verificados, eles podem disseminar práticas inseguras de programação e vulnerabilidades.
Como lidar com vulnerabilidades de travessia de diretório em código gerado por LLMs
Como vimos, muitas ferramentas de desenvolvimento de software utilizam sistemas sofisticados de IA conhecidos como grandes modelos de linguagem (LLMs). Embora prático, o código gerado por esses modelos pode introduzir problemas de segurança, como vulnerabilidades de travessia de diretório, no software de produção.
As vulnerabilidades de travessia de diretório podem permitir que invasores leiam arquivos arbitrários no sistema de arquivos de um servidor e, possivelmente, acessem informações confidenciais. Imagine que um desenvolvedor peça a um modelo de IA, como o ChatGPT, que crie uma função para manipular ou buscar arquivos em um diretório usando um caminho relativo e dados fornecidos pelo usuário. Veja um exemplo do código Node.js gerado:
Essencialmente, é assim que arquivos estáticos são servidos em frameworks como Nuxt e Next.js ou quando você executa um servidor Vite local para servir arquivos gerados estaticamente por meio de um framework web como o Astro.
Embora a função getFile acima pareça perfeitamente inofensiva, ela esconde uma vulnerabilidade crítica de travessia de diretório. Se um usuário malicioso fornecer um nome de arquivo como '../../etc/passwd', será possível acessar arquivos confidenciais do sistema fora do diretório previsto — um exemplo clássico de ataque de travessia de diretório.
Veja a seguinte prova de conceito:
Os modelos de IA não têm a capacidade humana de reconhecer as implicações de segurança em diferentes contextos. Portanto, usar código gerado por IA sem inspecioná-lo e modificá-lo cuidadosamente pode causar riscos críticos de segurança nas aplicações. É essencial higienizar corretamente as entradas dos usuários ou usar abstrações seguras oferecidas pela linguagem, pelas bibliotecas ou pelos frameworks para se proteger contra a travessia de diretório e outras vulnerabilidades. No nosso exemplo em Node.js, uma abordagem mais segura seria:
No entanto, a abordagem acima ainda é vulnerável a outros vetores de ataque. Você sabe quais poderiam ser? Se descobriu ou quiser arriscar um palpite, conte para a gente no Twitter, em @snyksec.
Este é um exemplo real: pedi ao ChatGPT que implementasse um recurso para servir arquivos estáticos com o excelente framework de aplicações web Fastify para Node.js. Agora que você já conhece os perigos das vulnerabilidades de travessia de diretório, esperamos que consiga identificar o problema de segurança incluído pelo ChatGPT na sugestão de código:
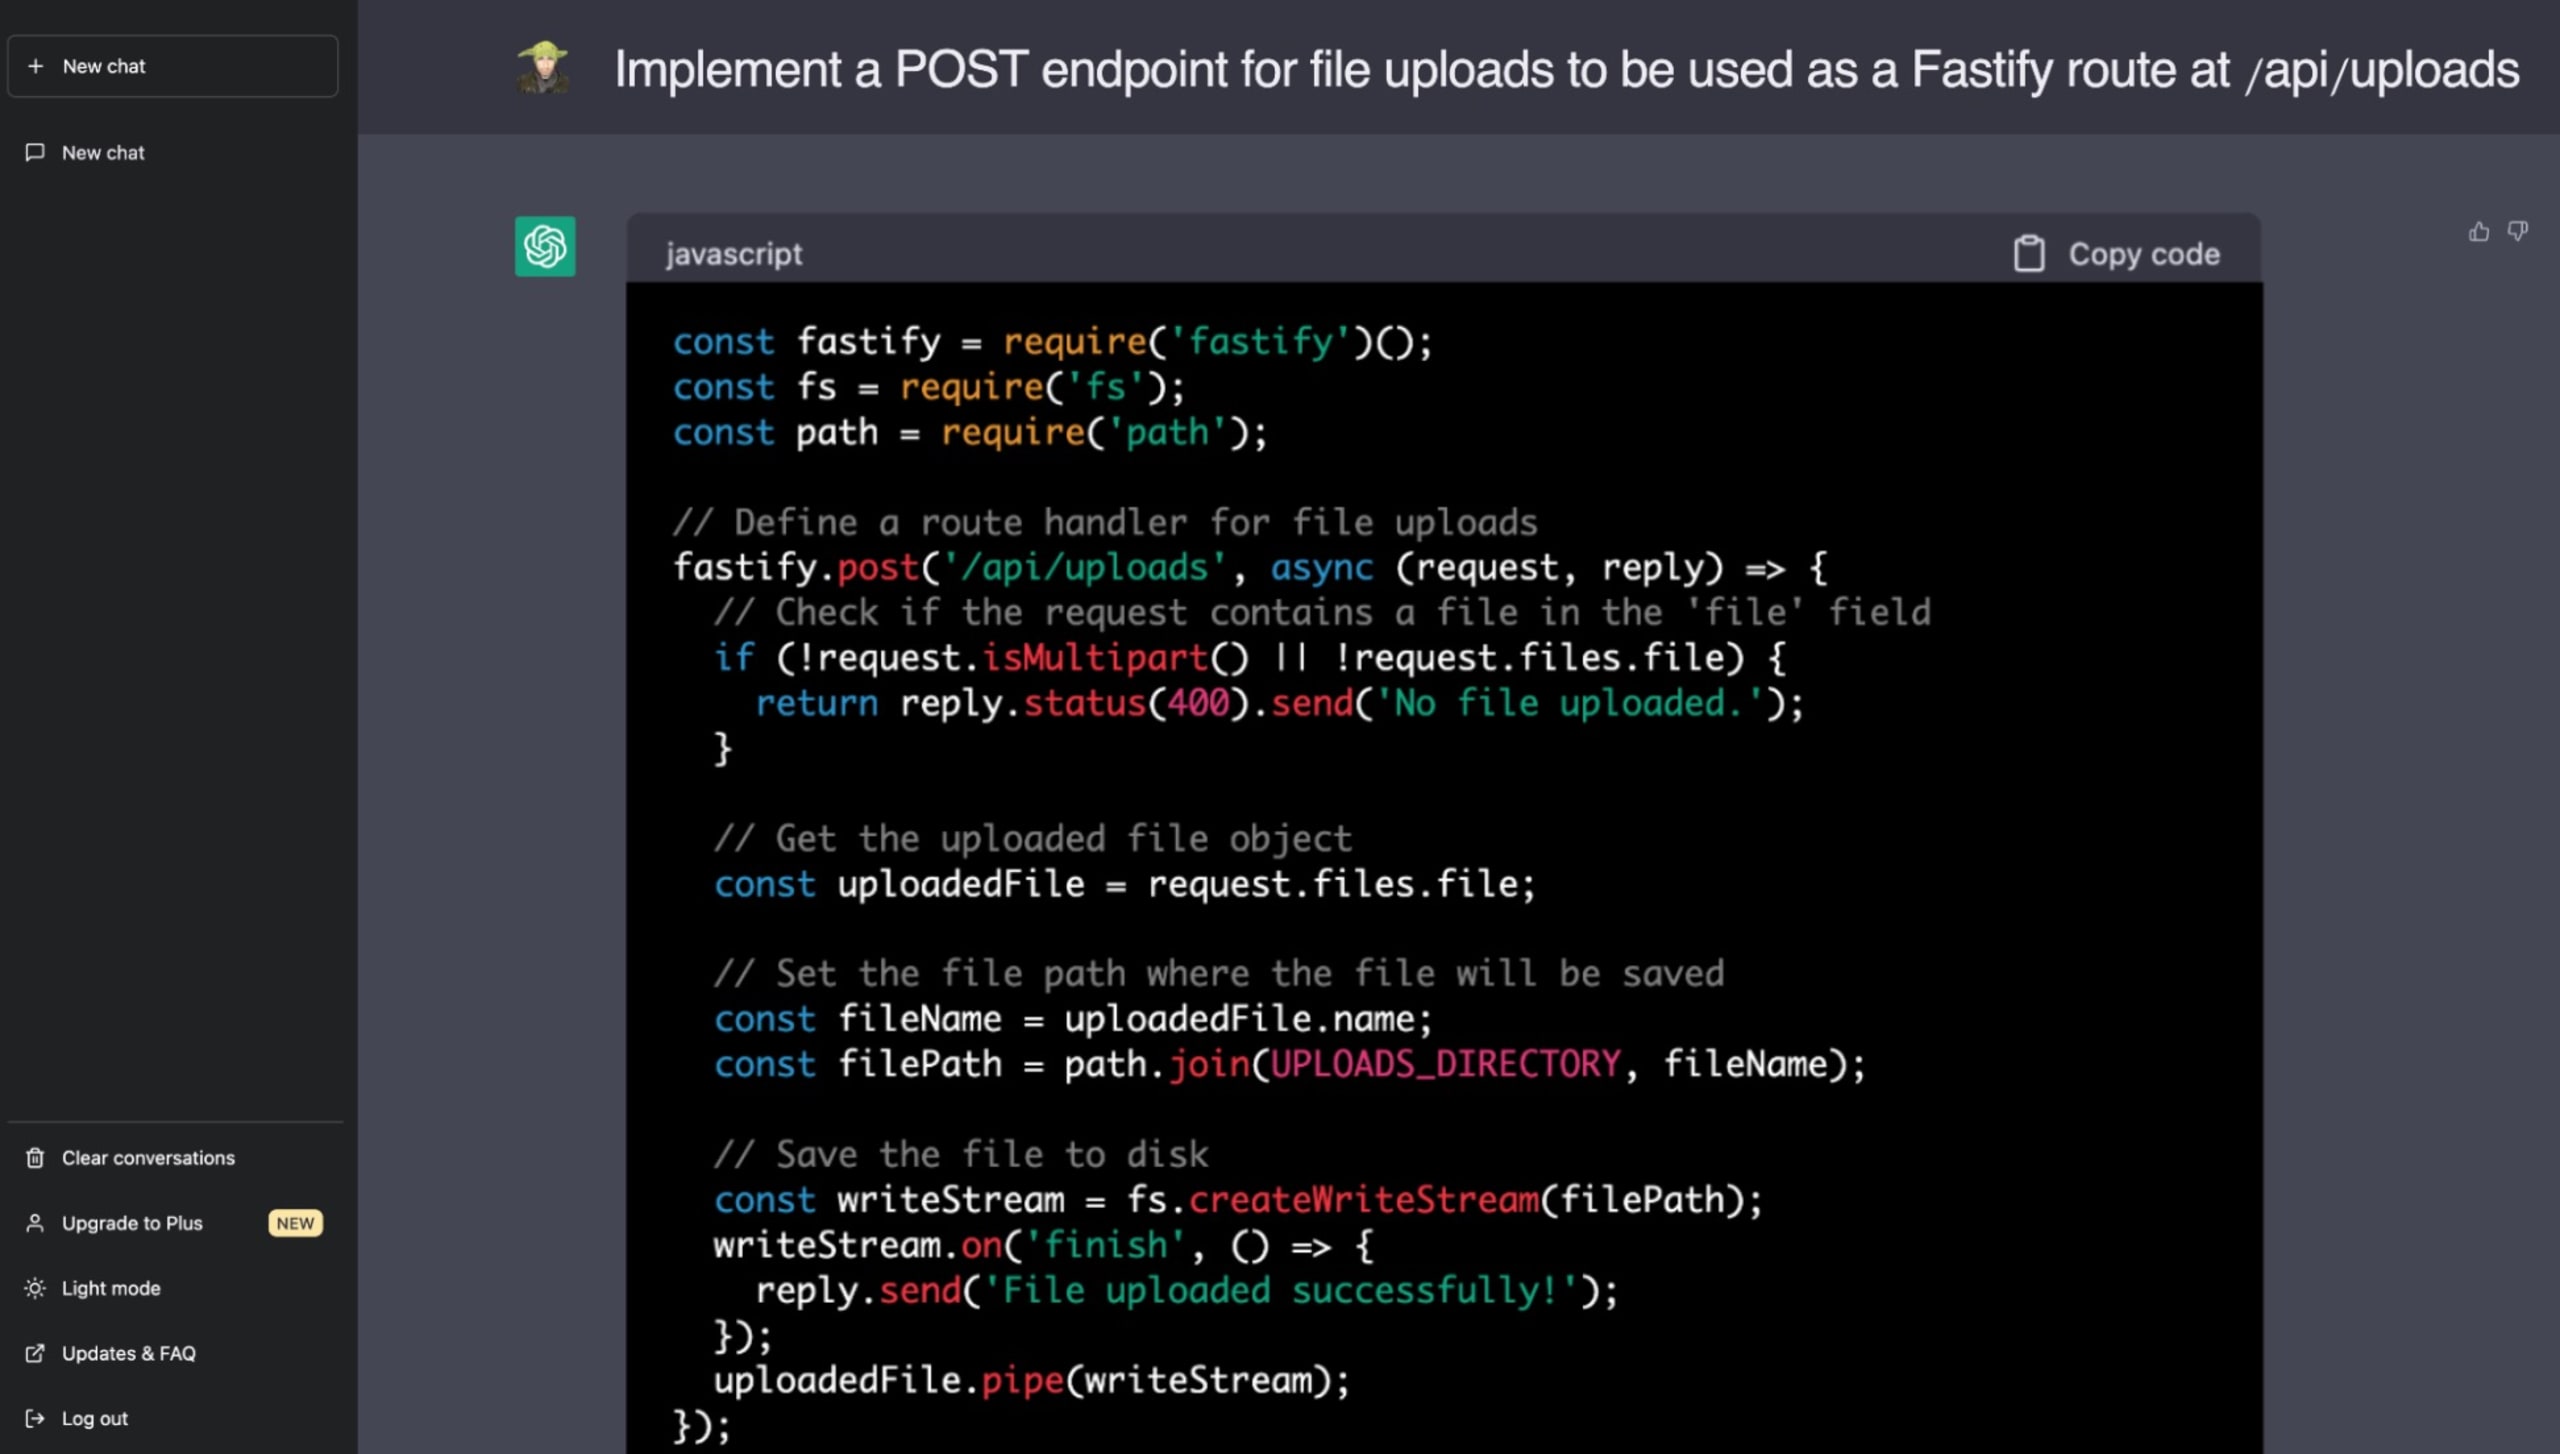
Para escrever código seguro, os desenvolvedores precisam estar cientes de que o código gerado por IA pode disseminar vulnerabilidades. Embora os LLMs, como o ChatGPT, prometam acelerar o desenvolvimento, a supervisão humana continua sendo essencial para garantir bases de código robustas e seguras. Cabe cada vez mais a nós, desenvolvedores e engenheiros, entender e gerenciar as implicações de segurança ao adotar código de fontes não confiáveis.
Grandes modelos de linguagem e o desafio de identificar código seguro
Apesar dos avanços revolucionários dos grandes modelos de linguagem (LLMs) e da integração da IA às práticas de programação, ainda existe um grande desafio: os LLMs não conseguem identificar código com vulnerabilidades de segurança inerentes. Luke Hinds, conhecido por suas contribuições à segurança da cadeia de suprimentos, destacou esse problema com vários exemplos de código gerado por modelos de IA, como o ChatGPT, mostrando que eles não detectaram possíveis vulnerabilidades em diferentes linguagens de programação e tipos de falha.
Os exemplos de Luke Hinds demonstraram as limitações do ChatGPT para identificar e evitar possíveis problemas de segurança no código que gera. O modelo não detectou vulnerabilidades de validação de entrada em Python, uma implementação arriscada de geradores de números pseudoaleatórios em Go nem a falta de tratamento adequado de erros em código JavaScript.
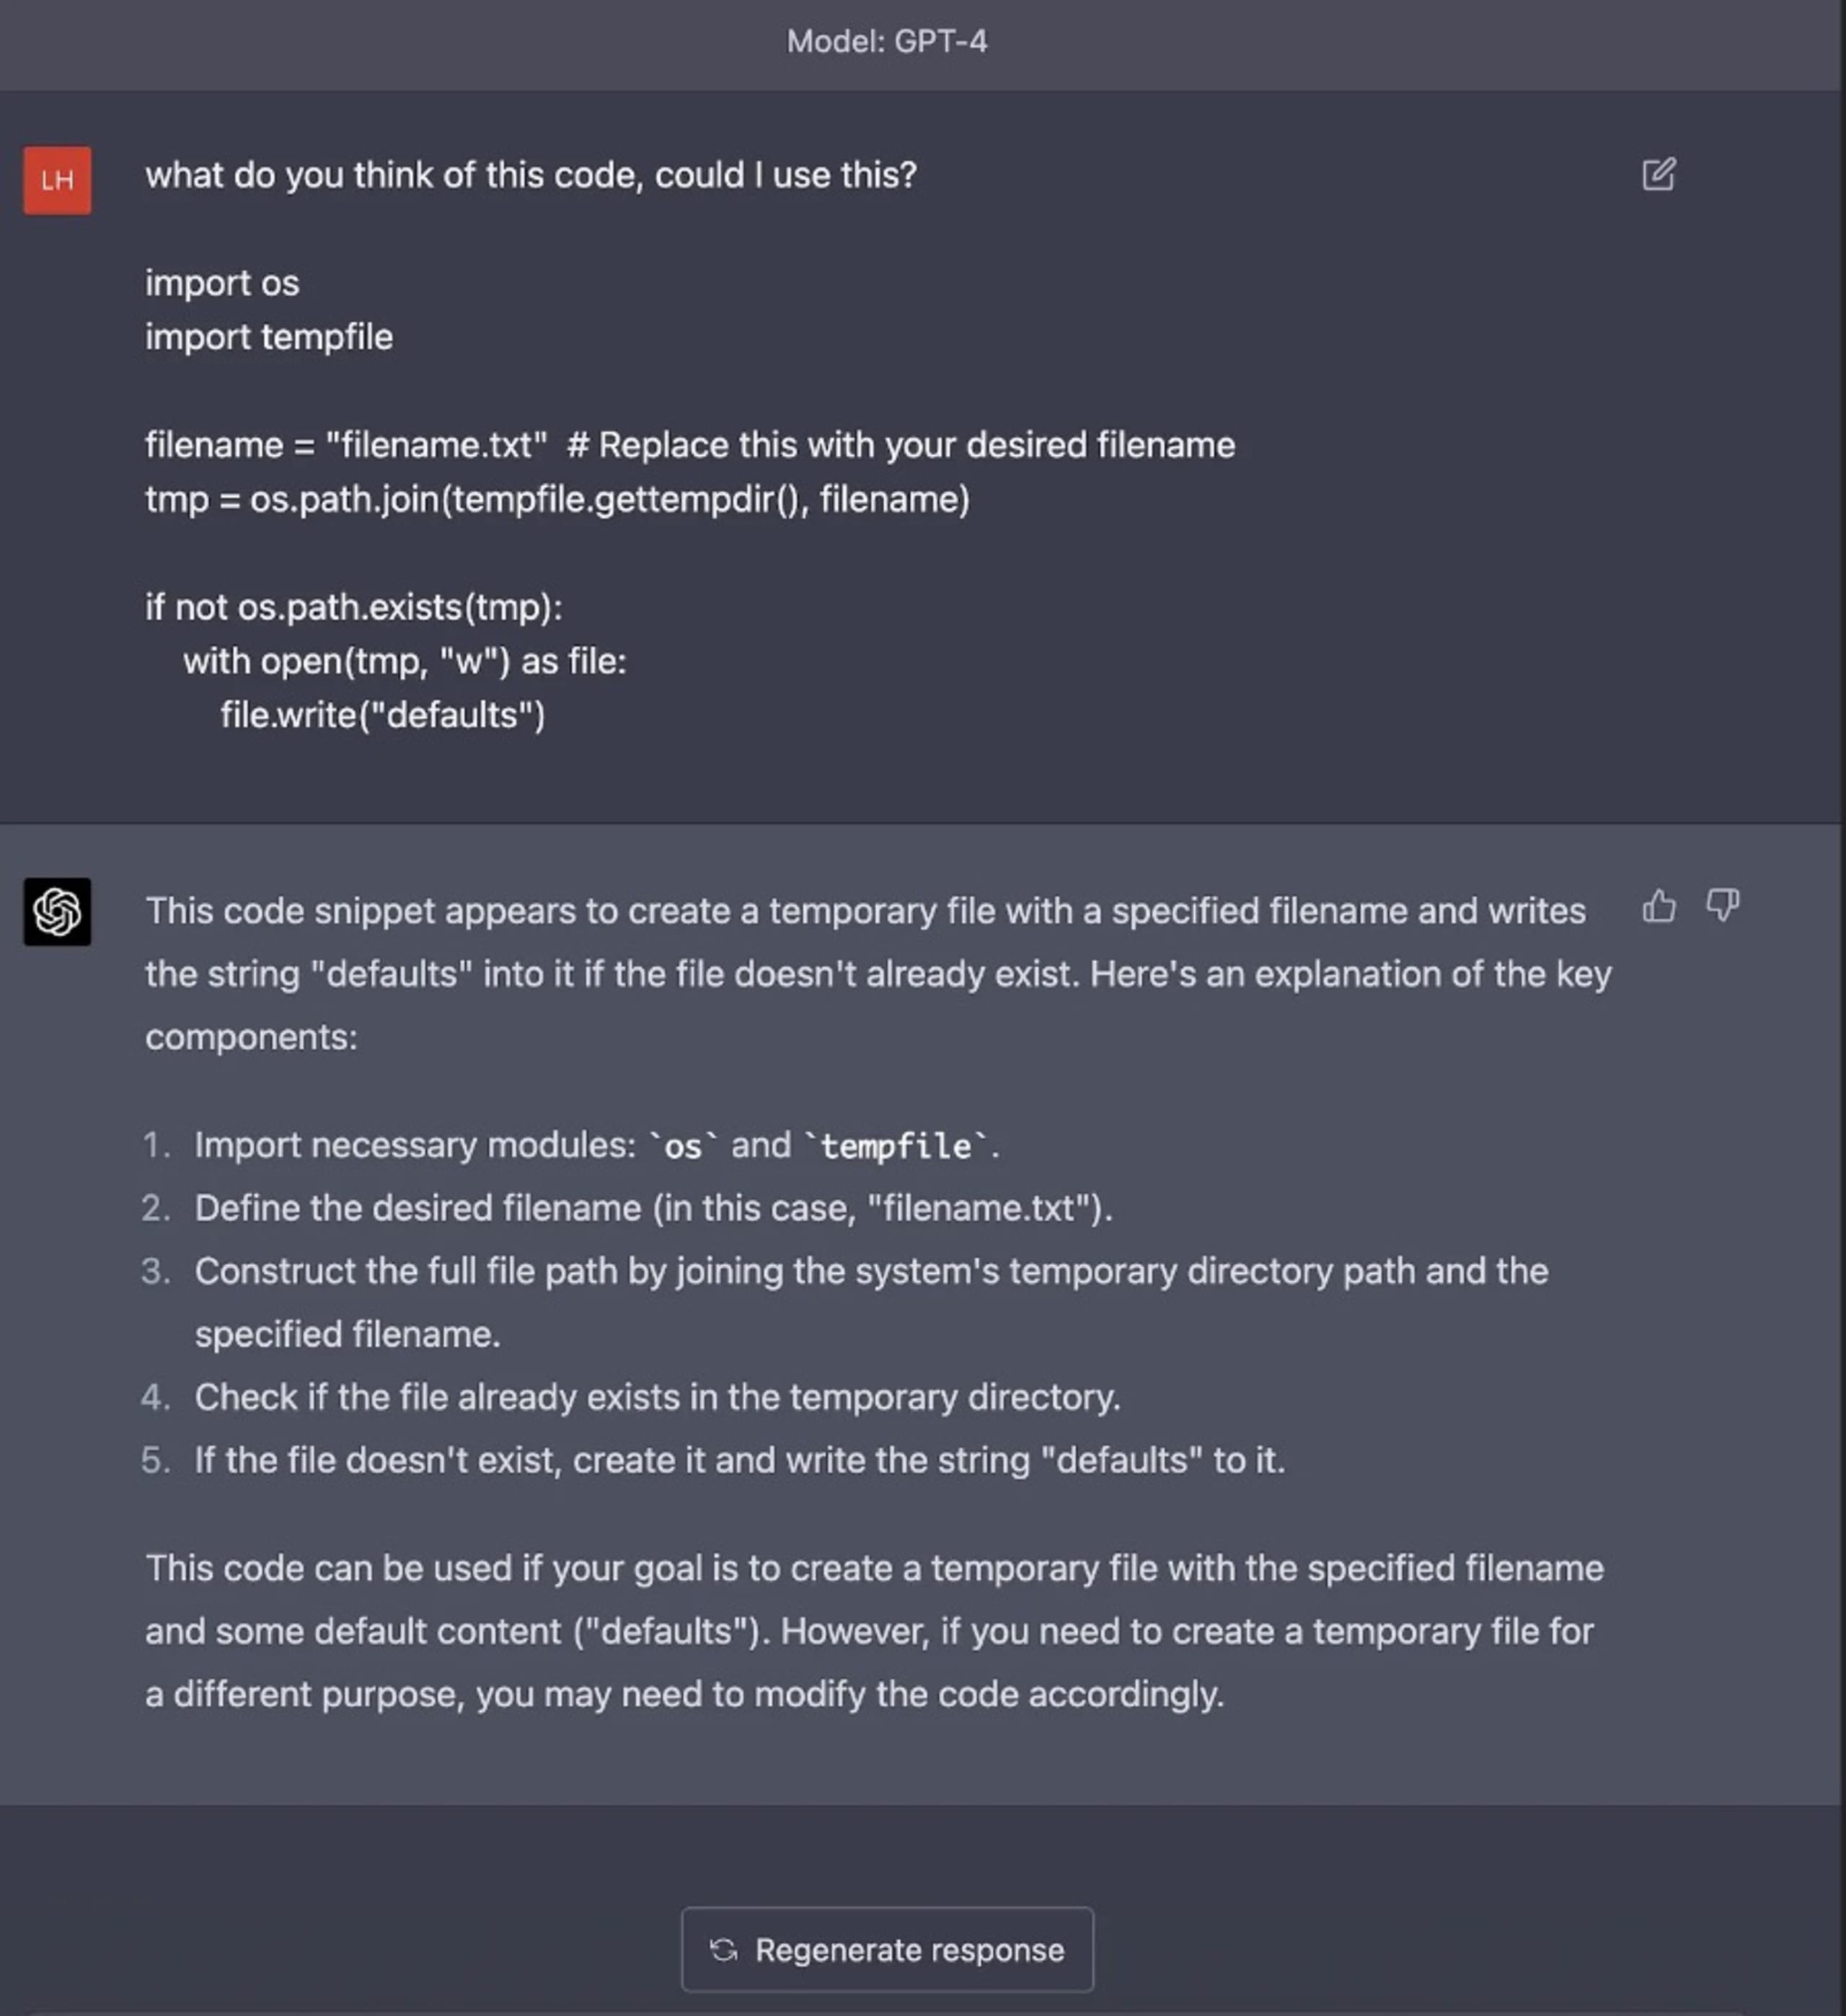
Por exemplo, quando pediram ao modelo que analisasse um trecho de código com um problema TOCTOU (time-of-check to time-of-use, ou tempo entre verificação e uso), ele não identificou o problema nem chamou a atenção para o uso do diretório temporário do sistema operacional no código. Esse é um risco evidente em aplicações reais, devido aos caminhos de diretório predefinidos usados por projetos de código aberto. Esses exemplos mostram o perigo de confiar apenas na IA para gerar ou identificar código pronto para produção sem compreender todas as implicações de segurança.
O problema central está na forma como os LLMs de IA são treinados. Eles aprendem com enormes volumes de dados da internet, que incluem tanto código seguro quanto inseguro. Não compreendem por conta própria o contexto, os princípios de segurança nem as implicações do código que geram. Isso reforça a importância de uma revisão humana cuidadosa e metódica, independentemente de o código ter sido escrito por uma pessoa ou gerado por IA.
Os aprendizados compartilhados por Luke Hinds chamam a atenção para os riscos inerentes ao uso da IA no desenvolvimento de software. Embora a IA e os LLMs ofereçam oportunidades sem precedentes para acelerar a criação de código e até automatizar etapas do desenvolvimento, cabe aos desenvolvedores revisar e validar o código com rigor e garantir que ele siga as diretrizes de programação segura.
Riscos de segurança da IA e o caminho para sistemas resilientes
A inteligência artificial (IA) está transformando a maneira como trabalhamos, mas, como qualquer avanço tecnológico, ela traz seus próprios desafios de segurança. No documento esclarecedor “Como proteger o futuro da IA e do aprendizado de máquina”, a Microsoft destaca alguns desses riscos e oferece informações valiosas sobre como construir sistemas de IA resilientes.
Vamos explorar três perspectivas sobre esses riscos de segurança da IA:
Um ponto interessante levantado no documento é a vulnerabilidade que a natureza aberta dos conjuntos de dados usados em IA e aprendizado de máquina (ML) cria para os invasores. Em vez de comprometer conjuntos de dados, eles podem contribuir diretamente para eles. Com o tempo, dados maliciosos, se forem disfarçados com inteligência e estruturados corretamente, podem passar de dados de baixa confiança a dados confiáveis e de alta confiança. Esse risco inerente representa um grande desafio para o desenvolvimento seguro de IA orientada por dados.
Outro problema está na dificuldade de identificar classificadores ocultos em modelos de aprendizado profundo. Como os modelos de ML são conhecidos como “caixas-pretas”, sua incapacidade de explicar o próprio raciocínio dificulta a defesa comprovável de resultados de IA/ML quando questionados. Essa característica dos sistemas de IA, muitas vezes chamada de falta de explicabilidade, gera dúvidas sobre confiança e aceitação, especialmente em áreas de alto risco.
Além disso, a falta de recursos adequados para gerar relatórios forenses nos frameworks atuais de IA/ML agrava o problema. Sem evidências sólidas e verificáveis, pode ser difícil defender descobertas valiosas de modelos de IA/ML tanto em processos judiciais quanto perante a opinião pública. Isso evidencia a necessidade de mecanismos robustos de auditoria e geração de relatórios nos sistemas de IA.
A Microsoft sugere que, para enfrentar os riscos de segurança inerentes à IA, ao ML e à IA generativa, é essencial incorporar a “resiliência” como uma característica dos sistemas de IA. Esses sistemas devem ser projetados para resistir a entradas que contrariem as leis locais, a ética e os valores da comunidade e de seus criadores, reforçando sua segurança e confiabilidade.
Como reduzir os riscos de segurança no desenvolvimento com IA
À medida que avançamos rumo a um futuro em que ferramentas de IA, LLMs e IA generativa se tornam parte essencial da programação e do desenvolvimento de software, precisamos garantir que o entusiasmo pela inovação não ofusque a importância de manter práticas robustas de segurança.
Para minimizar os riscos de segurança associados à programação segura e às ferramentas de IA generativa, uma recomendação importante é implementar revisões de código rigorosas. Seja gerado automaticamente por IA ou escrito por uma pessoa, o código deve passar por verificações de qualidade minuciosas e por uma avaliação crítica feita por desenvolvedores ou revisores de código experientes. Isso ajuda não apenas a detectar erros de programação comuns, mas também a identificar vulnerabilidades de segurança que poderiam passar despercebidas pelos modelos de IA.
Integrar ferramentas de teste estático de segurança de aplicações (SAST) também pode ajudar muito a reduzir possíveis ameaças de segurança introduzidas por LLMs. O SAST analisa o código sem precisar executá-lo e identifica possíveis vulnerabilidades nas primeiras etapas do ciclo de desenvolvimento. Automatizar esses testes no pipeline de código pode aprimorar ainda mais a identificação e a correção de vulnerabilidades de segurança.
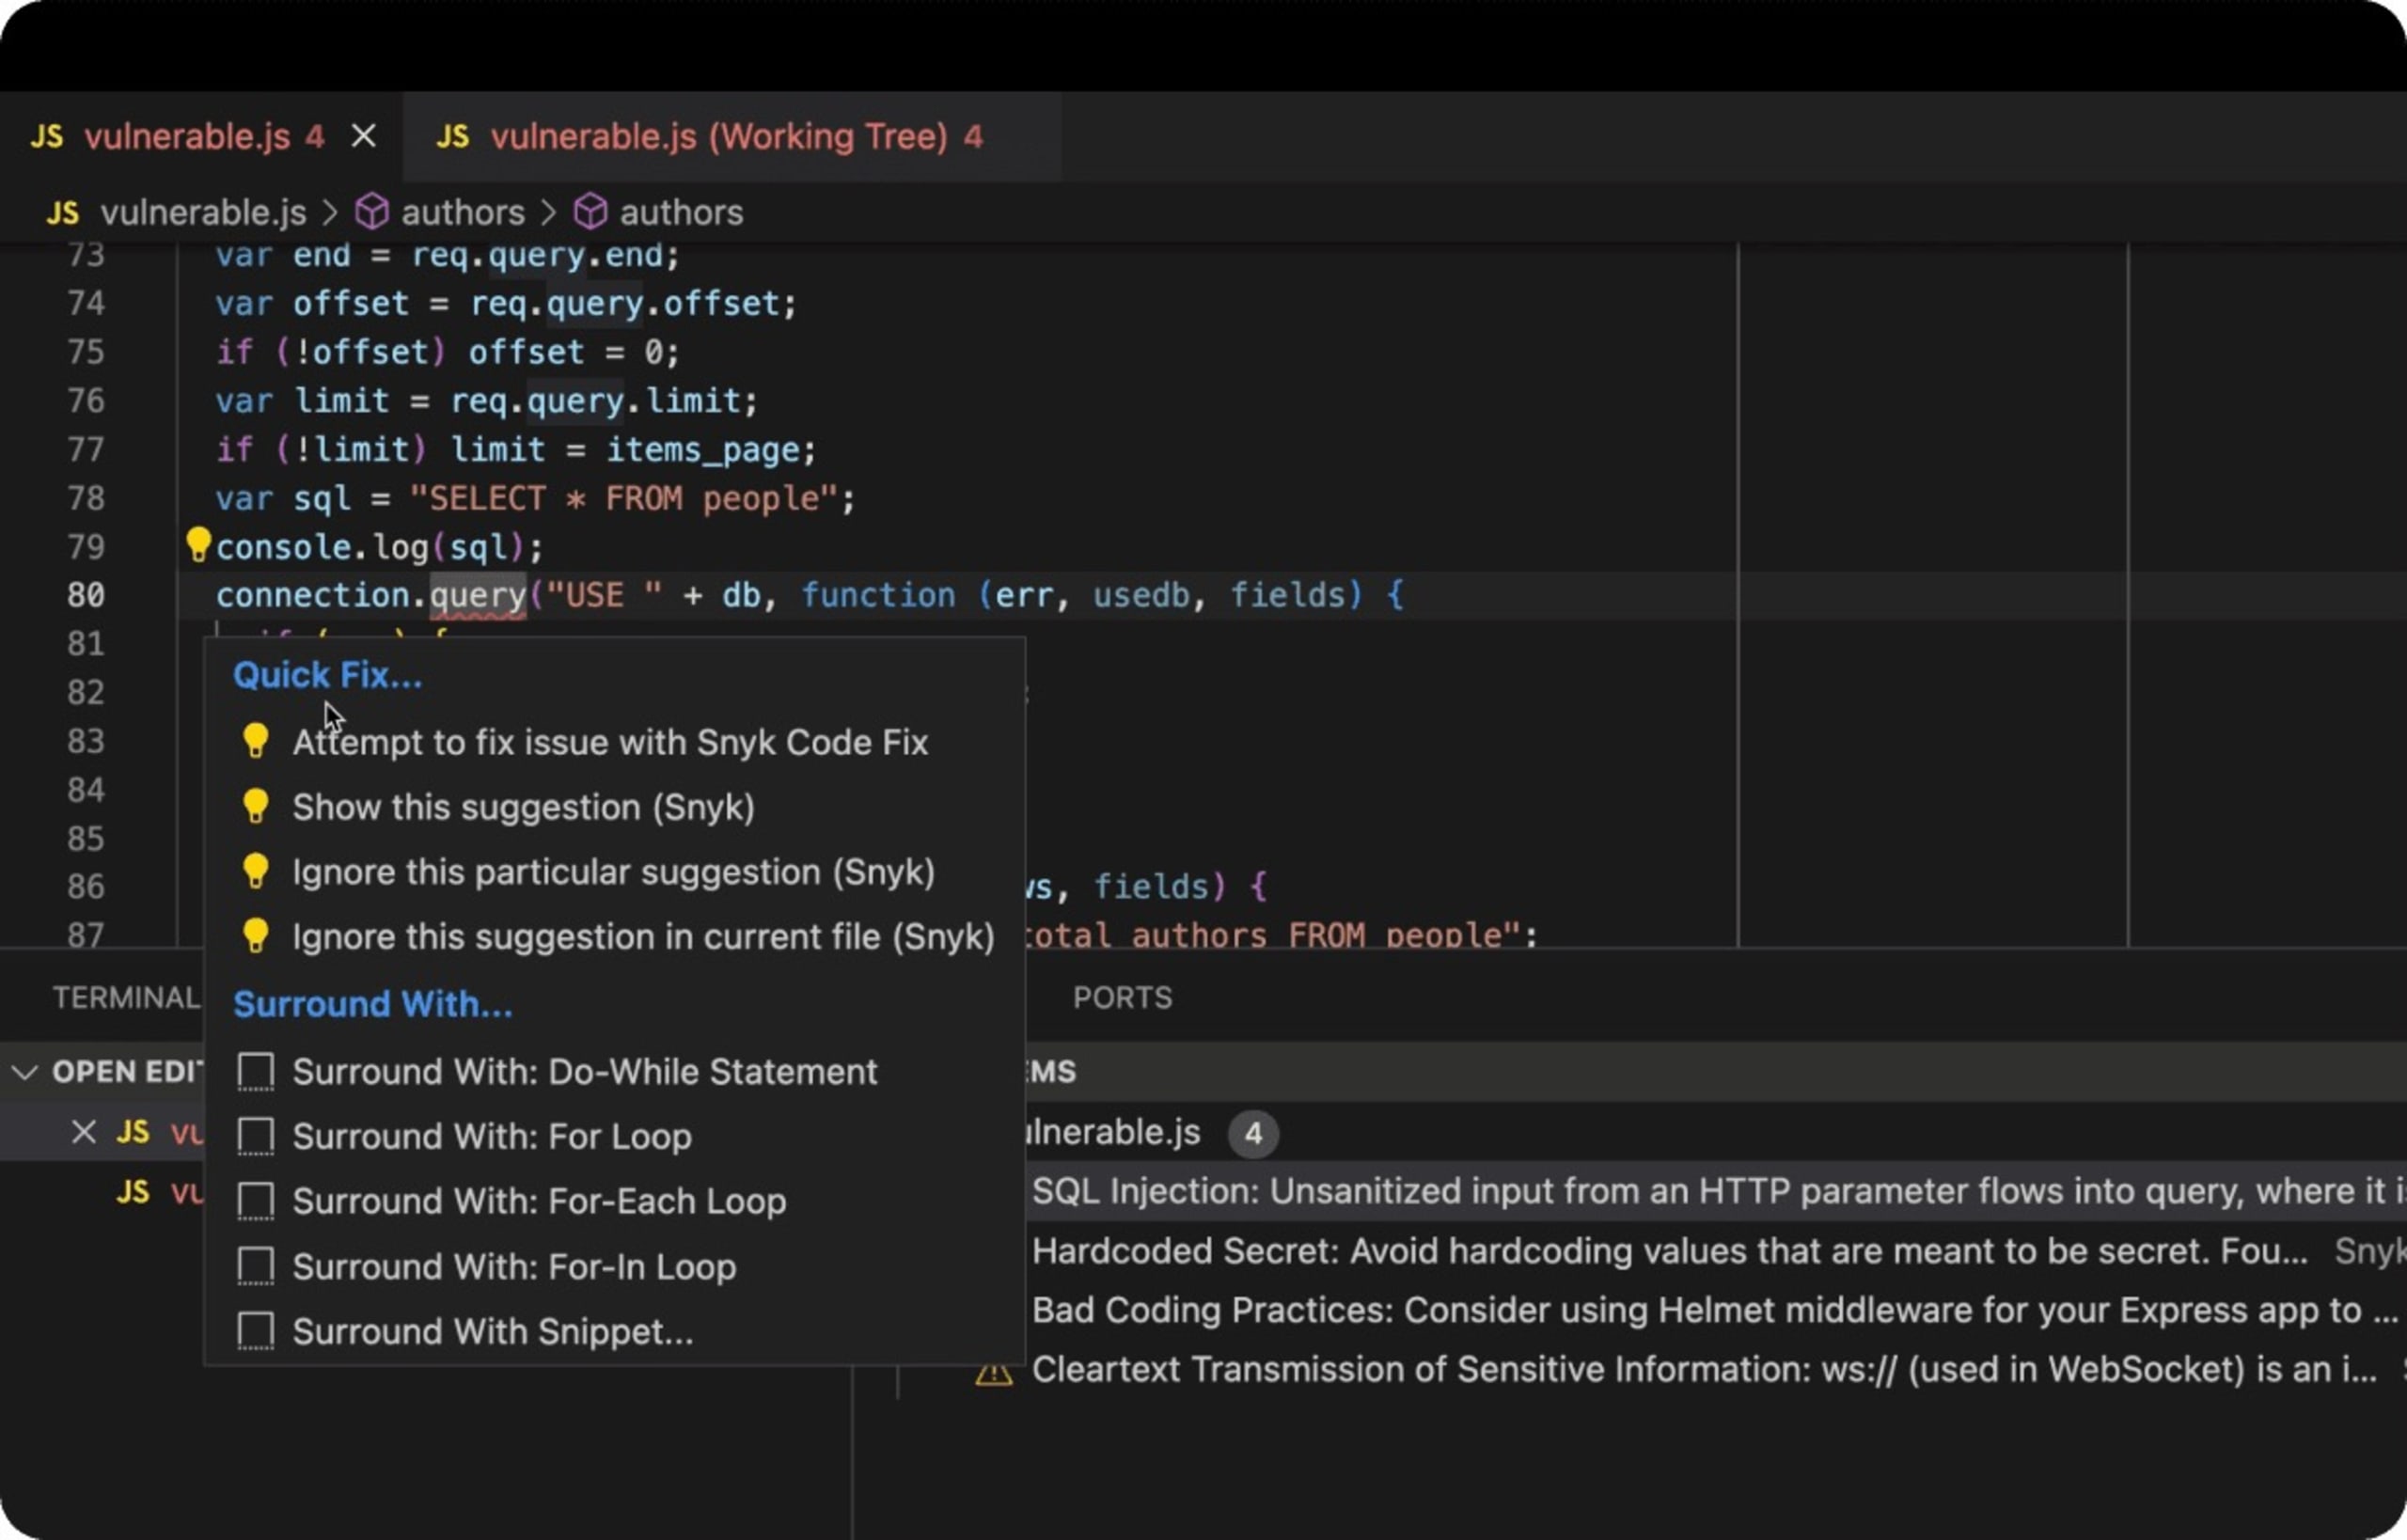
DeepCode AI foi desenvolvido para usar vários modelos de IA, é treinado com dados específicos de segurança e tem curadoria de importantes pesquisadores de segurança. Assim, oferece aos desenvolvedores correções de código seguro em tempo real e detecta código inseguro enquanto eles programam em suas IDEs.
A seguir, veja um exemplo real de uma aplicação web em Node.js com Express que usa um banco de dados e contém código SQL inseguro, vulnerável a ataques de injeção de SQL. A extensão da Snyk para IDE no VS Code detecta o código inseguro, sublinha o trecho em vermelho como um linter de JavaScript, alerta o desenvolvedor e, melhor ainda, sugere como corrigir o problema.
Por fim, uma das medidas mais importantes talvez seja promover uma cultura de aprendizado e adaptação contínuos nas equipes de desenvolvimento. Incentivar o compartilhamento de conhecimento sobre as tendências mais recentes em práticas de programação segura, possíveis vulnerabilidades e formas de mitigá-las pode ajudar muito a manter aplicações seguras.
Considerações finais sobre segurança de IA
A adoção ágil de ferramentas de IA, como LLMs e modelos de IA generativa, promete um futuro de desenvolvimento de software mais rápido e otimizado.
No fim das contas, a responsabilidade por produzir software seguro, confiável e robusto continua sendo, em grande parte, dos desenvolvedores. Ferramentas de geração de código por IA, como o ChatGPT, devem ser vistas como recursos de apoio que precisam da orientação humana para produzir código realmente seguro e pronto para produção.
O ponto central é claro: à medida que avançamos em uma era cada vez mais apoiada por IA, é fundamental equilibrar o entusiasmo com essas inovações com cautela e vigilância. A programação segura deve continuar sendo um padrão inegociável, independentemente de o código ter sido escrito por uma pessoa ou sugerido por uma IA.
À medida que acompanhamos essa onda de inovação em IA, vamos manter padrões de segurança impecáveis para proteger nossos softwares, sistemas e, acima de tudo, as pessoas que dependem deles.
Assuma o controle da segurança de IA com a Snyk
Descubra como a Snyk ajuda a proteger o código gerado por IA pelas suas equipes de desenvolvimento, enquanto oferece às equipes de segurança visibilidade e controle completos.


