Se eliminó la regla de correo electrónico de Ruby de Snyk Code
Frank Fischer
13 de octubre de 2022
0 minutos de lecturaSnyk Code admite varios lenguajes importantes en el ámbito cloud native, entre ellos Ruby (y hemos visto una gran adopción, ¡gracias!). Nuestros investigadores monitorean constantemente nuestros conjuntos de reglas, usando nuestro conjunto de entrenamiento de proyectos de código abierto, pero también —y sí, esta es una ventaja de un servicio SaaS— observando cómo funcionan las reglas con el código que se analiza. Como recordatorio, Snyk no usa tu código para entrenar nuestros conjuntos, pero sí agregamos estadísticas de uso.
En los datos de Ruby, vimos un caso atípico (sobre el que también recibimos comentarios de los usuarios):
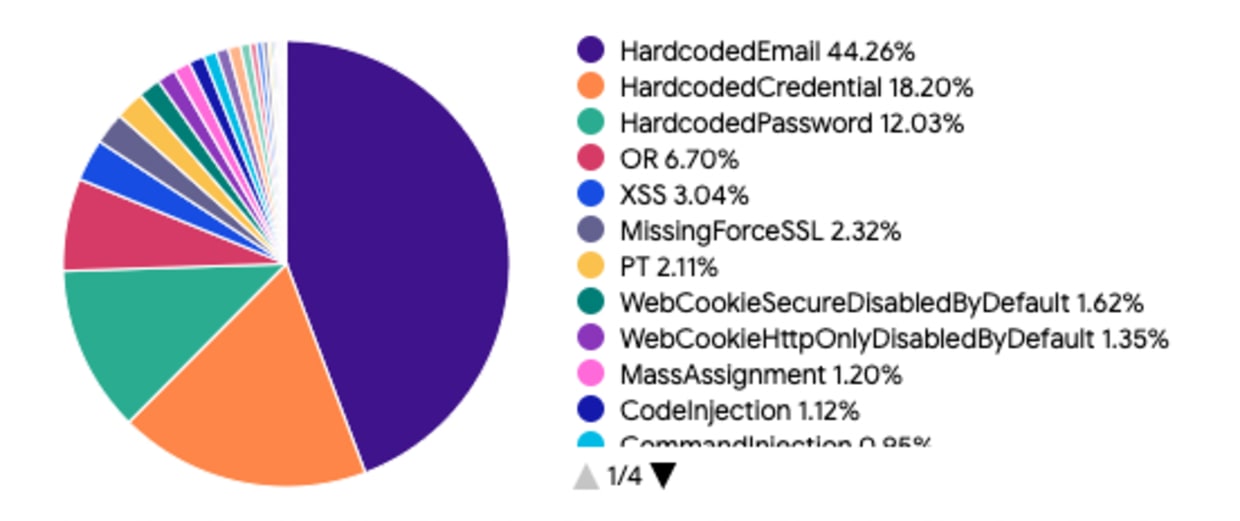
Por qué eliminamos la regla HardcodedEmail para Ruby
Teníamos una regla que buscaba direcciones de correo electrónico en el código Ruby y las marcaba como un posible problema de prioridad baja. Aunque sigue siendo una buena práctica no almacenar correos electrónicos codificados directamente en el código, vimos que esta regla generaba problemas que a menudo se ignoraban o no se resolvían. Analizamos los datos con más detalle y pareció que no había ninguna relación entre el ruido generado y el uso de la recomendación, así que decidimos eliminar la regla. Tenemos otras reglas que usan el flujo de datos para encontrar credenciales o contraseñas mal utilizadas, así que seguimos cubriendo muy bien ese aspecto.
¿Qué significa esto para ti? Si usas Ruby, pronto verás menos hallazgos de prioridad baja relacionados con direcciones de correo electrónico.
¿Qué enseñanza podemos extraer más allá de la regla de Ruby?
Todas las herramientas de pruebas de seguridad de aplicaciones estáticas (SAST) —y, en general, las herramientas de análisis estático de código— deben mantener un equilibrio entre la precisión (identificar solo los problemas verdaderos, pero pasar por alto algunos) y la exhaustividad (identificar cualquier posible problema, pero generar mucho ruido con falsos positivos). Gracias a la velocidad de Snyk Code, contamos con la enorme ventaja de poder usar entre 120 000 y 150 000 proyectos por lenguaje como conjunto de prueba para ayudarnos a mantener ese equilibrio entre precisión y exhaustividad.
Además, contamos con datos de uso de la aplicación de Snyk. Los usamos para optimizar el sistema desde el principio y seguimos optimizándolo. Esto se debe a varios motivos:
El entorno cambia constantemente: JavaScript es muy conocido por tener una nueva biblioteca de moda cada dos semanas. Pero, dejando las bromas de lado, todos los entornos de programación agregan constantemente bibliotecas nuevas o modifican las existentes. Usamos aprendizaje automático para aprender los cambios automáticamente y agregarlos a nuestra base de conocimientos.
Algunas buenas prácticas no se siguen realmente: Aunque una buena práctica es no incluir correos electrónicos codificados directamente en el código, debemos aceptar que la realidad puede ser distinta y que hay buenas razones para desviarse de ella.
Surgen nuevos tipos de problemas: ¿Recuerdas Trojan Source? Era un tipo de problema totalmente nuevo, nunca antes visto. En unos pocos días, el equipo de Snyk Code pudo ofrecer reglas para detectarlo —en todos los lenguajes de programación compatibles— con un alto nivel de precisión.
Gracias por sus comentarios y sugerencias para mejorar el producto. Además de las decisiones basadas en datos, son una valiosa fuente de información para nosotros. Escuchamos y respondemos. Si aún no has usado Snyk Code, quizás este sea un buen momento para empezar. Solo crea una cuenta gratuita de Snyk y obtén resultados en segundos.
Prueba nuestra herramienta gratuita verificador de código Ruby para ver cómo el motor de Snyk Code analiza tu código en busca de problemas de seguridad y calidad.
Comienza con Capture the Flag
Aprende a resolver desafíos de Capture the Flag con nuestro taller virtual 101 a pedido.


