3 consejos para reconstruir una imagen de Docker más rápido (¡y ahorrar segundos de CI!)

28 de diciembre de 2023
0 minutos de lecturaDocker se ha convertido en una herramienta invaluable que simplifica el proceso de crear, distribuir y ejecutar aplicaciones. Docker permite a los desarrolladores empaquetar una aplicación con todas sus dependencias en una unidad estandarizada conocida como imagen de contenedor.
Este Dockerfile es un documento sencillo que contiene todos los comandos necesarios para crear una imagen de contenedor. A su vez, esta imagen será la base de un contenedor de Docker cuando se ejecute.
Estos contenedores son paquetes independientes, ejecutables y livianos que incluyen todo lo necesario para ejecutar un componente de software, como el código, las herramientas del sistema, las bibliotecas y la configuración.
La ventaja de los contenedores es su portabilidad. Garantizan que la aplicación se ejecute sin problemas, independientemente del entorno en el que se implemente. Esto ha agilizado significativamente el proceso de desarrollo de software y se ha convertido en un pilar del enfoque DevOps, que permite la integración y la implementación continuas.
La necesidad de crear imágenes de Docker más rápido
Aunque las imágenes de contenedor son fundamentales para ejecutar aplicaciones en distintos entornos, crearlas puede llevar mucho tiempo. Esto es especialmente cierto en el caso de las aplicaciones grandes con muchas dependencias.
En el ejemplo anterior, Docker lee el Dockerfile del directorio actual y crea una imagen llamada my-application. Según la complejidad y el tamaño de la aplicación, esto puede llevar bastante tiempo.
El arte de crear imágenes de Docker
Crear imágenes de Docker es una parte fundamental del trabajo con contenedores. En esencia, las imágenes de Docker son una «instantánea» de un contenedor de Docker en un momento determinado y sirven de base para crear contenedores de Docker nuevos.
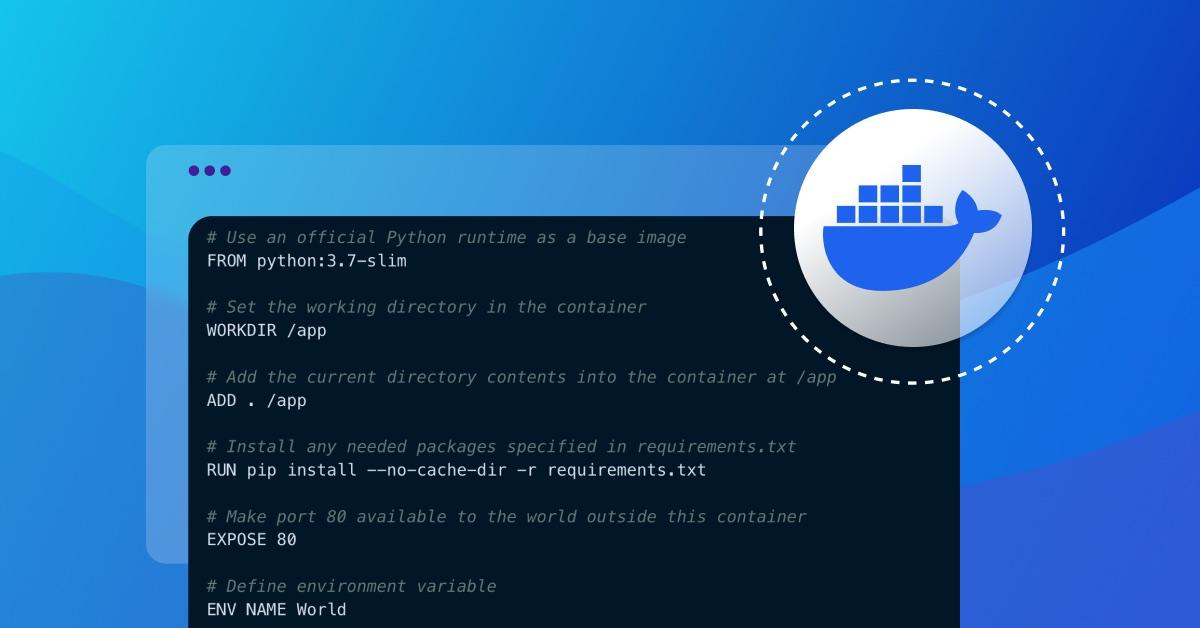
Para crear una imagen de Docker, se necesita un Dockerfile, un archivo de texto que contiene todos los comandos necesarios para crear una imagen. Un Dockerfile es como una receta: le indica a Docker qué hacer cuando quieres crear una imagen.
Este es un ejemplo de un Dockerfile sencillo:
Una vez que tengas un Dockerfile, puedes usar el comando docker build para crear una imagen. Se vería así:
Este comando le indica a Docker que cree una imagen con el Dockerfile del directorio actual (el . al final del comando) y que le asigne la etiqueta (-t) my-python-app.
Nota: Si desarrollas en Python o formas parte de un equipo de DevOps que crea contenedores para aplicaciones de Python, te recomiendo revisar y aplicar las prácticas recomendadas para contenerizar aplicaciones de Python con Docker.
Desafíos comunes al crear imágenes de Docker
Crear imágenes de Docker no siempre es sencillo. Los desarrolladores y los equipos de DevOps pueden enfrentarse a varios desafíos comunes:
Administración de dependencias: Uno de los desafíos más comunes es administrar las dependencias. Las dependencias de tu aplicación pueden cambiar con el tiempo y puede ser difícil mantener actualizada la imagen de Docker. Para resolverlo, puede ser útil usar un administrador de paquetes que gestione las dependencias automáticamente.
Tamaño de la imagen: Otro desafío es mantener las imágenes de Docker lo más pequeñas posible. Las imágenes grandes tardan más en crearse y subirse a un repositorio de Docker, lo que puede ralentizar tu pipeline de CI/CD. Para reducir el tamaño de las imágenes, puedes usar una imagen base más pequeña, eliminar archivos innecesarios y usar compilaciones de varias etapas para minimizar el contenido de la imagen final.
Seguridad: La seguridad es una preocupación importante al crear imágenes de Docker. Debes asegurarte de que tus imágenes no contengan vulnerabilidades que los atacantes puedan aprovechar. Para ayudar con esto, puedes usar herramientas como Docker Bench for Security y Snyk Container para analizar tus imágenes en busca de vulnerabilidades.
Consejo 1: Agrega un archivo .dockerignore a tu repositorio
En el mundo de Docker y la seguridad de los contenedores, la eficiencia es fundamental. Si eres desarrollador o profesional de DevOps, sabes que cada segundo cuenta en los procesos de integración continua (CI).
Una forma sencilla pero eficaz de acelerar la creación de imágenes de Docker es agregar un archivo .dockerignore a tu repositorio. Veamos cómo funciona un archivo .dockerignore, cómo puede acelerar la creación de imágenes de Docker y exploremos una guía paso a paso para agregar un archivo .dockerignore a un repositorio.
¿Qué es un archivo .dockerignore?
Al igual que un archivo .dockerignore, un archivo .gitignore es un archivo de texto que especifica un patrón de archivos y directorios que Docker debe ignorar al crear una imagen a partir de un Dockerfile. Es decir, le indica a Docker qué archivos o directorios debe omitir durante la compilación.
El fragmento de código anterior muestra un ejemplo de archivo .dockerignore que le indica a Docker que ignore el directorio node_modules, todos los archivos npm-debug.log, cualquier Dockerfile (sin importar la extensión) y todos los archivos Markdown.
¿Cómo puede un archivo .dockerignore acelerar la creación de imágenes de Docker?
Cuando Docker crea una imagen a partir de un Dockerfile, envía todo el contexto de compilación (es decir, el directorio actual y sus subdirectorios) al daemon de Docker. Sin un archivo .dockerignore, el daemon de Docker recibe archivos y directorios innecesarios, lo que puede aumentar considerablemente el tiempo de compilación.
Al agregar un archivo .dockerignore a tu repositorio, le indicas a Docker que omita los archivos y directorios innecesarios, lo que reduce el tamaño del contexto de compilación. Como resultado, Docker puede crear imágenes más rápido y ahorrarte valiosos segundos de CI.
Guía paso a paso para agregar un archivo .dockerignore a un repositorio
Así puedes agregar un archivo .dockerignore a tu repositorio:
1. Crea un archivo nuevo llamado .dockerignore en el directorio raíz de tu repositorio.
2. Abre el archivo .dockerignore que acabas de crear con tu editor de texto favorito.
3. Agrega patrones para los archivos y directorios que se deben ignorar al crear la imagen de Docker. Por ejemplo, puedes ignorar todos los archivos de registro y el directorio node_modules, como se muestra a continuación:
4. Guarda y cierra el archivo .dockerignore. La próxima vez que crees una imagen de Docker desde este repositorio, Docker ignorará los archivos y directorios especificados, ¡y la imagen se creará más rápido!
Un archivo .dockerignore es una herramienta sencilla pero potente que puede reducir considerablemente el tiempo que lleva crear imágenes de Docker. Al agregarlo a tus repositorios, puedes hacer que tus procesos de Docker y CI sean más eficientes y seguros.
Consejo 2: Usa un archivo de bloqueo de dependencias
Un archivo de bloqueo de dependencias es una herramienta fundamental para lograr compilaciones de Docker más rápidas y deterministas. Fija las versiones de las dependencias de tu proyecto para garantizar que todas las compilaciones futuras usen exactamente las mismas versiones. Esto no solo acelera las compilaciones, sino que también mejora la confiabilidad y la seguridad de tus imágenes de Docker.
¿Qué es un archivo de bloqueo de dependencias y por qué es importante?
Un archivo de bloqueo de dependencias es un archivo que genera tu administrador de paquetes y que describe las versiones exactas y las dependencias de tu proyecto en un momento determinado. Es como una instantánea de las dependencias del proyecto. En Docker, registra las versiones de software que se usaron para crear una imagen de Docker específica.
El archivo de bloqueo es fundamental por varios motivos. Garantiza que las compilaciones de Docker sean deterministas y repetibles. Esto significa que obtendrás el mismo resultado cada vez que crees una imagen de Docker. Esto es fundamental para la depuración y el cumplimiento de los requisitos de seguridad, ya que te permite saber siempre exactamente qué contiene tu imagen de Docker.
Además, un archivo de bloqueo de dependencias puede acelerar considerablemente las compilaciones de Docker. Como el archivo contiene las versiones exactas de las dependencias, Docker puede almacenar en caché estas capas y omitir el paso de instalación en las compilaciones futuras, lo que reduce el tiempo de compilación.
Cómo un archivo de bloqueo de dependencias permite compilaciones más rápidas y deterministas
Veamos un Dockerfile sencillo sin un archivo de bloqueo:
Cada vez que ejecutamos una compilación, npm install obtiene las versiones más recientes de las dependencias definidas en package.json. Este proceso lleva tiempo y hace que nuestras compilaciones no sean deterministas, ya que las dependencias instaladas pueden variar de una compilación a otra.
Nota: Si estás creando aplicaciones de Node.js con Docker, te recomiendo revisar las 10 prácticas recomendadas para contenerizar aplicaciones web de Node.js con Docker.
Ahora, usemos un archivo de bloqueo:
Aquí copiamos package-lock.json a la imagen de Docker y usamos npm ci en lugar de npm install. El comando npm ci usa el archivo de bloqueo para instalar las versiones exactas de las dependencias, lo que garantiza compilaciones deterministas y permite que Docker almacene en caché la capa de dependencias para acelerar las compilaciones.
Cómo usar un archivo de bloqueo de dependencias en Docker
Para usar un archivo de bloqueo de dependencias en Docker, debes asegurarte de que esté incluido en el contexto de compilación de Docker. Puedes hacerlo copiándolo a tu imagen de Docker con el comando COPY en tu Dockerfile.
Este es un ejemplo con un proyecto de Python que usa Pipfile.lock:
En este Dockerfile, copiamos Pipfile y Pipfile.lock a la imagen de Docker. Luego usamos pipenv install --system --deploy para instalar las versiones exactas de las dependencias definidas en Pipfile.lock. Esto permite compilaciones deterministas y optimiza el rendimiento al aprovechar el mecanismo de caché de Docker.
Un archivo de bloqueo de dependencias es una herramienta fundamental para lograr compilaciones de Docker más rápidas y deterministas. No solo mantiene la coherencia y la confiabilidad de tus imágenes de Docker, sino que también mejora su seguridad, ya que te permite saber siempre qué versiones de software contienen.
Consejo 3: Agrupa los comandos según la probabilidad de que cambien
Las prácticas eficientes mejoran la seguridad de los contenedores y el desarrollo de software, y la creación de imágenes de Docker no es la excepción. Una de estas prácticas consiste en agrupar los comandos según la probabilidad de que cambien. Este método puede ayudarte a ahorrar mucho tiempo y recursos al reconstruir imágenes de Docker. Veamos cómo funciona.
El principio de agrupar comandos en Docker
En Docker, cada comando que escribes en un Dockerfile crea una nueva capa en la imagen de Docker. Docker usa un mecanismo de caché para estas capas y así acelerar el proceso de creación de imágenes.
Cuando Docker crea una imagen, procesa cada comando línea por línea. Si un comando no cambió desde la última compilación, Docker usa la capa almacenada en caché en lugar de volver a ejecutarlo, lo que reduce considerablemente el tiempo de compilación.
Sin embargo, si cambia una sola línea, Docker no puede usar la caché para esa línea ni para las que vienen después. Por lo tanto, si una línea que cambia con frecuencia está al principio del Dockerfile, la caché no se usará de forma eficaz y Docker tendrá que reconstruir la mayor parte de la imagen cada vez. Aquí es donde entra en juego la agrupación de comandos.
Reconstruye imágenes de Docker más rápido agrupando comandos
Si agrupas los comandos y los organizas según la probabilidad de que cambien, puedes optimizar el uso de la caché de Docker y acelerar considerablemente el proceso de reconstrucción de imágenes.
En esencia, debes estructurar tu Dockerfile de modo que los comandos que cambian con frecuencia queden al final. Así, Docker puede usar las capas almacenadas en caché para los comandos que no cambian o que se actualizan con menos frecuencia, y solo tendrá que reconstruir las capas correspondientes a los comandos que cambiaron.
Coloca al principio los comandos con menos probabilidades de cambiar
Otro consejo relacionado que te permitirá reconstruir imágenes de Docker más rápido es colocar al principio del Dockerfile los comandos con menos probabilidades de cambiar, para aprovechar mejor el mecanismo de caché de Docker.
En un Dockerfile, cada comando que escribes crea una nueva capa en la imagen de Docker. Estas capas se apilan unas sobre otras y forman la imagen final de Docker. Docker usa un mecanismo de caché para estas capas que acelera la creación de imágenes. Si una capa no ha cambiado (es decir, el comando es el mismo que en compilaciones anteriores), Docker usa la versión en caché en lugar de volver a crearla.
El inconveniente es que Docker invalida la caché de una capa si cambia alguna de las capas de las que depende. Esto significa que, si modificas un comando al principio de tu Dockerfile, se volverán a crear todas las capas que están debajo, aunque sus comandos no hayan cambiado.
Si colocas al principio de tu Dockerfile los comandos con menos probabilidades de cambiar, puedes asegurarte de que Docker use la caché de esas capas en la mayoría de tus compilaciones. Este enfoque reduce la cantidad de capas que Docker debe volver a crear y, por lo tanto, acelera el proceso de compilación.
Ejemplos prácticos de agrupación de comandos
Veamos un ejemplo de Dockerfile:
En este Dockerfile, es probable que el comando COPY . /app cambie con frecuencia a medida que actualizas el código de tu aplicación. Si mueves este comando y el siguiente, RUN pip3 install -r requirements.txt (que también cambia cada vez que cambia el archivo requirements.txt), al final del Dockerfile, Docker puede usar la caché para el comando RUN apt-get update && apt-get install -y python3 python3-pip, que cambia con menos frecuencia.
El Dockerfile optimizado se vería así:
Al agrupar los comandos según sus probabilidades de cambiar, los desarrolladores y los equipos de DevOps pueden optimizar la reconstrucción de imágenes de Docker, ahorrar segundos de CI y mejorar la seguridad de los contenedores y las prácticas de desarrollo de software.
Conclusión
El beneficio de reconstruir imágenes de Docker más rápido va más allá del tiempo que se ahorra. Influye significativamente en la eficiencia del pipeline de CI y en el proceso general de desarrollo de software.
Un proceso más rápido para crear imágenes de Docker reduce los tiempos de compilación en el pipeline de CI, lo que permite que los desarrolladores reciban comentarios más rápido. Esto acelera el desarrollo de software y permite que los desarrolladores iteren sus cambios con mayor rapidez.
Además, también permite reducir costos, ya que se utilizan menos recursos computacionales en el pipeline de CI. En la computación en la nube, donde los costos suelen estar directamente vinculados al uso de CPU y al tiempo de compilación, acelerar la creación de imágenes de Docker puede generar ahorros considerables con el tiempo.
Por último, también puede mejorar la postura de seguridad general de tu aplicación. Los tiempos de compilación más cortos permiten recibir más rápido comentarios sobre posibles problemas de seguridad en tus imágenes de Docker, lo que facilita su corrección y reduce el período de exposición.
En conclusión, adoptar estas estrategias para reconstruir imágenes de Docker más rápido no es solo algo deseable, sino una necesidad en el acelerado mundo actual del desarrollo de software. Es esencial no solo para aumentar la velocidad y la eficiencia de tu pipeline de CI, sino también para mejorar la seguridad y la rentabilidad de tu proceso de desarrollo de software.
Seguridad de contenedores para DevSecOps
Encuentra y corrige vulnerabilidades en contenedores gratis con Snyk.