Esgotando o tempo de funções síncronas com regex

6 de abril de 2023
0 minutos de leituraQuão difícil pode ser oferecer suporte a tags personalizadas de imagens de contêiner? Acontece que… bem difícil! Sei disso porque minha equipe está trabalhando bastante no novo suporte a imagens base personalizadas para Snyk Container, e recebemos o seguinte desafio: dado um tag, analisar suas partes para compará-lo com outros tags semelhantes. Foi um problema divertido de resolver, e queremos compartilhar como chegamos à solução final!
Regex para o resgate?
Nossa ideia foi usar regex, mais especificamente o recurso de grupos nomeados. Por exemplo, para corresponder a isto:
Poderíamos usar esta regex (pedimos desculpas desde já a quem tem pesadelos ocasionais com regex):
A essa altura, talvez alguns sinais de alerta 🚩 já tenham se acendido para você. Todo mundo sabe que regex pode ser perigosa, e deixar o usuário decidir tanto a string de entrada quanto a regex é praticamente um convite a ataques!
Um usuário poderia facilmente criar uma imagem base chamada:
E nos passar a string:
Isso faria nosso serviço parar completamente de processar qualquer outra solicitação! Nenhuma equipe de AppSec permitiria que alguém fizesse isso.
Isso significa que precisamos voltar à prancheta? Ainda bem que não! Existe uma biblioteca (mecanismo de análise de regex) desenvolvida especificamente para evitar esse tipo de ataque. Ela se chama RE2 e foi desenvolvida pelo Google. Vale lembrar que alguns recursos de regex não são compatíveis, mas, de qualquer forma, não seriam usados.
Agora começa a parte divertida!
Não queríamos depender exclusivamente de uma dependência externa, sujeita a bugs fora do nosso controle e a possíveis ataques à cadeia de suprimentos de software. Por isso, queríamos encontrar uma maneira de limitar o tempo de execução de regex que demora demais.
Como o Node é single-threaded, não é fácil limitar o tempo de execução de código que não pode ser executado simultaneamente. Esta foi a solução que encontramos:
Threads 🧵!
Provavelmente foi a primeira coisa que veio à sua cabeça — também foi a nossa. Além de podermos encerrar uma thread, ainda temos a vantagem de não bloquear o loop de eventos principal!
Certo, vamos escrever um pouco de código:
Thread principal
Script de worker
Parece simples, né? Que tal conferir se o código funciona…
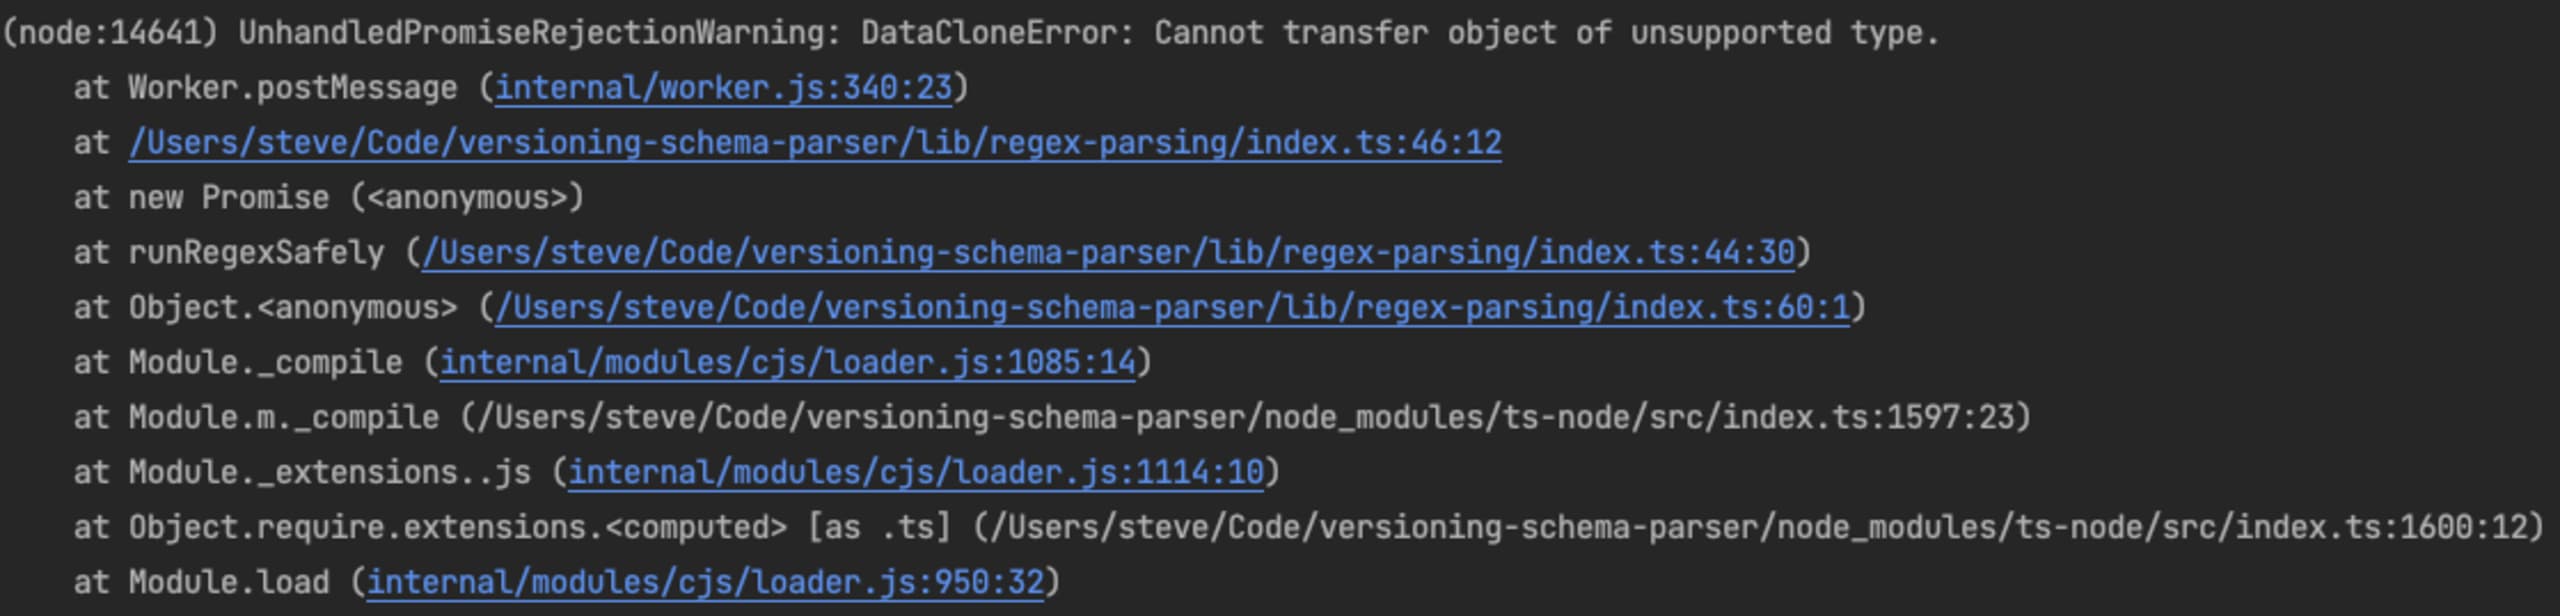
Hmm, nunca vi esse erro antes. Vamos ver o que a MDN diz:
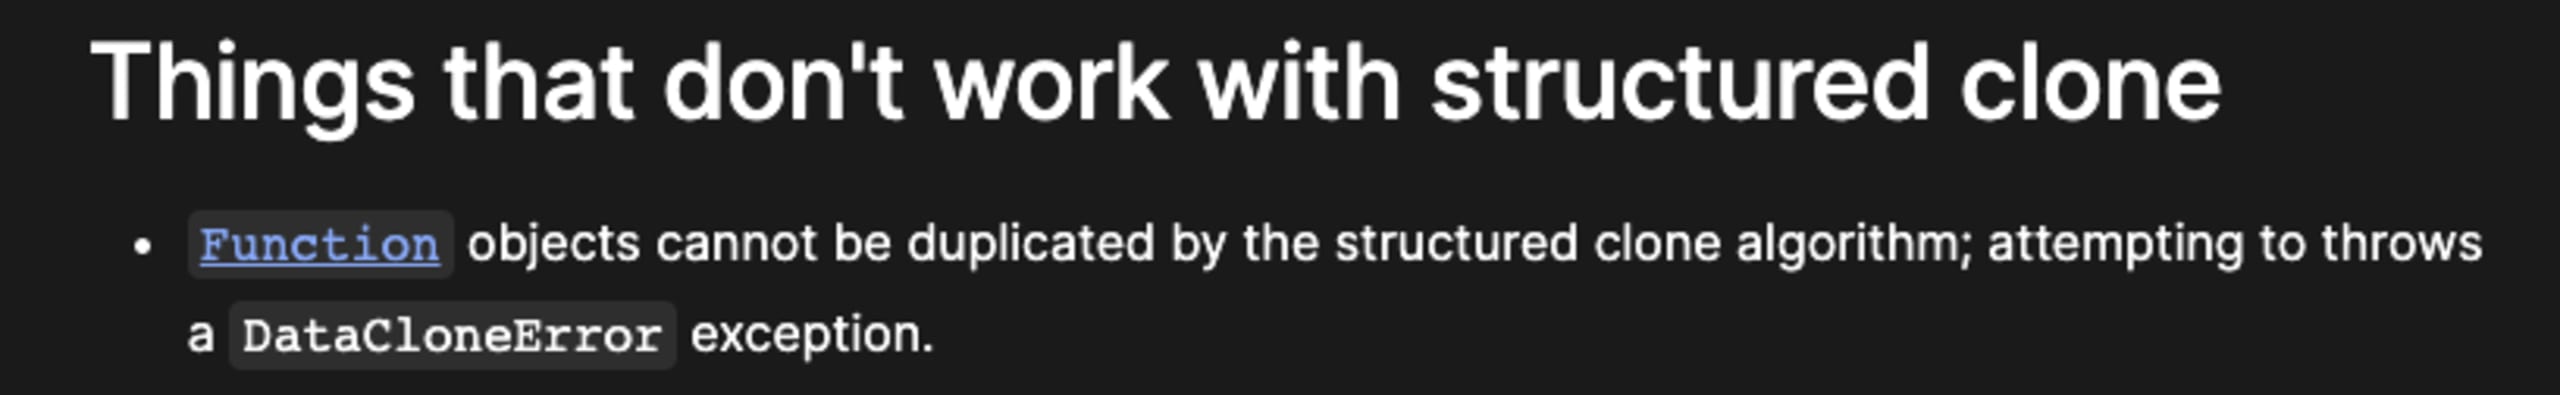
E: may not contain native (C++ backed) objects
Acontece que os objetos não são passados por referência, mas clonados. E, como RE2 é uma função (classe) que apenas se vincula a um objeto implementado em C++, não podemos nem sequer passá-la como argumento.
Poderíamos simplesmente criá-la dentro da thread e passar a regex como string. Mas aí surgiu outra luz vermelha 🚩. Poderia haver um impacto significativo no desempenho se precisássemos recriar o objeto RE2 a cada chamada de match.
Em vez de especular, podemos testar. Usamos o benchmark.js.
Avaliação de desempenho
⚠️ Não é fácil executar microbenchmarks como estes. O V8 é muito inteligente na hora de otimizar, então considere os resultados com cautela. Confira este ótimo vídeo no YouTube sobre microbenchmarking
Como referência, RE2.match pode ser executado 500 mil vezes por segundo.
Como objetos RegExp podem ser clonados, podemos enviá-los para a thread sem alterações, em vez de usar RE2, e comparar o desempenho. Acontece que executar RegExp.match dentro de uma thread worker (aguardando o resultado) permite 50 mil execuções por segundo. Uma queda de 90%! 🤩
Criar o objeto RE2 na thread resulta em um desempenho ainda pior: 17 mil vezes por segundo. Uma perda de desempenho de 97%. 😭
Talvez threads não sejam a solução mais eficiente. Ainda bem que existe outra opção!
O módulo vm
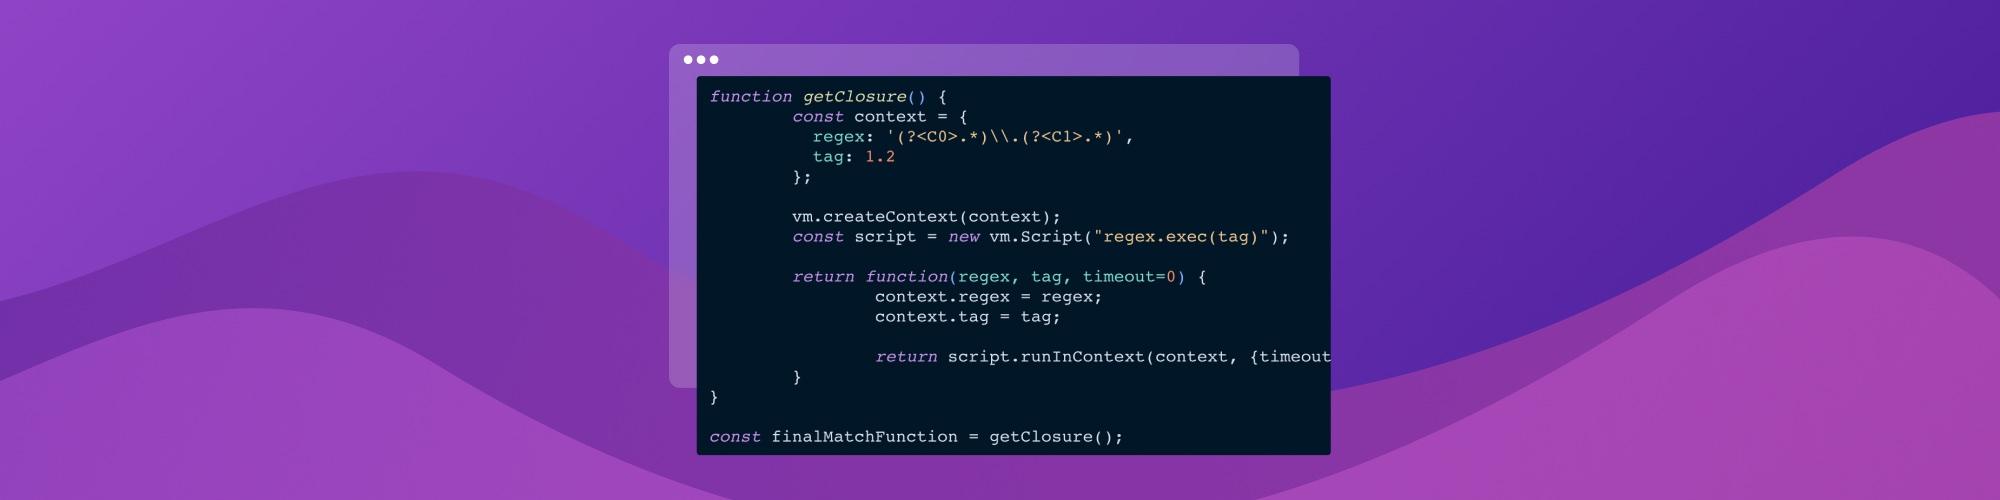
O Node tem um módulo chamado vm que permite executar scripts em um contexto separado. A vantagem é que ele já vem com uma opção de limite de tempo integrada.
Veja um exemplo de código:
Não precisamos criar o script e o contexto toda vez que quisermos executar uma correspondência. Podemos criar uma closure e retorná-la.
Código final
Vamos executar o benchmark de novo
Vamos executar isso no benchmark e conferir o desempenho. A execução do código a seguir dentro do vm teve um resultado bem mais aceitável: 200 mil vezes por segundo. 👍
Ah, espera! Esquecemos de adicionar um limite de tempo. Vamos executar o benchmark mais uma vez, agora com um limite de 100 milissegundos:
Isso não deveria ter muito impacto, já que nunca chegamos a estourar o limite…
Hmmm… 😭😭😭
Por que adicionar um limite de tempo que nunca é atingido resultou em um desempenho PIOR do que o da abordagem com threads!?
Algumas pesquisas no Google nos levaram a uma issue no GitHub, que nos levou a um PR, que nos levou a uma observação escondida no fim da página da documentação:
⚠️ Usar as opções de limite de tempo ou
breakOnSigintinicia novos loops de eventos e as respectivas threads, o que gera um custo adicional de desempenho.
Ah, não!
Conclusões
Como uma thread worker é mais complexa (mais difícil de ler, consome mais recursos e exige que todas as funções que a usam passem a ser assíncronas) do que a solução com vm, e ambas têm desempenho semelhante, escolhemos a solução com vm. Se ela se tornar um gargalo no futuro, podemos otimizá-la.
Agora que expliquei como implementamos esse recurso, queremos convidar você a experimentar nossas novas recomendações de imagens base personalizadas. Se gostar, conte para a gente no Twitter: @snyksec.
Segurança de contêineres que prioriza os desenvolvedores
O Snyk encontra e corrige automaticamente vulnerabilidades em imagens de contêiner e workloads do Kubernetes.


