Localização automática do código-fonte com Rego

12 de fevereiro de 2024
0 minutos de leituraNa Snyk, somos grandes fãs do Rego do Open Policy Agent. O Snyk IaC é baseado em um amplo conjunto de regras escritas em Rego, e os clientes também podem adicionar suas próprias regras personalizadas.
Lançamos recentemente uma série de melhorias no Snyk IaC. Neste post, vamos nos aprofundar em um recurso especialmente interessante: a localização automática do código-fonte para violações de regras.
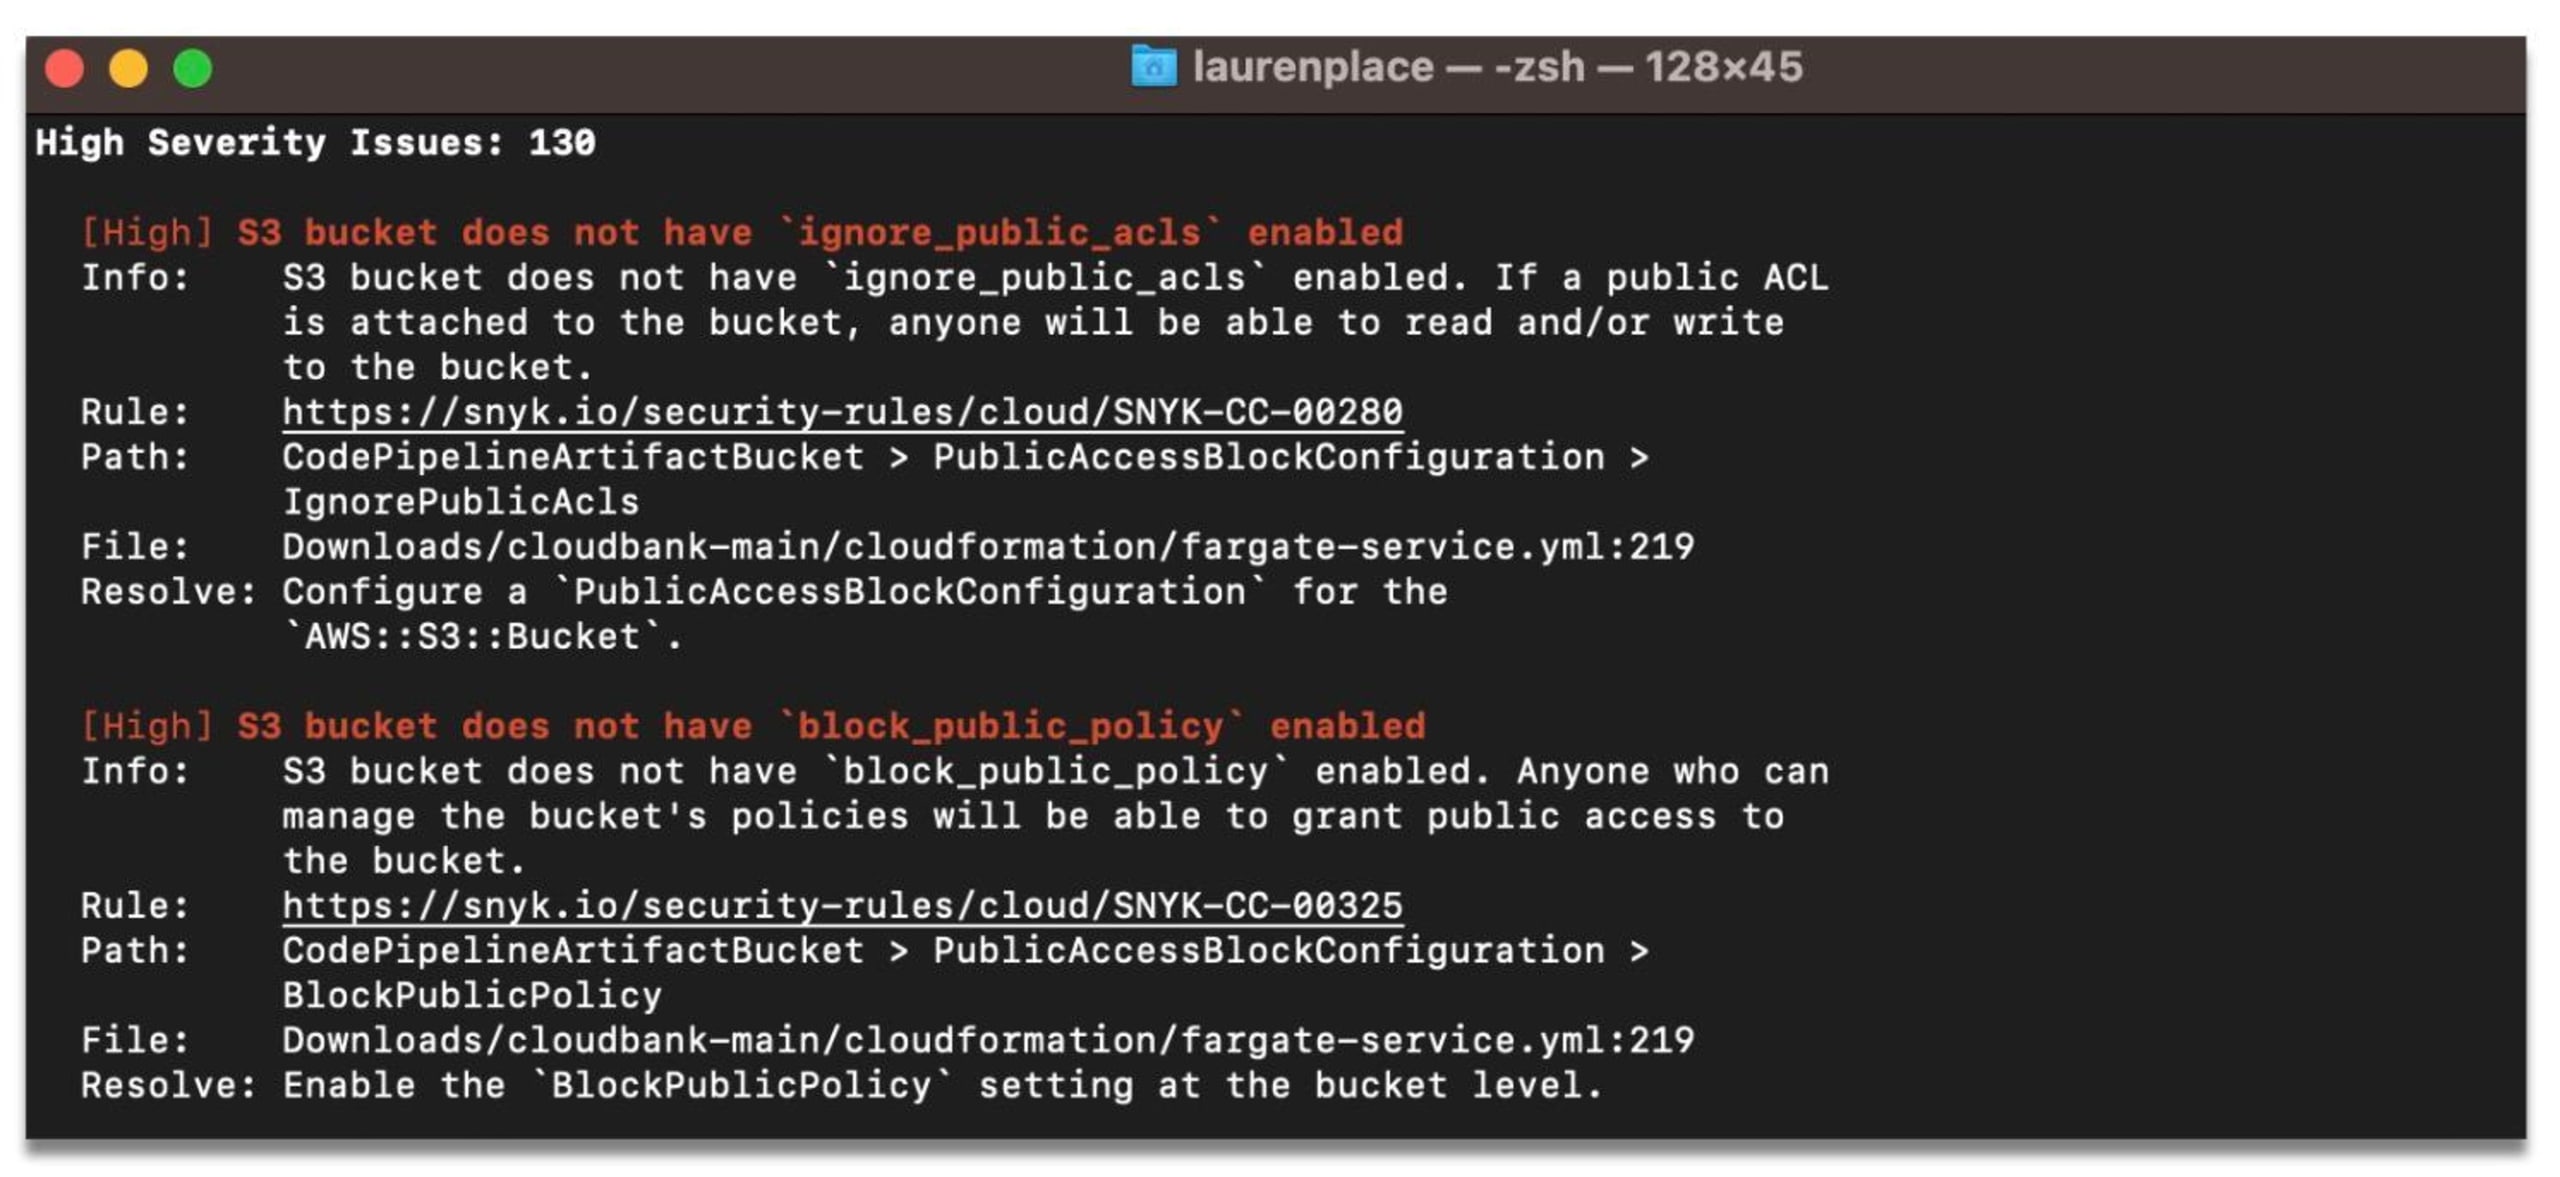
Ao verificar arquivos IaC em busca de problemas conhecidos, o comando atualizado `snyk iac test` exibe informações precisas de arquivo, linha e coluna para cada violação de regra. Isso também funciona com regras personalizadas, sem exigir nenhum trabalho de quem usa o comando.
Mas, antes de apresentarmos uma prova de conceito independente dessa técnica, precisamos fazer algumas simplificações. A implementação completa está disponível no nosso mecanismo de políticas unificado.
Vamos começar com um exemplo de CloudFormation. Embora nosso mecanismo IaC ofereça suporte a vários formatos, com foco especial em Terraform, o CloudFormation é um bom exemplo, pois podemos analisá-lo sem muitas dependências (afinal, é apenas YAML).
Queremos garantir que nenhuma sub-rede use um bloco CIDR maior que `/24`. Para isso, vamos escrever uma política Rego:
Assim, `deny` produzirá um conjunto de recursos negados. Não vamos explicar em detalhes como Rego funciona, mas, se quiser saber mais, recomendamos o excelente curso OPA by Example.
Podemos dividir o problema em duas partes:
Precisamos inferir que nossa política usa o atributo `CidrBlock`
Em seguida, vamos recuperar a localização no código-fonte
Vamos começar pela parte (2), que é uma boa maneira de nos familiarizarmos com o código.
Recuperação da localização no código-fonte
Uma localização no código-fonte é assim:
Também vamos introduzir um tipo auxiliar para representar caminhos em YAML. No YAML, há dois tipos de documentos aninhados: arrays e objetos.
Para poder fazer referência a qualquer subdocumento, poderíamos usar algo parecido com caminhos JSON. No exemplo acima, [`"some_array", 1`] apontaria para `"word"`. Mas, como não vamos oferecer suporte a arrays nesta prova de conceito, podemos usar apenas um array de strings.
Um exemplo de caminho seria algo assim:
Agora podemos criar um tipo auxiliar para carregar YAML e informar a `Location` de determinados `Paths`.
Para encontrar a localização no código-fonte de um `Path`, basta percorrer uma árvore de nós YAML:
Conjuntos e árvores de caminhos
Com isso, reduzimos o problema: em vez de inferir automaticamente as localizações no código-fonte usadas por uma política, vamos inferir automaticamente os caminhos de atributos.
Isso também é importante por outros motivos. Por exemplo, a Snyk pode aplicar as mesmas políticas tanto a recursos IaC quanto a recursos descobertos por meio de varreduras na nuvem. Estes últimos não têm localizações no código-fonte realmente significativas, mas têm caminhos de atributos relevantes!
Portanto, queremos definir conjuntos de caminhos de atributos. Como os caminhos são representados por arrays, infelizmente não podemos usar algo como `map[Path]struct{}` para criar um conjunto em Go.
Em vez disso, precisamos armazená-los em uma árvore recursiva.
Essa representação também tem outras vantagens. Em geral, só nos interessam os caminhos mais longos usados por uma política, pois são mais específicos. Nossa política de exemplo usa `Path{"Resources", "PrivateSubnet", "Properties"}` e também `Path{"Resources", "PrivateSubnet", "Properties", "CidrBlock"}` — só nos interessa o último.
Vamos definir um método recursivo para inserir um `Path` na nossa árvore:
…e também uma maneira de obter uma lista de `Paths`. Isso gera algumas alocações desnecessárias, mas podemos conviver com isso.
Agora temos uma maneira organizada de armazenar os `Paths` usados por uma política e de convertê-los em localizações no código-fonte.
Análise estática vs. análise em tempo de execução
A próxima questão é descobrir quais `Paths` de uma determinada entrada são usados por uma política e, em seguida, inseri-los na árvore com `Insert`.
Essa não é uma questão simples, pois o código pode manipular a entrada de diferentes maneiras antes de usar os caminhos. Precisamos analisar funções definidas pelo usuário ( `has_bad_subnet`) e também funções integradas ( `object.get`), para ilustrar apenas um dos possíveis obstáculos:
Felizmente, não estamos sozinhos nessa questão: desde que o primeiro programa foi escrito, as pessoas têm curiosidade sobre o que os programas fazem. Em geral, há duas maneiras de responder a uma pergunta desse tipo sobre um trecho de código:
Análise estática: tentar responder examinando a árvore sintática, os tipos e outras informações estáticas que podemos obter (ou adicionar) ao interpretador OPA. A vantagem é que não precisamos executar essa política, o que é ótimo se não confiamos em quem a criou. A desvantagem é que as técnicas de análise estática costumam gerar falsos negativos e falsos positivos.
Análise em tempo de execução: rastrear a execução de políticas específicas e inferir quais `Paths` estão sendo usados com base nas informações de execução. A desvantagem é que precisamos executar a política, e essa análise pode deixar a avaliação da política mais lenta.
Testamos as duas abordagens, mas escolhemos a última porque descobrimos que era muito mais fácil implementá-la com confiabilidade, e o impacto no desempenho era insignificante. Vale lembrar também que não é uma escolha entre uma coisa ou outra: podemos adotar uma abordagem híbrida e combinar as duas.
O OPA oferece uma interface Tracer que pode ser usada para receber eventos sobre o que o interpretador está fazendo. Um uso comum dos rastreadores é enviar métricas ou informações de depuração para algum log centralizado. Hoje, porém, vamos usá-la para outra finalidade.
Rastreamento do uso de termos
Rego é uma linguagem expressiva. Mesmo que algumas transformações simplifiquem o código para o interpretador, ainda há uma quantidade considerável de eventos.
Estamos interessados em apenas dois deles. Consideramos que um valor é usado se:
1. Ele é unificado (pense nisso como uma atribuição; não vamos entrar em detalhes) com outra expressão, por exemplo:
Isso também abrange `==` e `:=`. Como esse teste pode falhar, podemos dizer que usamos tanto o lado esquerdo quanto o lado direito.
2. Ele é usado como argumento de uma função integrada, por exemplo:
Embora Rego aproveite alguns conceitos das linguagens lazy, os argumentos das funções integradas sempre são totalmente avaliados antes que a função seja chamada. Portanto, podemos dizer que usamos todos os argumentos fornecidos à função integrada.
3. Ele é usado como uma expressão independente, por exemplo:
Isso é usado com frequência para avaliar valores booleanos e verificar se os atributos existem.
Agora é hora de implementar. Vamos tratar de dois eventos e delegar a uma função específica para deixar o código um pouco mais legível:
Vamos tratar da inserção na nossa `PathTree` mais adiante, em uma função auxiliar chamada `used(*ast.Term)`. Por enquanto, vamos marcar como usados os dois lados da unificação:
`event.Plug` é uma função auxiliar que preenche as variáveis com seus valores reais.
Um evento `EvalOp` abrange os casos (2) e (3) mencionados acima. No caso de uma função integrada, teremos um array de termos: o primeiro elemento é a função, e os demais são os argumentos. Podemos verificar se estamos lidando com uma função integrada consultando `ast.BuiltinMap`.
O caso de uma expressão independente é simples.
Anotação de termos
Ao tentar implementar `used(*ast.Term)`, surge a próxima questão: dado um termo, como associá-lo a um `Path` na entrada?
Uma opção seria procurar termos correspondentes no documento de entrada. Mas isso geraria muitos falsos positivos, pois uma string como `10.0.0.0/24` pode aparecer várias vezes na entrada!
Em vez disso, vamos anotar todos os termos com o caminho correspondente. Os termos no OPA podem conter alguns metadados, inclusive a localização no arquivo-fonte do Rego. Podemos reutilizar esse campo para armazenar um `Path` de entrada. É um pouco improvisado, mas, pensando bem, estamos usando o campo de uma forma perfeitamente adequada, já que ele foi feito para armazenar localizações.
O trecho a seguir mostra como queremos anotar as primeiras linhas do nosso template do CloudFormation:
`annotate` implementa uma travessia recursiva para determinar o `Path` em cada nó do valor. Para manter o exemplo conciso, só oferecemos suporte a objetos, deixando conjuntos e arrays de fora.
Com essa anotação, é fácil escrever `used(*ast.Term)`. Só precisamos lembrar que nem todos os valores estão anotados. Fazemos isso apenas com os valores que vêm do documento de entrada, não, por exemplo, com literais incorporados ao código-fonte Rego.
Conclusão
É isso, pessoal! Deixamos de lado muitos detalhes, como arrays e a aplicação dessa técnica a uma linguagem IaC mais complexa, como HCL.
Além disso, também estamos marcando os atributos `Type` como usados, já que os verificamos na nossa política. Isso não é ideal e, como alternativa, tentamos oferecer uma API Rego orientada a recursos. Mas isso foge do escopo deste exemplo.
Se quiser saber mais sobre qualquer um desses recursos, recomendamos conferir snyk/policy-engine para ver a implementação principal ou o Snyk IaC atualizado, que inclui esse recurso e muitos outros, como um conjunto abrangente de regras.
A seguir, temos uma função principal que reúne tudo e exibe algumas informações de depuração. Ela basicamente combina os elementos que definimos até aqui e os executa em um exemplo. Mas vamos incluí-la para que este post funcione como um exemplo independente e reproduzível.
O código completo desta prova de conceito está disponível neste gist.
Segurança de IaC pensada para quem desenvolve
A Snyk protege sua infraestrutura como código do ciclo de vida do desenvolvimento de software até a execução na nuvem, com um mecanismo unificado de políticas como código para que todas as equipes possam desenvolver, implantar e operar com segurança.