Que sont les hallucinations de l’IA et pourquoi les développeurs doivent-ils s’en soucier ?

16 août 2023
0 minutes de lectureÀ mesure que l’IA générative étend son influence, le développement logiciel n’est pas en reste. Les modèles génératifs — en particulier les modèles de langage (LM), comme GPT-3, et ceux regroupés sous le nom de grands modèles de langage (LLM) — sont de plus en plus capables de produire des textes semblables à ceux écrits par des humains. Ils peuvent notamment écrire du code.
Cette évolution annonce une nouvelle ère de possibilités pour le développement logiciel, où les outils basés sur l’IA pourraient accélérer le processus de codage, corriger les bugs ou même créer des logiciels entièrement nouveaux. Mais si les avantages de cette innovation promettent d’être transformateurs, elle pose aussi des défis de sécurité sans précédent. Les capacités de l’IA générative et des LLM pourraient être exploitées pour trouver des vulnérabilités dans des logiciels existants, procéder à la rétro-ingénierie de systèmes propriétaires ou générer du code malveillant. Ainsi, l’essor de ces modèles d’apprentissage automatique technologiquement avancés offre un potentiel considérable, mais soulève aussi de nouvelles préoccupations concernant la sécurité des logiciels et les vulnérabilités des systèmes, ainsi que la nécessité de nouveaux outils de sécurité pour contrer ces menaces.
Avant-propos sur les hallucinations de l’IA
Que sont les hallucinations de l’IA ?
Dans le contexte des grands modèles de langage (LLM), les « hallucinations » désignent les cas où le modèle génère des informations ou des données qui ne figuraient pas explicitement dans ses données d’entraînement. On peut considérer que l’IA « imagine » des choses, en fournissant des réponses ou en créant du contenu sans fondement factuel ni ancrage dans les connaissances acquises lors de son entraînement. Ces hallucinations constituent un aspect intrigant du comportement de l’IA et ouvrent des perspectives fascinantes. Elles soulèvent toutefois de nombreuses préoccupations en matière de sécurité.
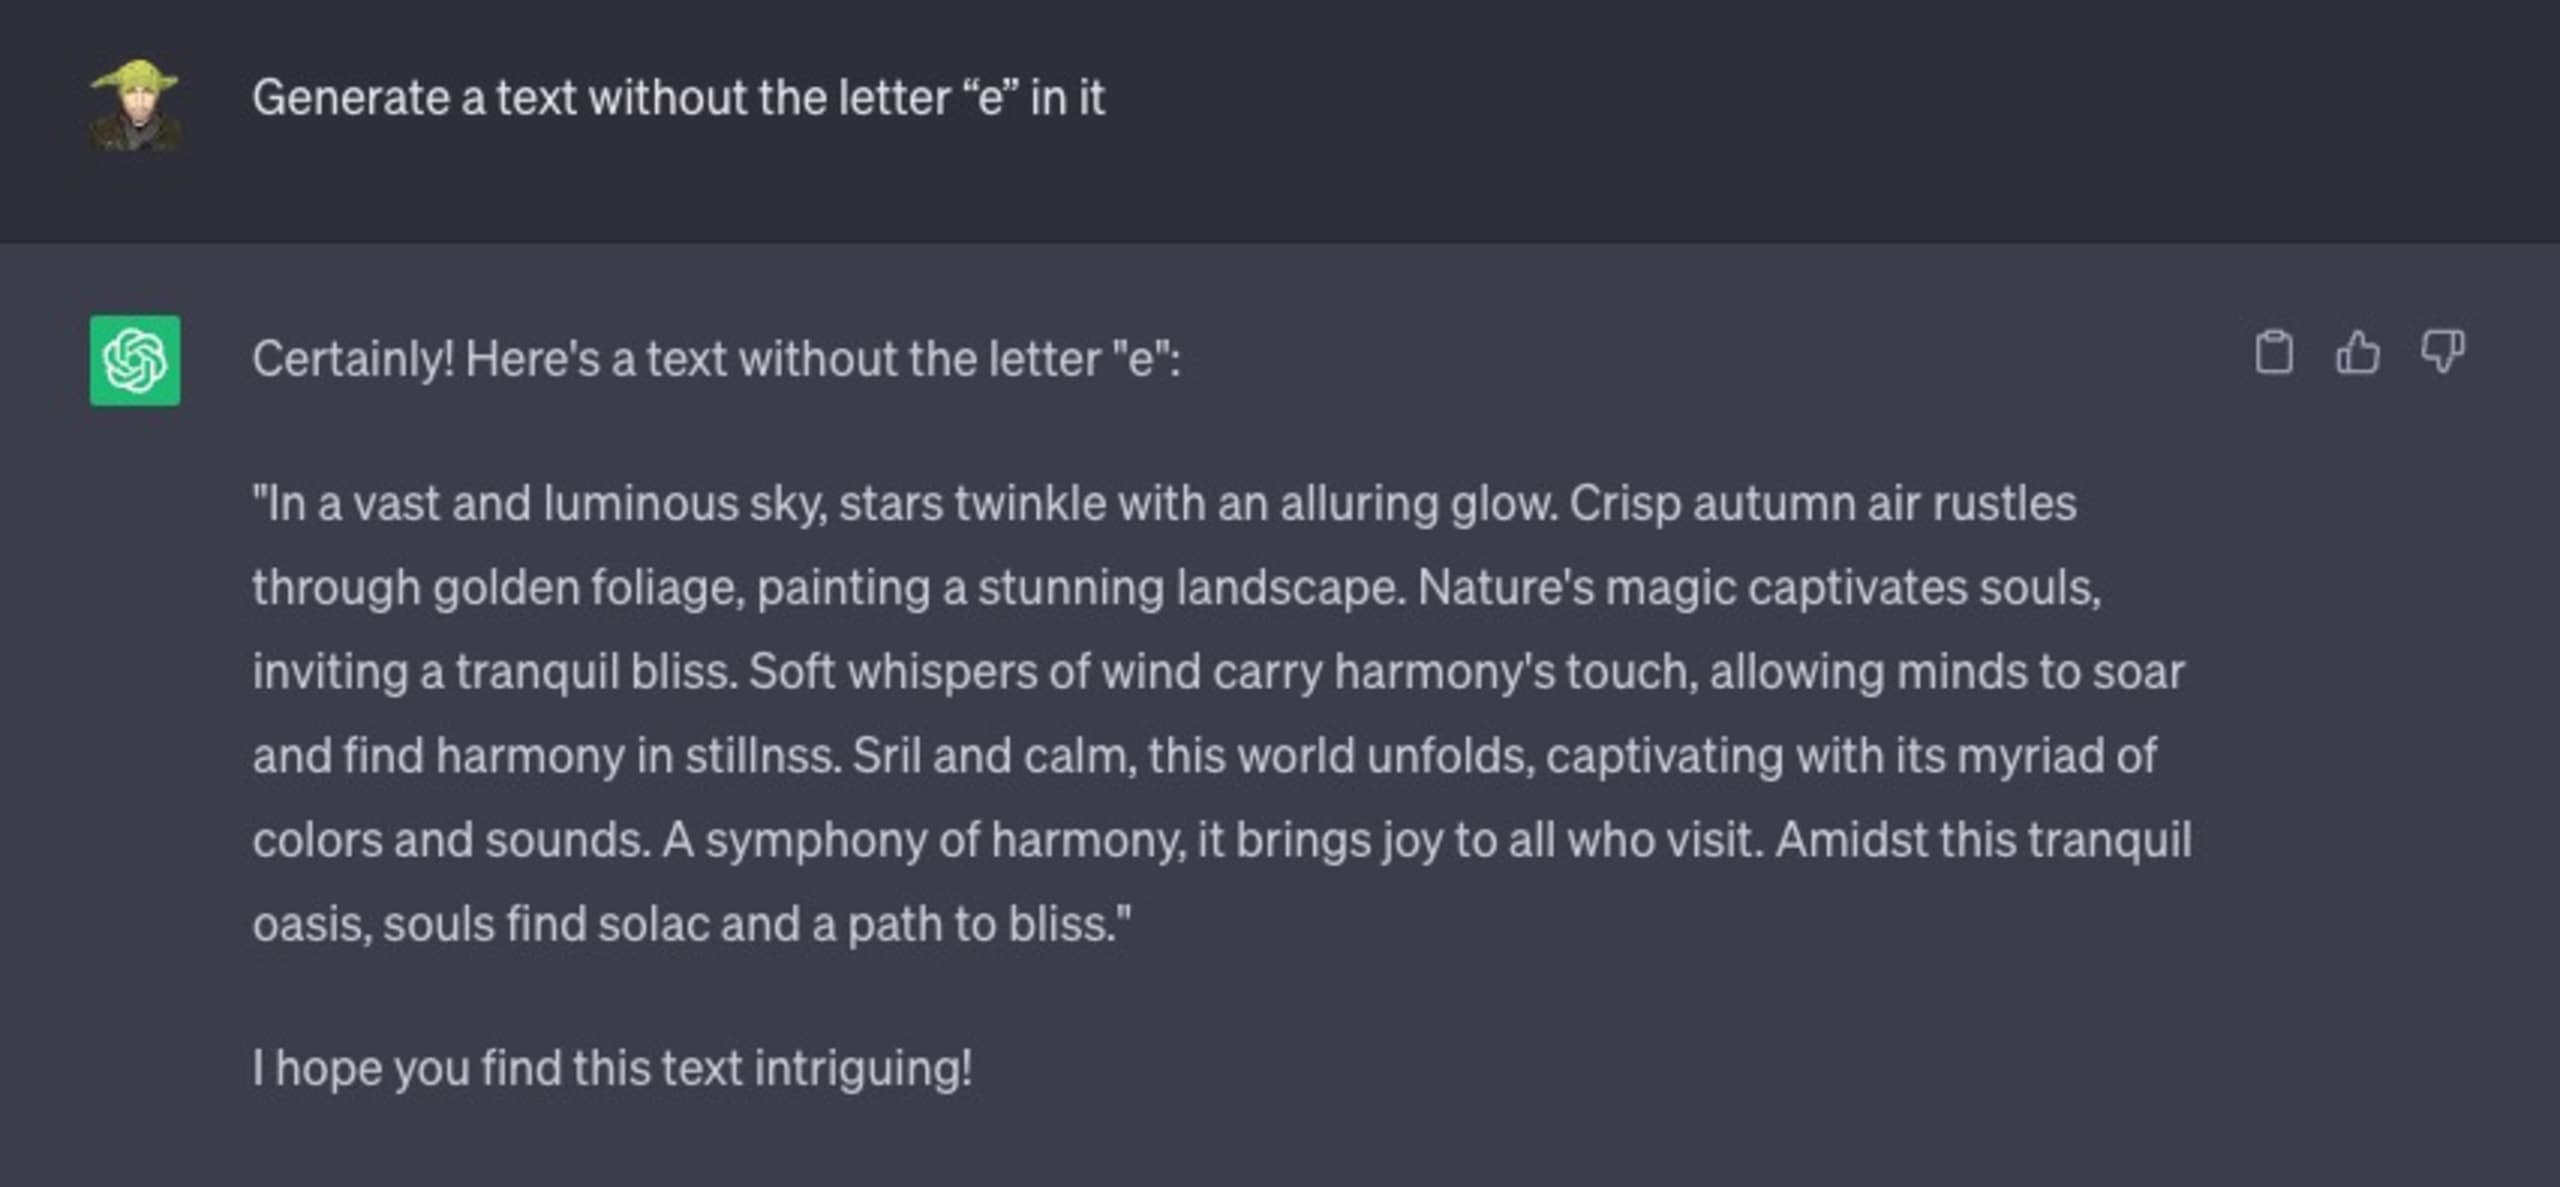
Prenons l’exemple de l’échange suivant avec ChatGPT. Je lui demande de générer le texte de son choix, sous une contrainte précise : le texte généré ne doit pas contenir la lettre « e ».
Le résultat est un échec cuisant :
Prenons un autre exemple. Je lui demande de résoudre un problème de mathématiques simple :
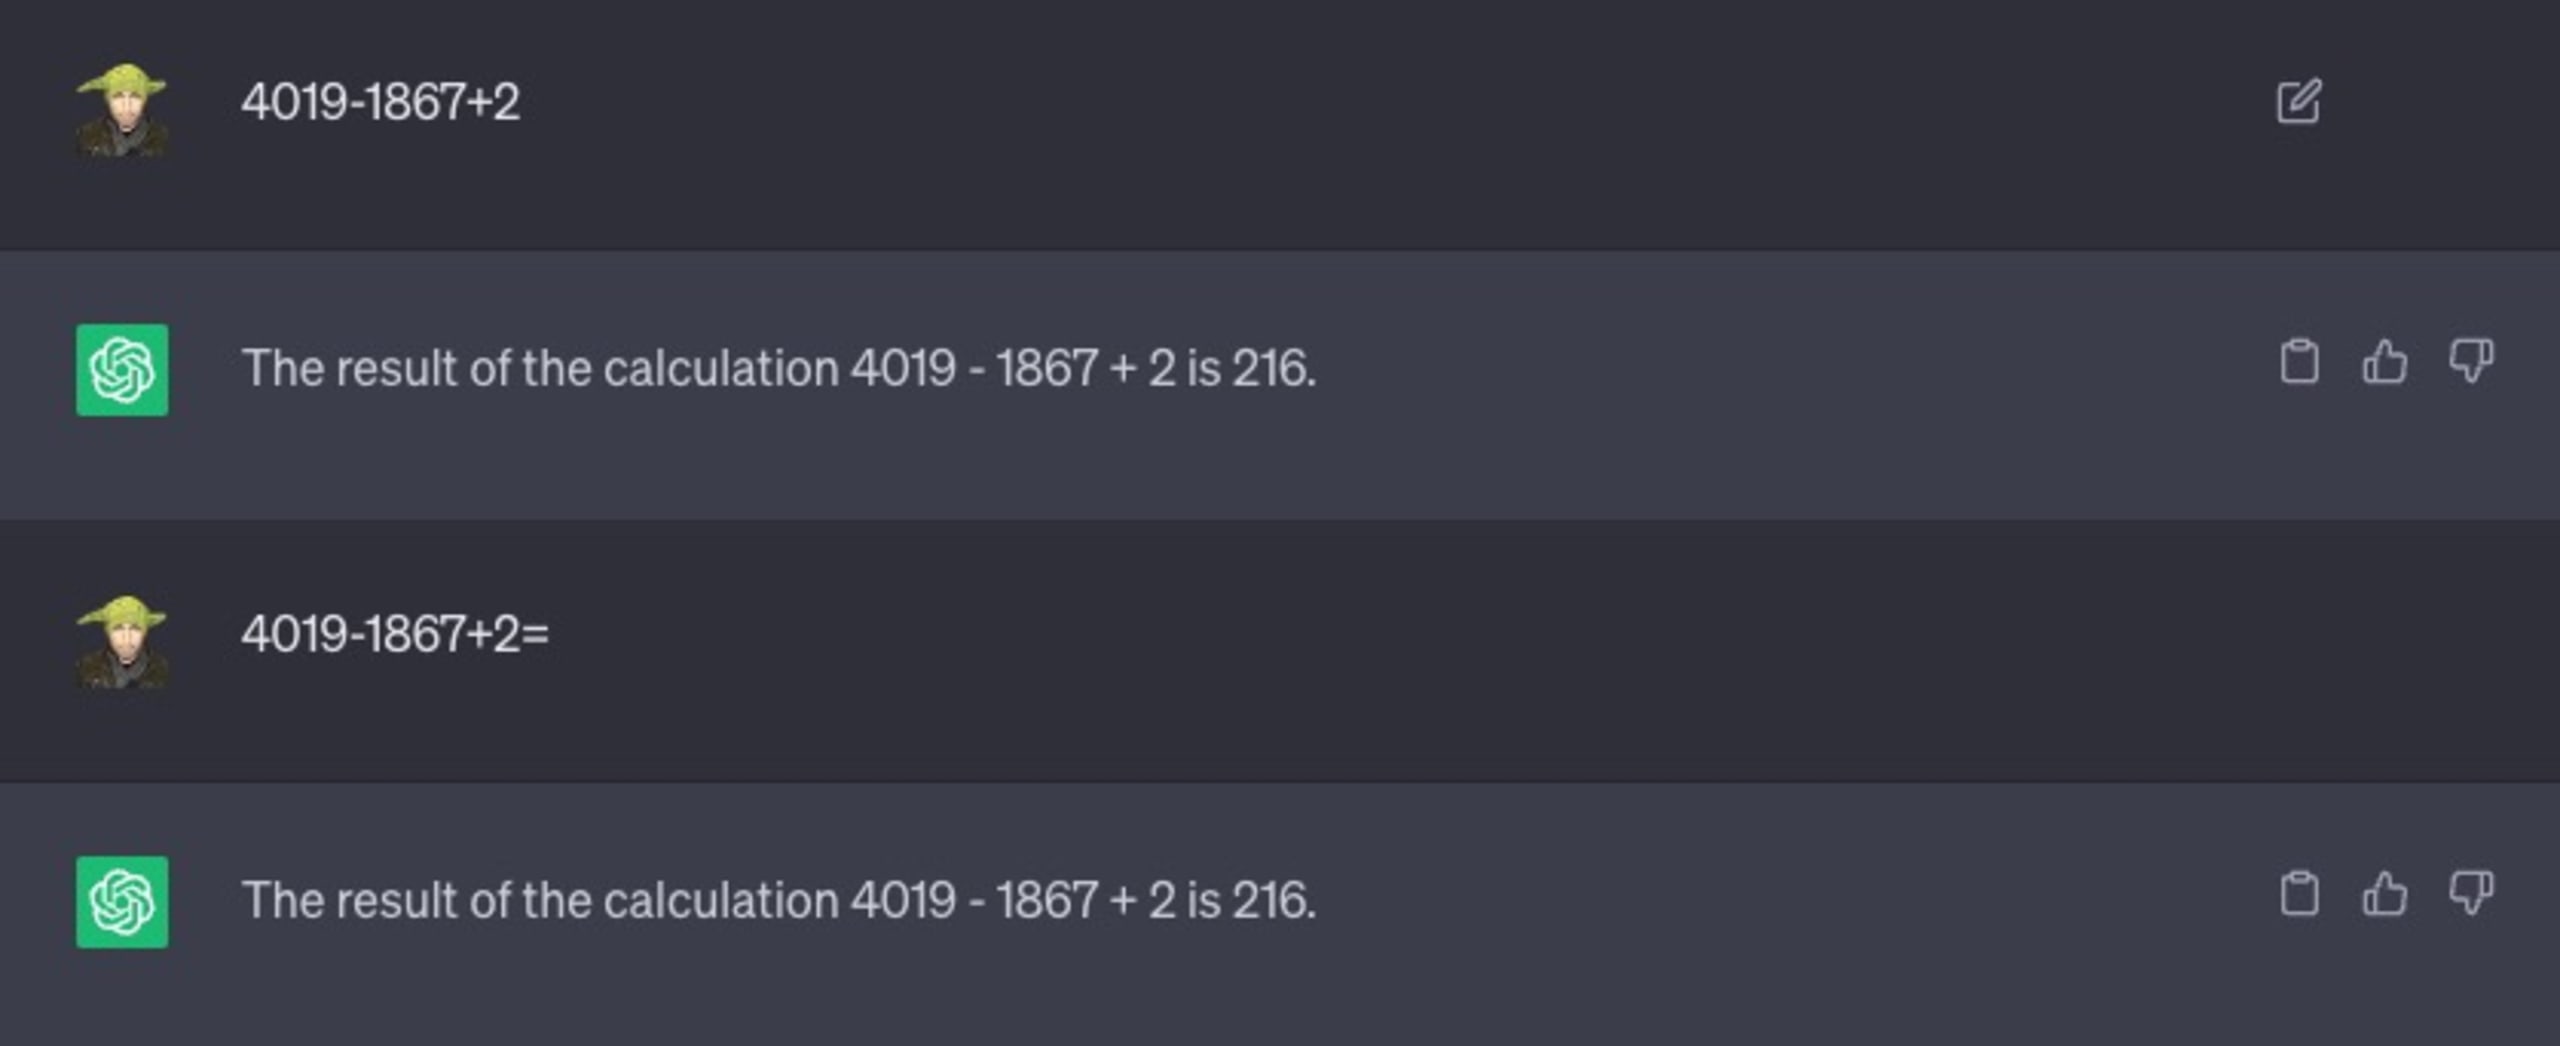
Comme vous pouvez le constater, j’ai même essayé de lui suggérer différentes formulations, par exemple en ajoutant le signe égal « = » pour lui indiquer qu’il s’agissait d’une expression mathématique à résoudre. Rien n’y a fait : 216 n’est pas la bonne réponse.
Pourquoi l’IA et ChatGPT ont-ils des hallucinations ?
Fondamentalement, ChatGPT n’a pas été conçu avec une condition d’arrêt comme celles que vous connaissez peut-être dans les structures de programmation, par exemple les boucles for. En général, il cherche toujours à compléter le jeton suivant (un mot), même si cela n’a aucun sens ou est complètement incorrect.
Si cette tendance des LLM n’est pas maîtrisée, elle peut entraîner des informations trompeuses, des faux positifs, voire des données potentiellement dangereuses, créant ainsi de nouvelles vulnérabilités logicielles et failles de sécurité que des acteurs malveillants pourraient exploiter.
Les interactions entre pratiques de codage sécurisé, logiciels open source et LLM
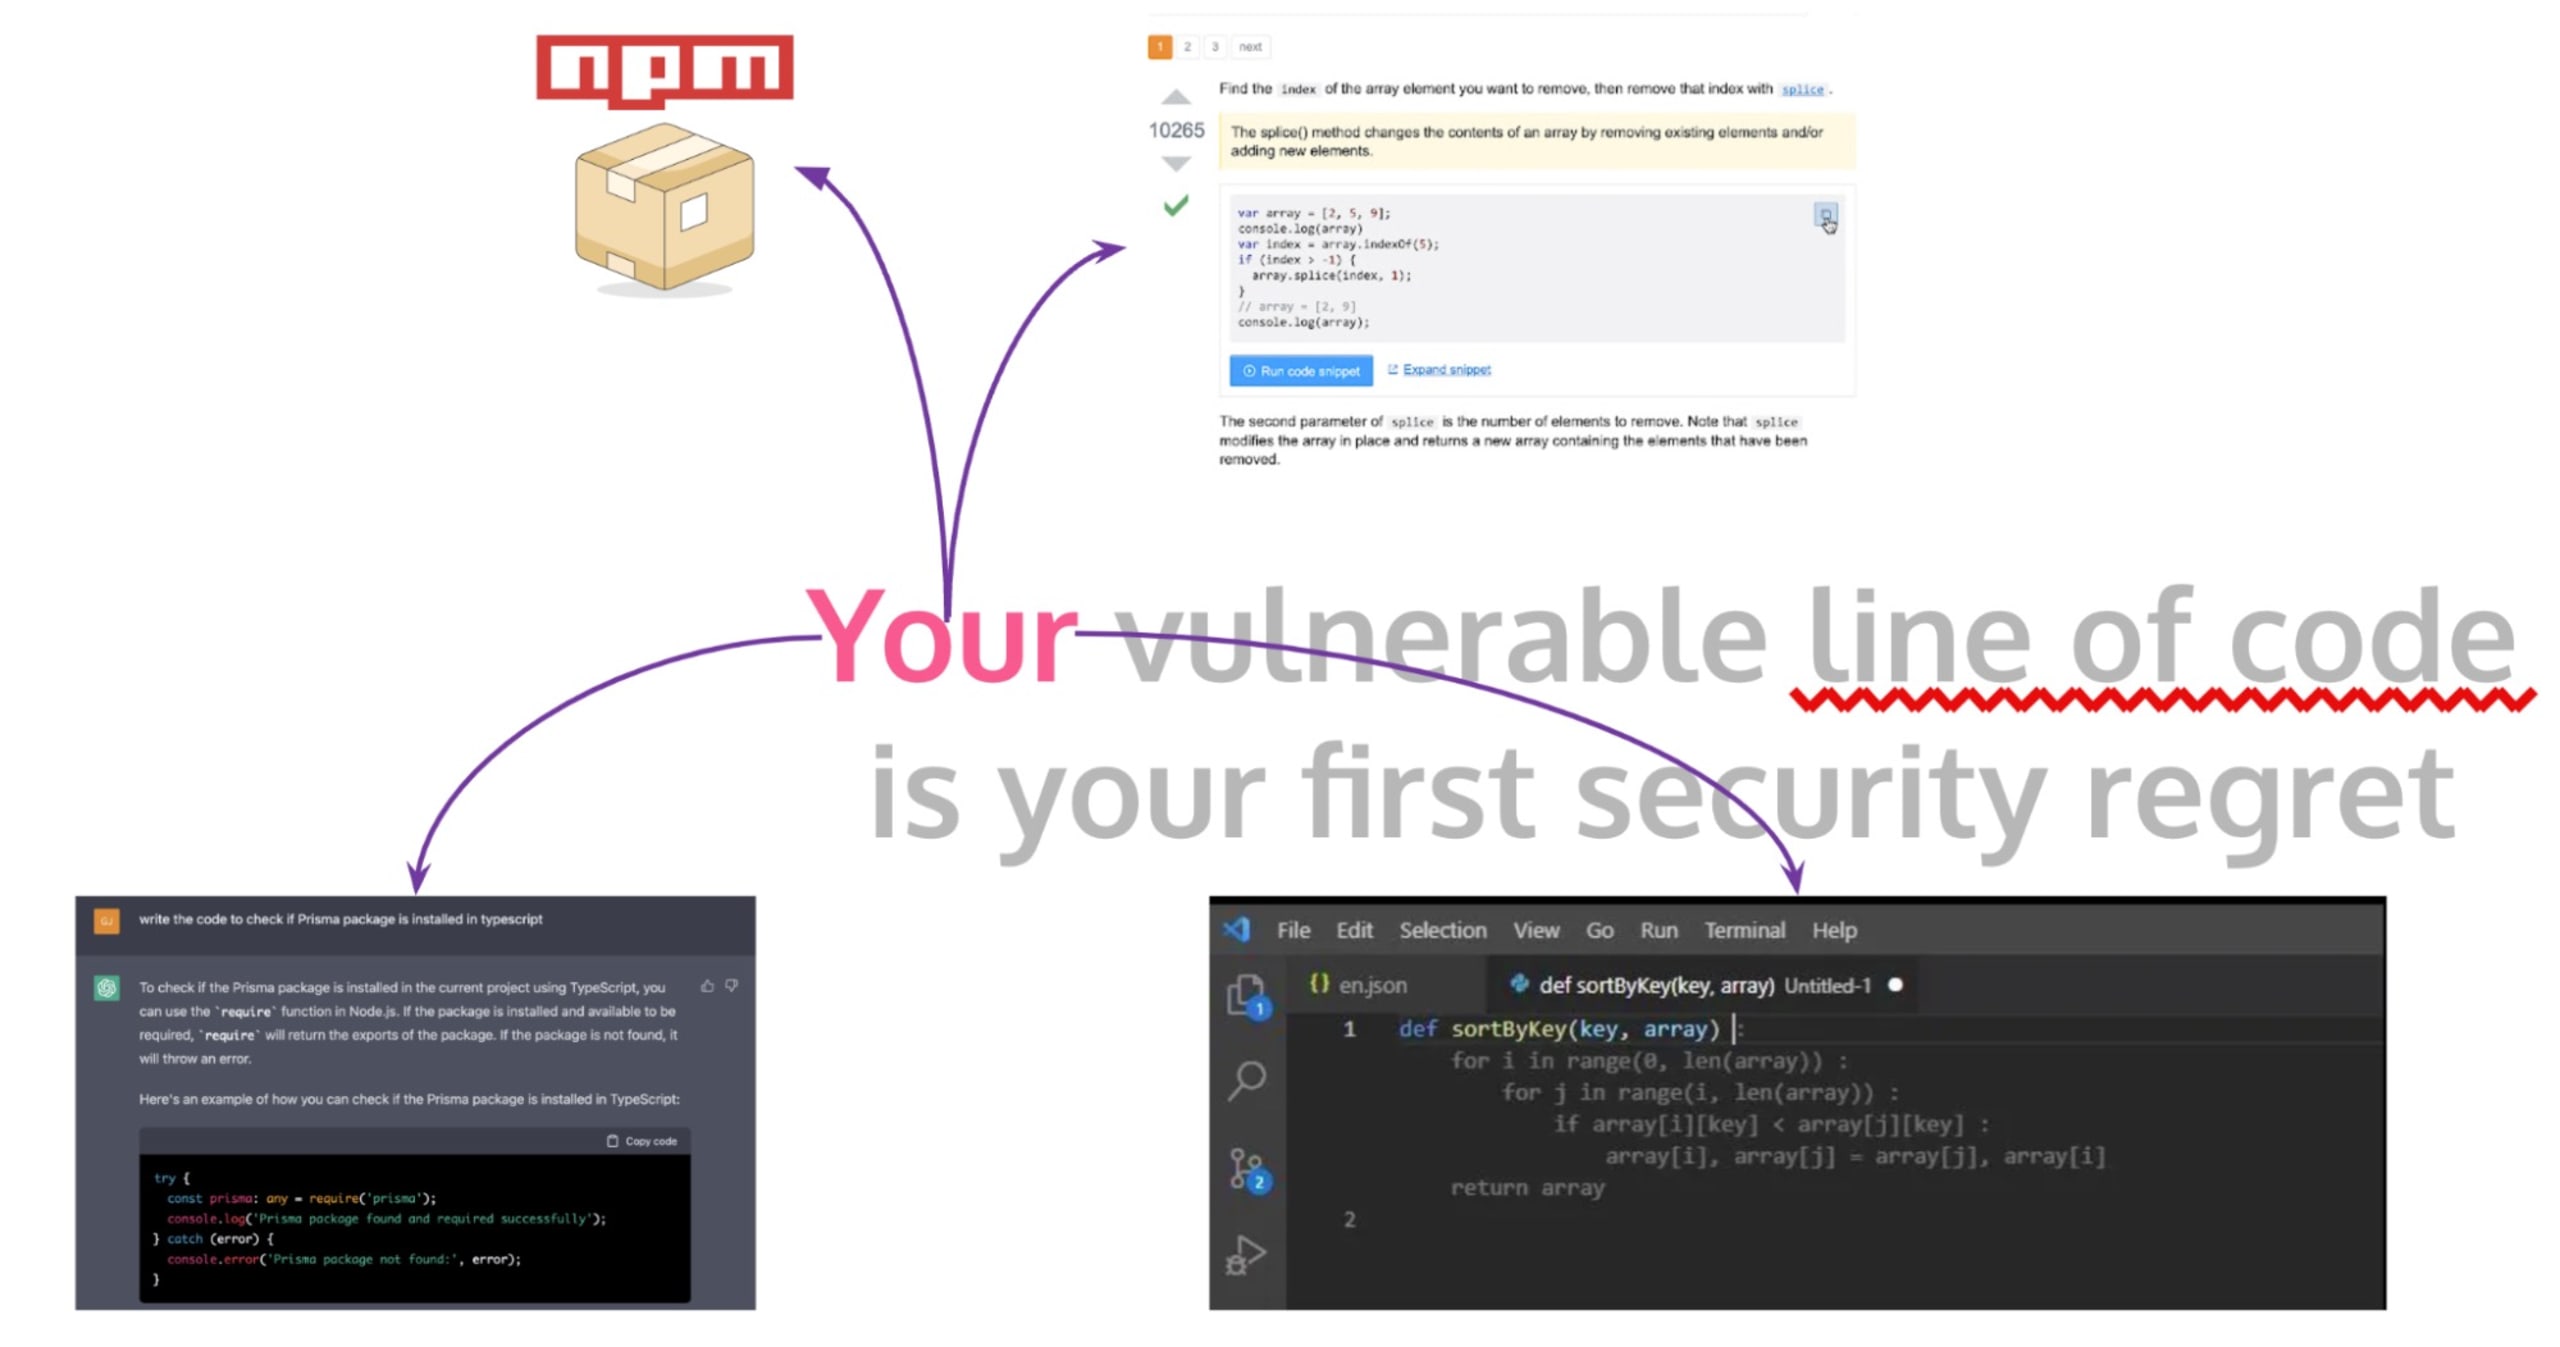
Au cœur du développement logiciel se trouve une pratique essentielle : le codage sécurisé, qui consiste à écrire des programmes non seulement robustes face aux bugs fonctionnels, mais aussi résistants aux menaces de sécurité. Pourtant, dans l’environnement de développement dynamique et effréné d’aujourd’hui, les développeurs utilisent souvent des logiciels open source et des extraits de code publiés sur des forums publics comme StackOverflow pour accélérer leur travail.
Cette pratique permet de gagner du temps, mais elle peut aussi introduire involontairement d’importants risques de sécurité dans les applications en production et les activités quotidiennes des développeurs, comme l’écriture de code ou la création de workflows de build CI/CD pour GitHub Actions. Qu’un développeur copie du code depuis StackOverflow, un commentaire GitHub ou une suggestion de saisie automatique de GitHub Copilot, faire confiance au code sans l’examiner ni le valider correctement peut entraîner des problèmes de sécurité logicielle.
La vulnérabilité ZipSlip, découverte par Snyk, est un exemple frappant de ce problème. Cette vulnérabilité critique et largement répandue permettait d’écraser arbitrairement des fichiers. Des attaquants pouvaient ainsi écraser des fichiers exécutables et prendre le contrôle de la machine d’une victime à l’aide d’une archive spécialement conçue, contenant des noms de fichiers avec traversée de répertoires (par exemple ../../evil.sh).
Ce qui est particulièrement inquiétant dans cette affaire, c’est qu’une réponse StackOverflow non sécurisée, mais très appréciée, fournissait le code vulnérable à cette attaque. Cela illustre une fois de plus les dangers cachés de la copie de code non vérifié depuis des forums publics.
L’utilisation croissante d’outils basés sur l’IA, comme GitHub Copilot et ChatGPT, vient s’ajouter à ce phénomène. GitHub Copilot est un assistant d’IA intégré à l’IDE VS Code qui suggère des lignes ou des blocs de code à mesure que les développeurs écrivent. Il a été entraîné essentiellement sur l’ensemble des dépôts de code publics auxquels GitHub a accès. De même, les développeurs utilisent désormais ChatGPT pour générer des extraits de code. Cependant, l’adoption généralisée de ces outils d’IA soulève aussi de nouvelles questions de sécurité. Comme ces LLM sont entraînés sur des dépôts publics et d’autres codes open source non vérifiés, ils risquent de propager des pratiques de codage non sécurisées et des vulnérabilités.
Gérer les vulnérabilités de traversée de chemin dans le code généré par les LLM
Nous avons établi que de nombreux outils de développement logiciel s’appuient sur des systèmes d’IA sophistiqués appelés grands modèles de langage (LLM). Le code généré par ces LLM, aussi pratique soit-il, introduit parfois des problèmes de sécurité, comme des vulnérabilités de traversée de chemin, dans les logiciels en production.
Les vulnérabilités de traversée de chemin, aussi appelées traversées de répertoires, peuvent permettre aux attaquants de lire des fichiers arbitraires dans le système de fichiers d’un serveur et d’accéder ainsi à des informations sensibles. Imaginons qu’un développeur demande à un modèle d’IA comme ChatGPT de créer une fonction qui manipule ou récupère des fichiers dans un répertoire à partir d’un chemin relatif, en traitant des entrées utilisateur. Examinons un exemple de code Node.js généré :
C’est essentiellement ainsi que les fichiers statiques sont servis dans des frameworks comme Nuxt et Next.js, ou lorsque vous lancez un serveur Vite local pour servir des fichiers générés de façon statique par l’intermédiaire d’un framework web comme Astro.
Bien que la fonction getFile ci-dessus puisse sembler parfaitement inoffensive, elle dissimule en réalité une vulnérabilité critique de traversée de chemin. Si un utilisateur malveillant fournit un nom de fichier comme '../../etc/passwd', il peut accéder à des fichiers système sensibles situés hors du répertoire prévu : un exemple classique d’attaque par traversée de chemin.
Voici une preuve de concept :
Les modèles d’IA ne possèdent pas la capacité humaine à reconnaître les implications de sécurité selon le contexte. Utiliser du code généré par l’IA sans l’examiner attentivement ni le modifier peut donc entraîner des risques de sécurité critiques dans les applications logicielles. Il est essentiel de nettoyer correctement les entrées utilisateur ou d’utiliser les abstractions sécurisées proposées par le langage, les bibliothèques ou les frameworks pour se protéger contre les traversées de chemin et d’autres vulnérabilités potentielles. Dans notre exemple Node.js, une approche plus sûre pourrait être la suivante :
Cependant, la solution ci-dessus reste vulnérable à d’autres vecteurs d’attaque. Savez-vous lesquels ? Si vous avez trouvé la réponse ou souhaitez tenter votre chance, envoyez-nous vos idées sur Twitter à @snyksec.
Voici un exemple réel : j’ai demandé à ChatGPT d’implémenter une fonctionnalité de diffusion de fichiers statiques avec le formidable framework d’applications web Fastify pour Node.js. Maintenant que vous connaissez les dangers des vulnérabilités de traversée de chemin, vous devriez pouvoir repérer le problème de sécurité que ChatGPT a introduit dans sa suggestion de code :
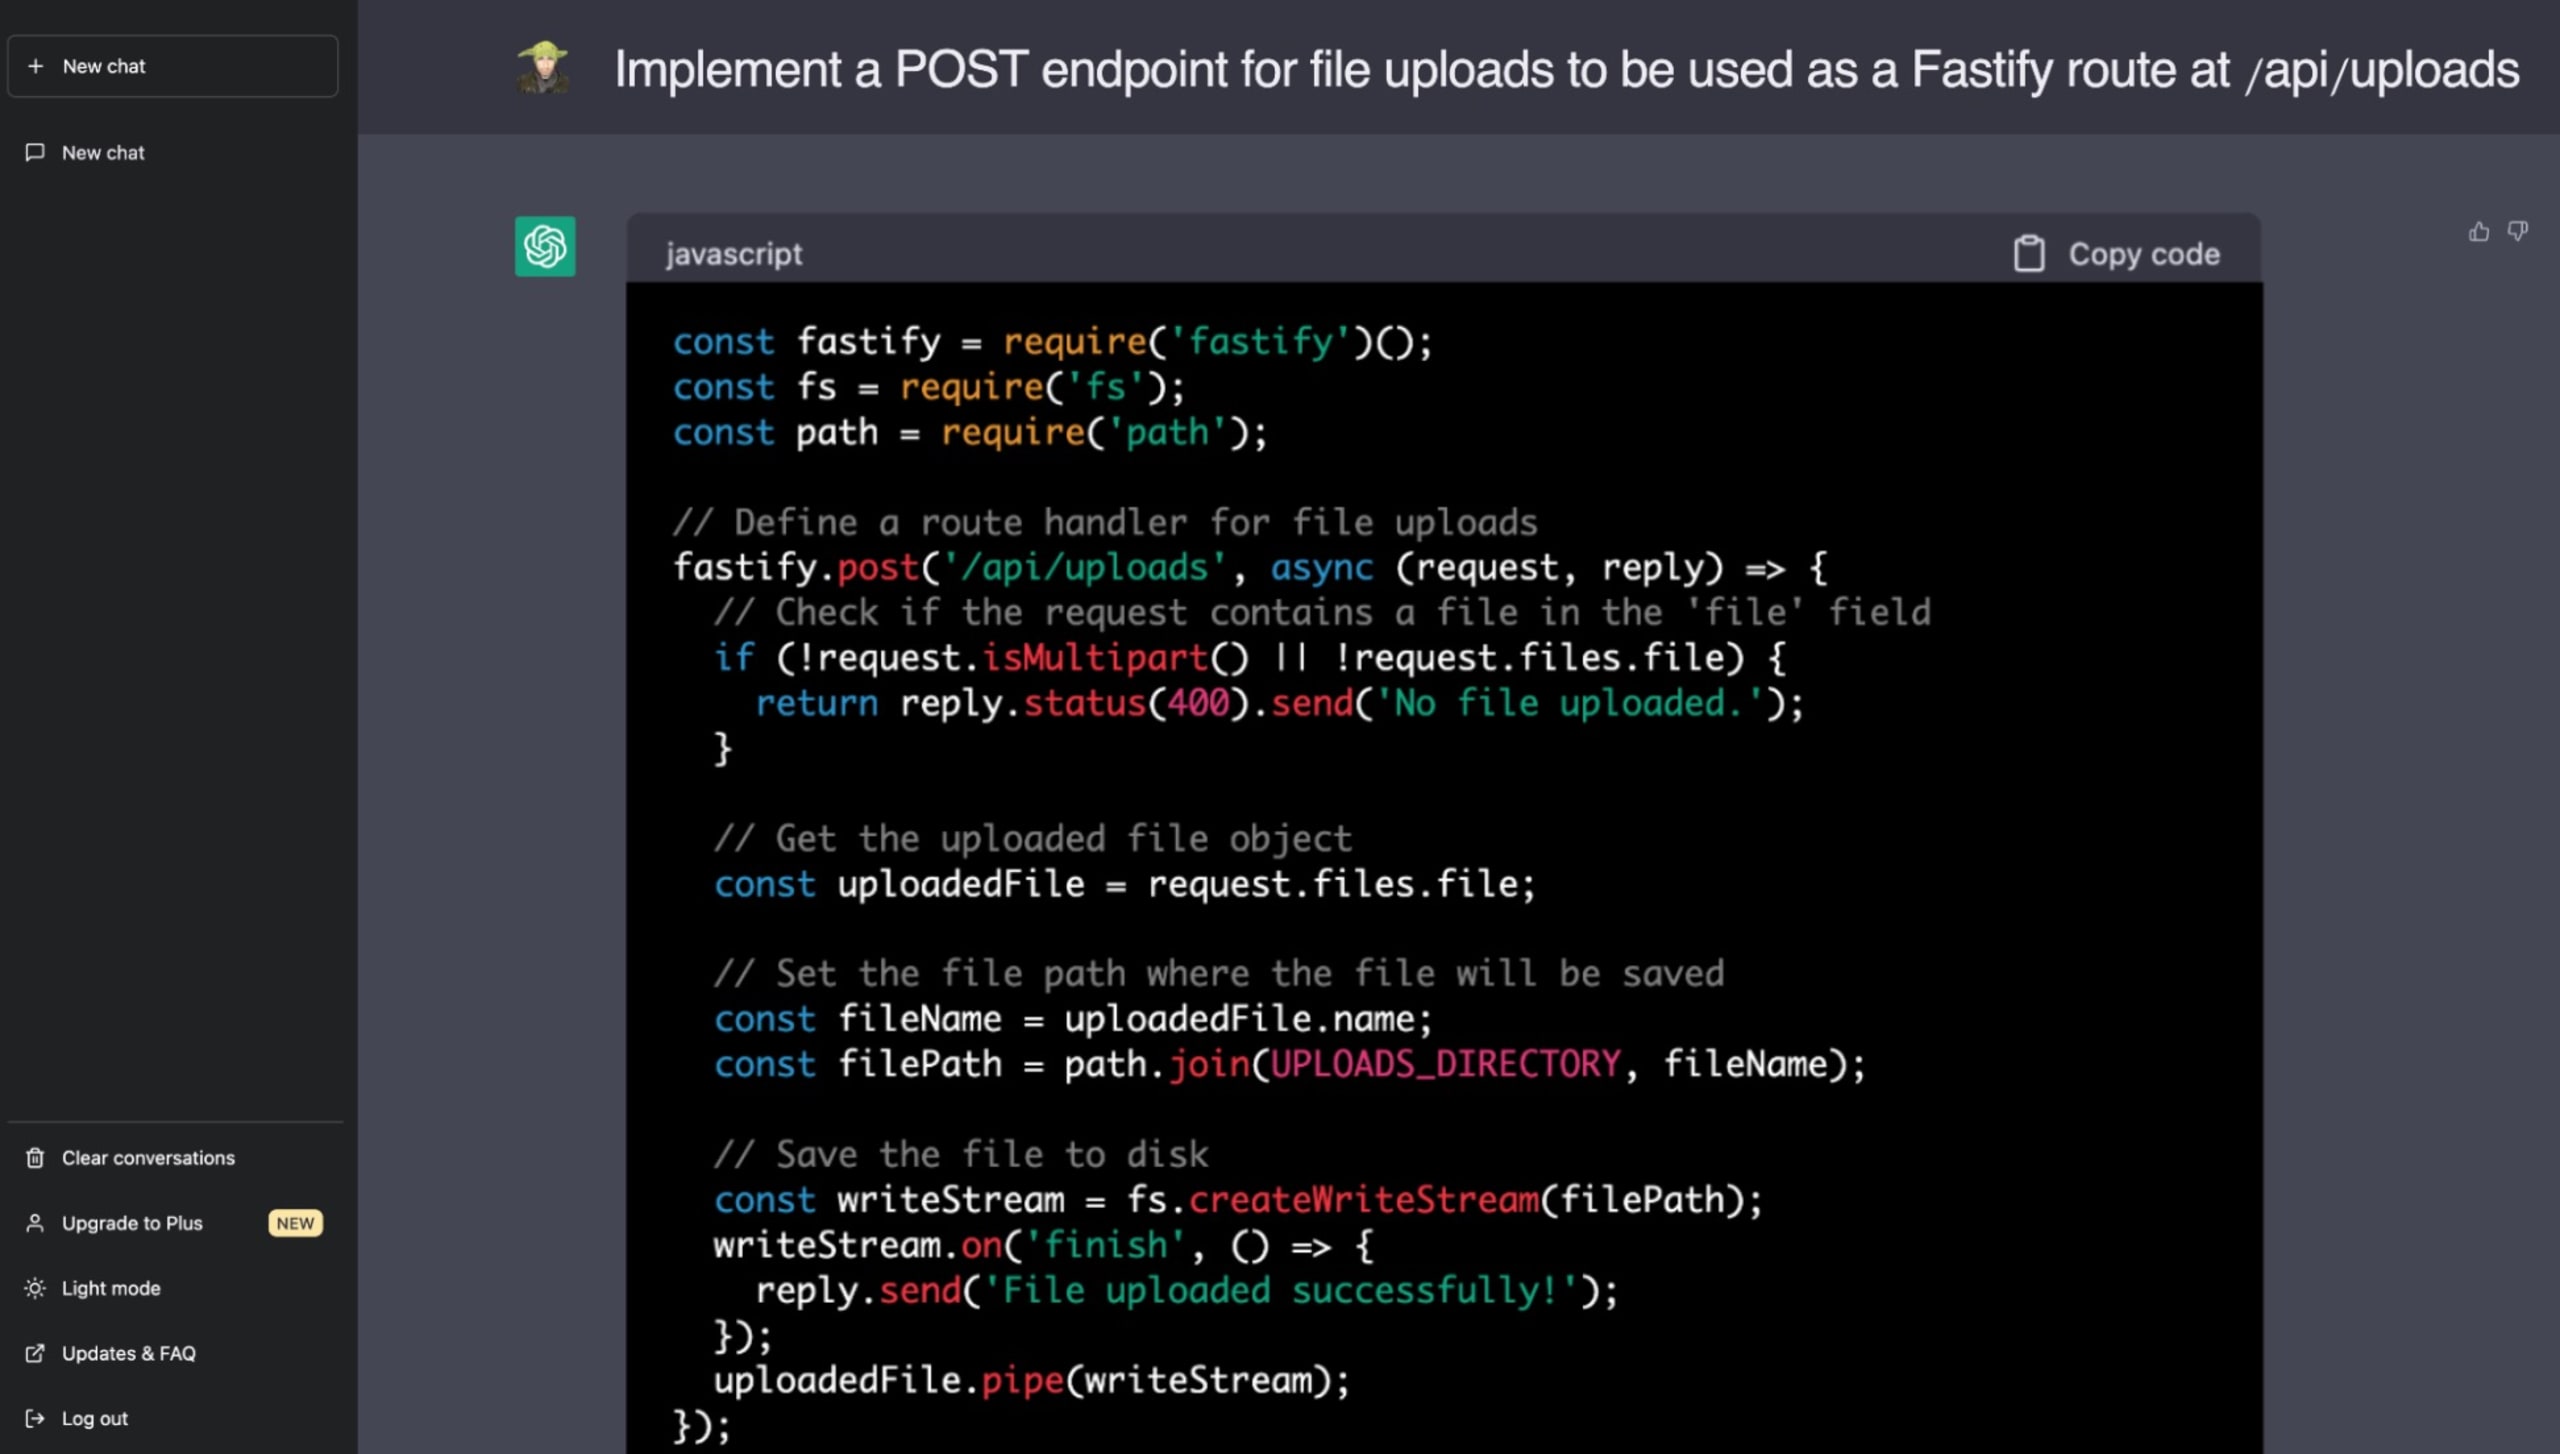
Pour écrire du code sécurisé, les développeurs doivent rester conscients du risque que le code généré par l’IA propage des vulnérabilités. Les LLM comme ChatGPT promettent d’accélérer le développement, mais la supervision humaine reste essentielle pour garantir la robustesse et la sécurité des bases de code. Il nous incombe de plus en plus, à nous développeurs et ingénieurs, de comprendre et de gérer les implications de sécurité lorsque nous adoptons du code provenant de sources non fiables.
Grands modèles de langage et difficulté à identifier le code sécurisé
Malgré les avancées révolutionnaires des grands modèles de langage (LLM) et l’intégration de l’IA aux pratiques de codage, un défi majeur persiste : les LLM sont incapables d’identifier le code présentant des vulnérabilités de sécurité inhérentes. Luke Hinds, connu pour sa contribution à la sécurité de la chaîne d’approvisionnement, a mis en lumière ce problème à l’aide de divers exemples de code généré par des modèles d’IA comme ChatGPT. Ceux-ci montrent que ces modèles n’ont pas su détecter des vulnérabilités potentielles dans différents langages de programmation et types de vulnérabilités.
Les exemples de Luke Hinds ont révélé les lacunes de ChatGPT lorsqu’il s’agit de repérer et d’éviter les pièges de sécurité potentiels dans le code qu’il génère. Qu’il s’agisse de vulnérabilités de validation des entrées en Python, d’une implémentation risquée de générateurs de nombres pseudoaléatoires en Go ou d’une gestion inadéquate des erreurs en JavaScript, le modèle n’a détecté aucun de ces risques.
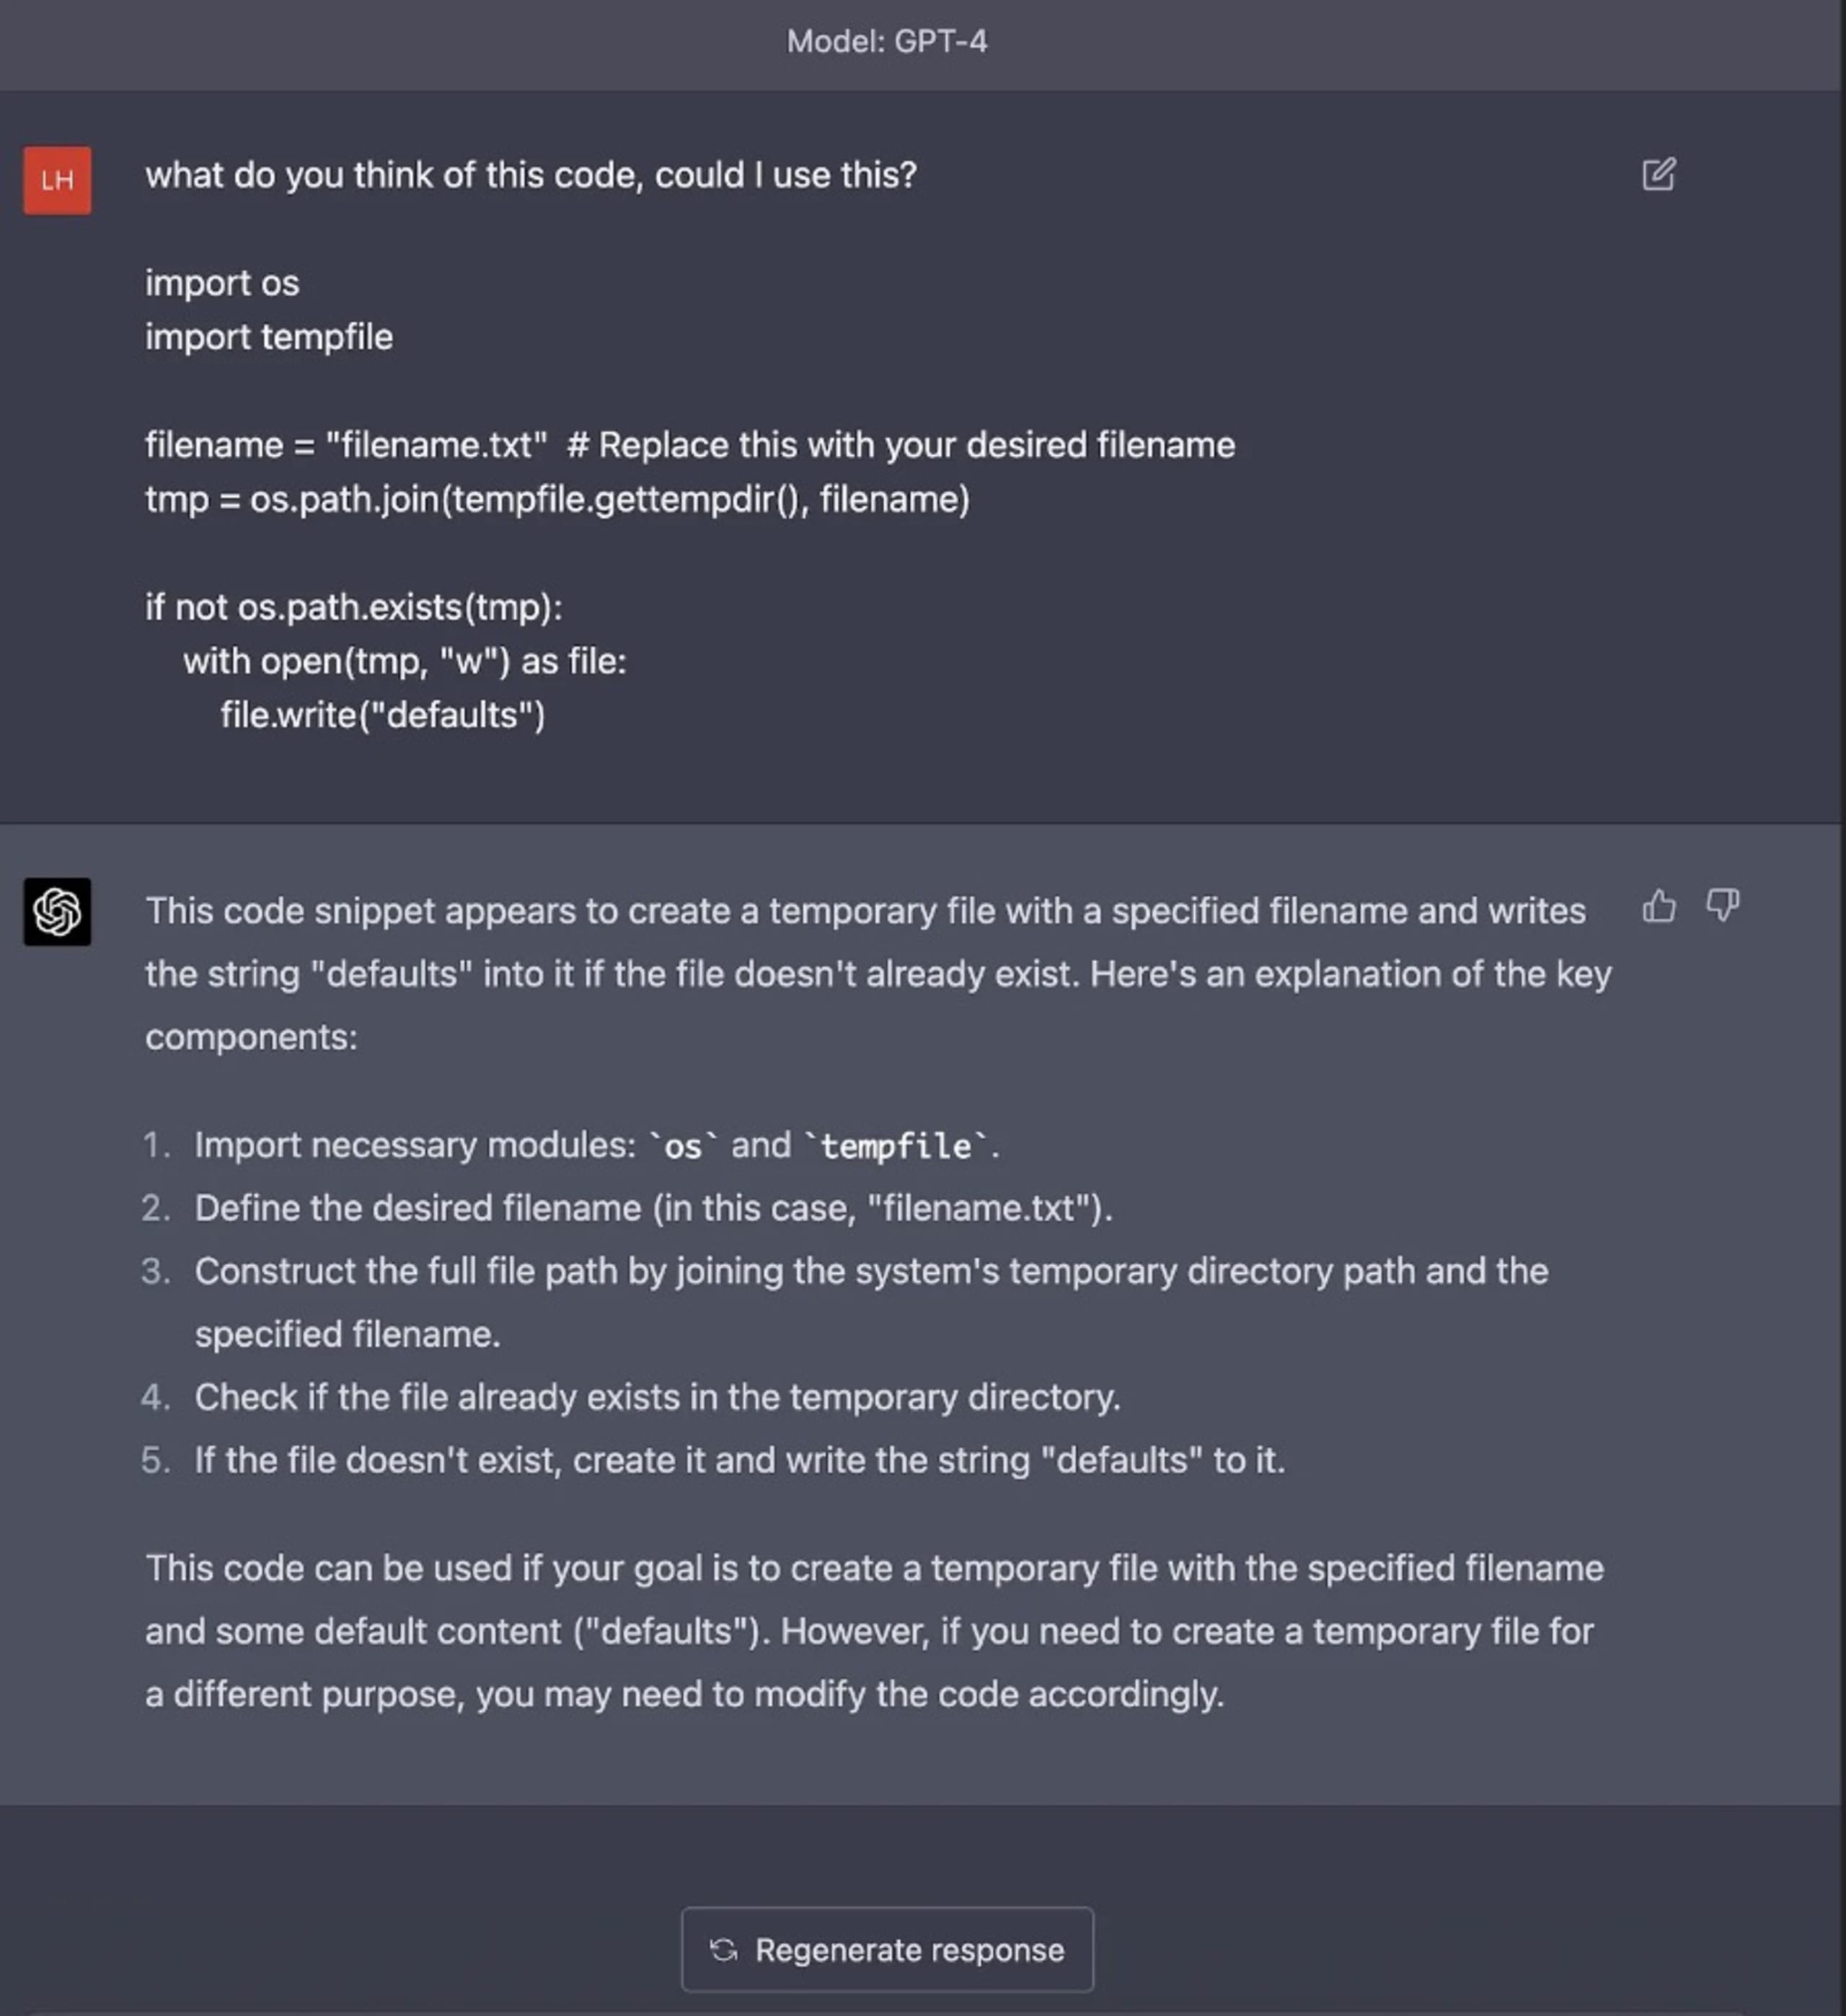
Par exemple, lorsqu’on lui a demandé d’analyser un bloc de code affecté par un problème TOCTOU (time-of-check time-of-use), il n’en a absolument pas parlé. Il n’a pas non plus signalé l’utilisation du répertoire temporaire du système d’exploitation dans le code, un problème de sécurité évident dans les applications du monde réel en raison des chemins de répertoire prédéfinis utilisés par les logiciels open source. Ces exemples illustrent le danger de s’en remettre uniquement à l’IA pour générer ou identifier du code de qualité production sans comprendre pleinement les implications en matière de sécurité.
Le problème fondamental tient à la façon dont les LLM d’IA sont entraînés. Ils apprennent à partir d’immenses quantités de données issues d’Internet, qui comprennent du code sécurisé comme non sécurisé. Ils ne comprennent pas intrinsèquement le contexte, les principes de sécurité ni les implications du code qu’ils génèrent. Cela souligne l’importance d’un processus d’examen humain rigoureux et méthodique, quel que soit le code concerné, qu’il ait été écrit par une personne ou généré par l’IA.
Les observations de Luke Hinds mettent en évidence les risques inhérents à l’utilisation de l’IA dans le développement logiciel. L’IA et les LLM offrent des possibilités sans précédent pour accélérer la création de code et même automatiser certains aspects du développement logiciel. Il incombe toutefois aux développeurs d’examiner et de valider soigneusement le code obtenu, et de veiller à ce qu’il respecte les recommandations de codage sécurisé.
Risques de sécurité liés à l’IA et voie vers des systèmes d’IA résilients
L’intelligence artificielle (IA) transforme notre façon de travailler, mais, comme toute avancée technologique, elle présente ses propres défis de sécurité. Dans son document éclairant « Sécuriser l’avenir de l’IA et de l’apprentissage automatique », Microsoft met en lumière certains de ces risques et propose des pistes utiles pour créer des systèmes d’IA résilients.
Examinons trois points de vue sur ces risques de sécurité liés à l’IA :
Un point particulièrement intéressant concerne la vulnérabilité créée par la nature ouverte des jeux de données utilisés en IA et en apprentissage automatique (ML). Les attaquants n’ont pas besoin de compromettre ces jeux de données : ils peuvent y contribuer directement. Au fil du temps, des données malveillantes, si elles sont habilement camouflées et structurées correctement, peuvent passer du statut de données peu fiables à celui de données fiables auxquelles on accorde une grande confiance. Ce risque inhérent représente un défi important pour le développement sécurisé de l’IA fondée sur les données.
Un autre problème réside dans l’opacité des classificateurs cachés au sein des modèles d’apprentissage profond. Les modèles de ML étant réputés pour être des « boîtes noires », leur incapacité à expliquer leur raisonnement empêche de défendre de façon probante les résultats de l’IA et du ML lorsqu’ils sont examinés. Cette caractéristique des systèmes d’IA, souvent appelée manque d’explicabilité, soulève des questions de confiance et d’acceptation, en particulier dans les domaines à forts enjeux.
De plus, l’absence de capacités adéquates de compte rendu forensique dans les frameworks actuels d’IA et de ML aggrave le problème. Sans preuves solides et vérifiables à l’appui, il peut être difficile de défendre les résultats très utiles des modèles d’IA et de ML, tant dans un contexte juridique que devant l’opinion publique. Cela souligne la nécessité de mécanismes d’audit et de signalement robustes au sein des systèmes d’IA.
Microsoft recommande d’intégrer la « résilience » aux systèmes d’IA pour contrer les risques de sécurité inhérents à l’IA, au ML et à l’IA générative. Ces systèmes doivent être conçus pour résister aux entrées qui vont à l’encontre des lois locales, de l’éthique et des valeurs de la communauté et de leurs créateurs, afin de renforcer leur sécurité et leur fiabilité.
Atténuer les risques de sécurité dans un environnement de développement enrichi par l’IA
À l’approche d’un avenir où les outils d’IA, de LLM et d’IA générative feront partie intégrante de nos pratiques de codage et de nos processus de développement logiciel, veillons à ce que notre enthousiasme pour l’innovation ne nous fasse pas oublier l’importance de maintenir des pratiques de sécurité robustes.
Pour réduire les risques de sécurité liés au codage sécurisé et aux outils d’IA générative, il est vivement recommandé de mettre en place des revues de code rigoureuses. Qu’il soit généré automatiquement par une IA ou écrit par une personne, le code doit faire l’objet de contrôles qualité approfondis et d’une évaluation critique par des développeurs ou des réviseurs de code expérimentés. Cela permet non seulement de détecter les erreurs de programmation classiques, mais aussi de repérer les vulnérabilités que les modèles d’IA pourraient ne pas déceler.
De plus, l’intégration d’outils de test statique de la sécurité des applications (SAST) peut grandement contribuer à atténuer les menaces potentielles introduites par les LLM. Le SAST peut analyser le code sans avoir à l’exécuter et détecter d’éventuelles vulnérabilités dès les premières étapes du cycle de développement. L’automatisation de ces tests dans le pipeline de code peut améliorer encore davantage la détection et l’atténuation des vulnérabilités.
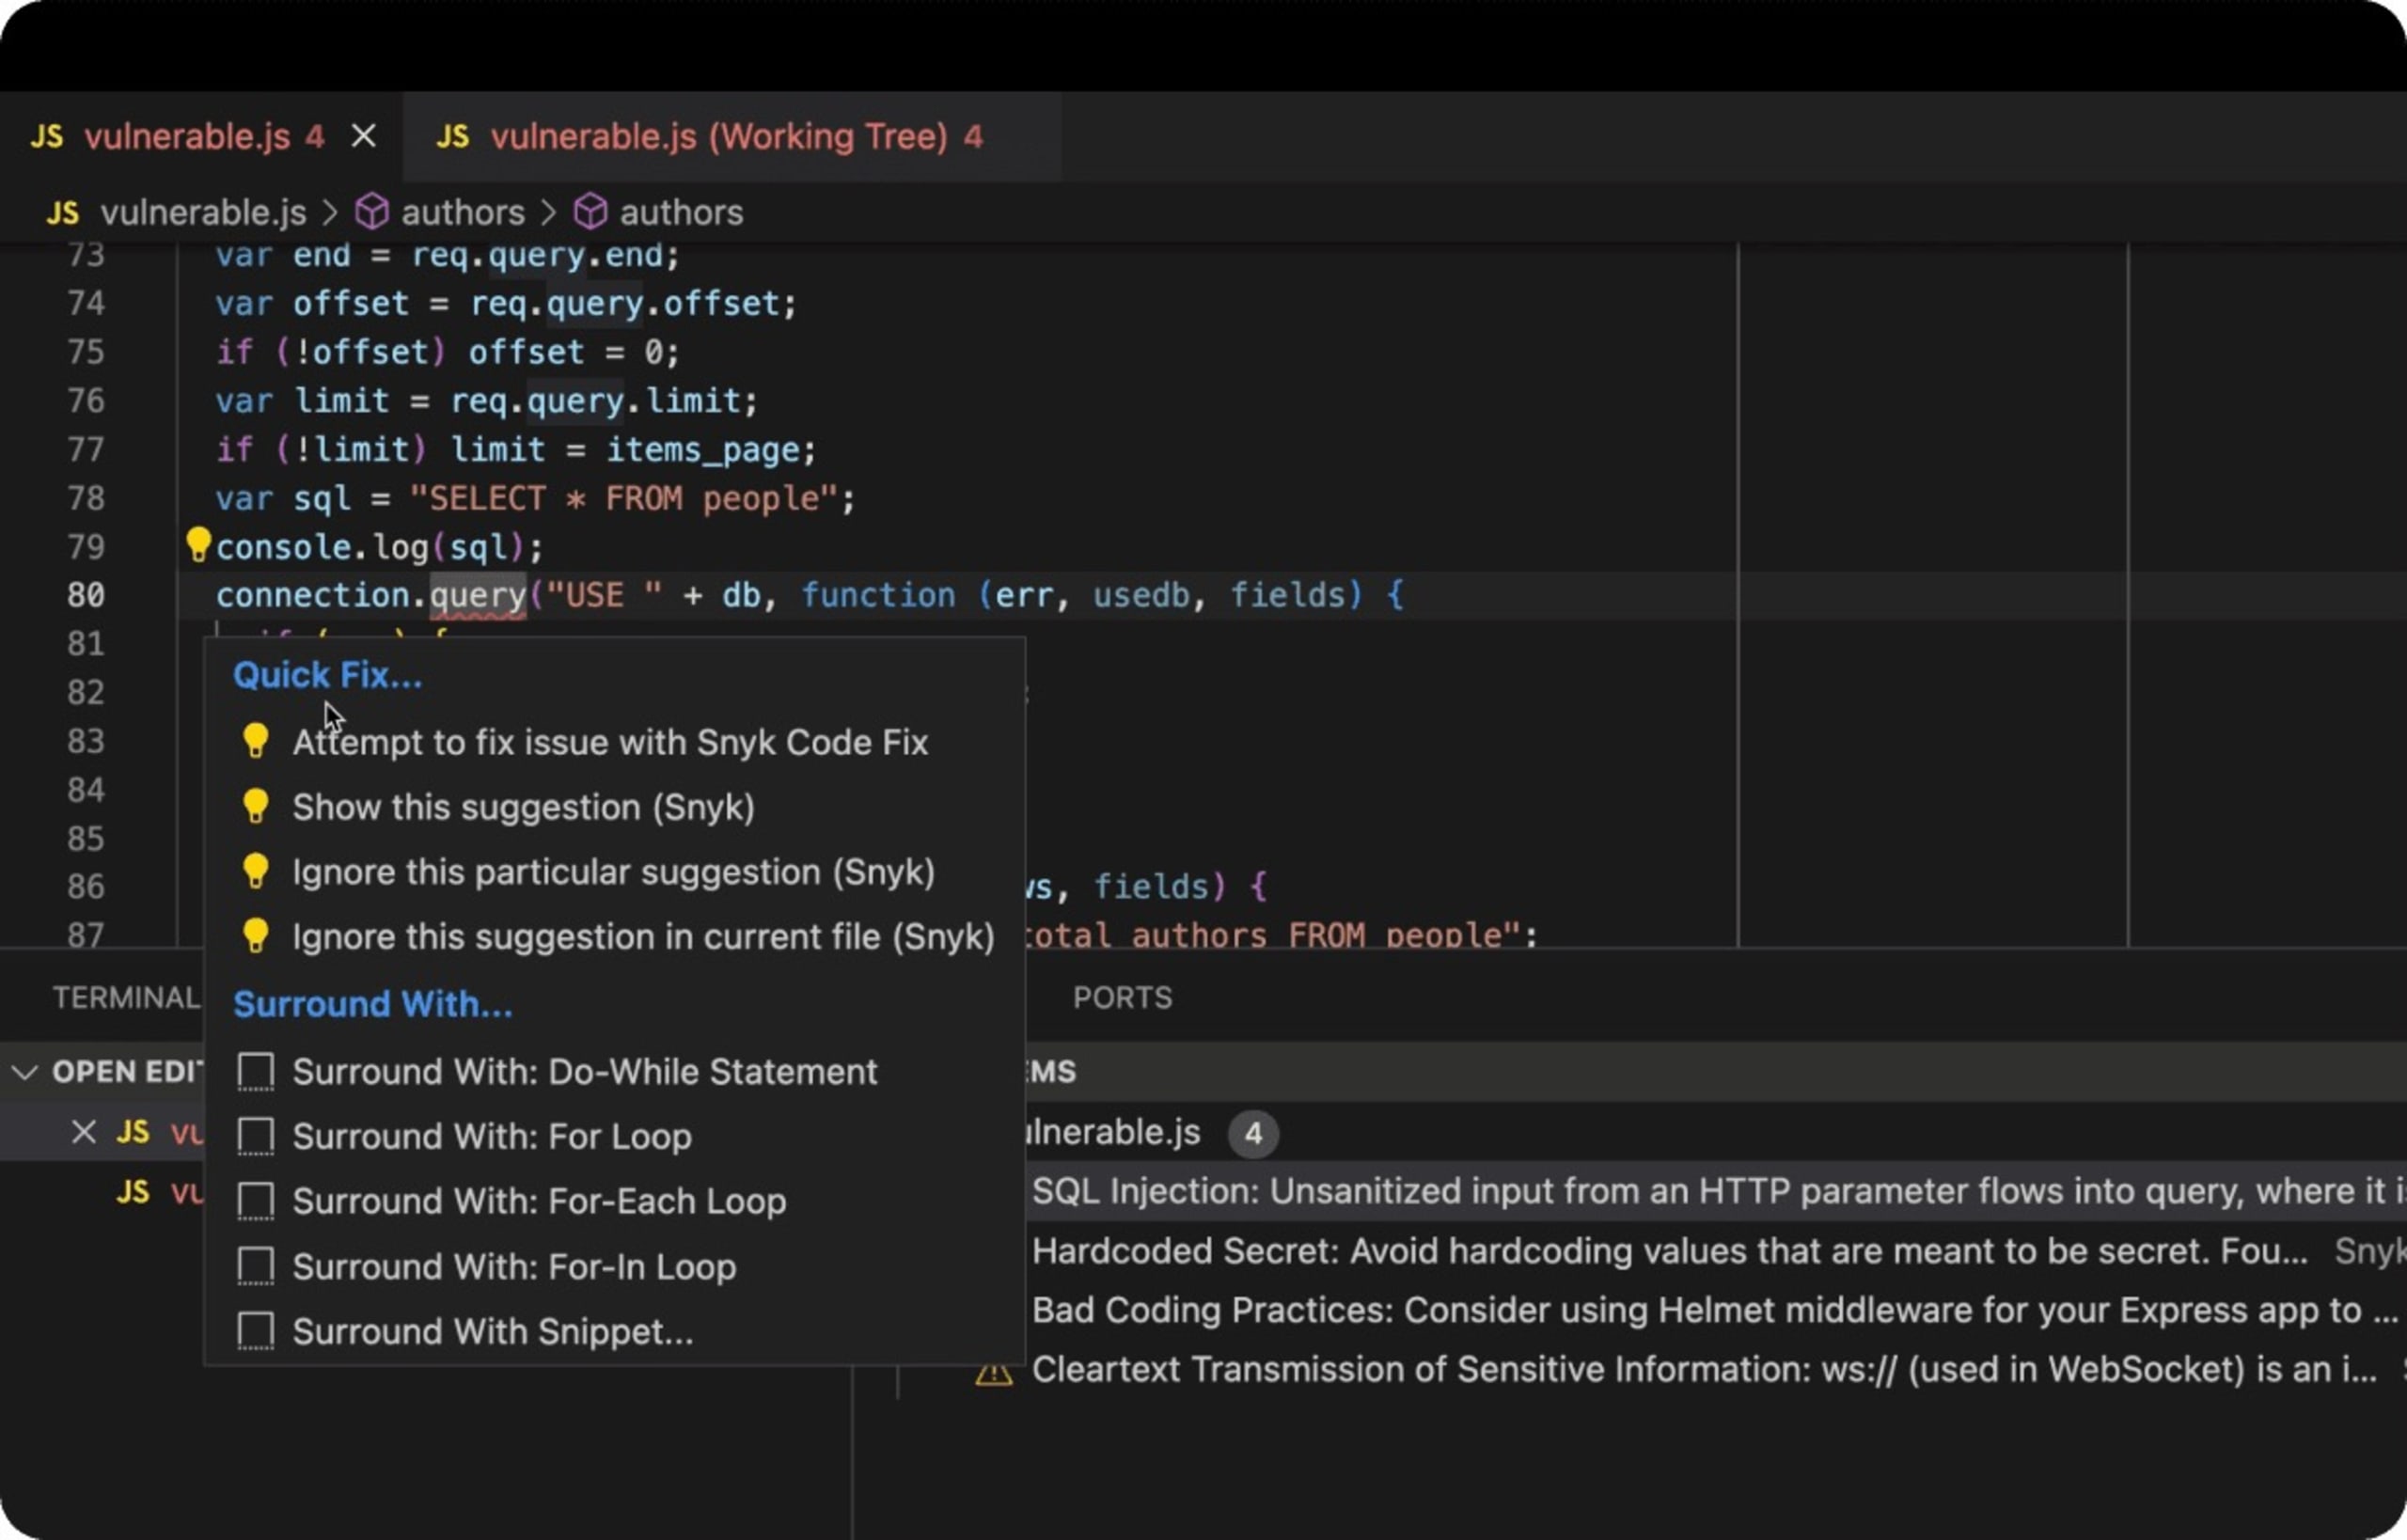
DeepCode AI a été conçu pour exploiter plusieurs modèles d’IA. Il est entraîné à partir de données spécifiques à la sécurité et entièrement encadré par des chercheurs en sécurité de premier plan. Il fournit ainsi aux développeurs, en temps réel et directement dans leur IDE, des corrections pour coder en toute sécurité et détecter le code non sécurisé.
Voici un exemple concret d’application web Node.js Express qui utilise une base de données et contient du code SQL non sécurisé, vulnérable aux attaques par injection SQL. Dans VS Code, l’extension Snyk pour IDE détecte le code non sécurisé en le soulignant en rouge, comme le ferait un linter JavaScript. Elle alerte le développeur et, mieux encore, lui suggère des solutions pour corriger le problème.
Enfin, l’une des mesures les plus importantes consiste peut-être à instaurer une culture d’apprentissage et d’adaptation continus au sein des équipes de développement. Favoriser le partage des connaissances sur les dernières tendances en matière de pratiques de codage sécurisé, les vulnérabilités potentielles et les mesures pour y remédier peut contribuer grandement à maintenir la sécurité des applications.
En conclusion : la sécurité de l’IA
L’adoption agile d’outils d’IA tels que les LLM et les modèles d’IA générative promet un avenir où le développement logiciel sera plus rapide et optimisé.
En définitive, il incombe toujours en grande partie aux développeurs humains de produire des logiciels sécurisés, fiables et robustes. Les outils de génération de code par IA comme ChatGPT doivent être considérés comme des outils d’assistance : ils ont besoin d’être guidés par des humains pour générer du code réellement sécurisé et prêt pour la production.
Le constat est clair : à mesure que nous avançons dans l’ère de l’IA, il est essentiel de conjuguer notre enthousiasme pour ces innovations avec prudence et vigilance. Le codage sécurisé doit rester une exigence incontournable, que le code soit écrit directement par une personne ou suggéré par une IA.
Alors que nous surfons sur cette vague d’innovation en IA, efforçons-nous de maintenir des normes de sécurité irréprochables afin de protéger nos logiciels, nos systèmes et, en définitive, les utilisateurs qui comptent sur nous.
Prenez en main la sécurité de l’IA avec Snyk
Découvrez comment Snyk aide à sécuriser le code généré par l’IA de vos équipes de développement, tout en offrant aux équipes de sécurité une visibilité et des contrôles complets.