VulnBump: ¿Pueden los agentes de IA corregir dependencias vulnerables sin romper la compilación?


15 de octubre de 2026
0 minutos de lectura¿Pueden los agentes de IA corregir dependencias vulnerables sin romper la compilación? La corrección en sí rara vez es un misterio. Durante seis meses de 2026, Snyk Open Source registró 459 millones de hallazgos de vulnerabilidades en unas 300.000 organizaciones. El 94 % de estas vulnerabilidades tenía una versión corregida conocida; aun así, solo se había resuelto alrededor del 10 %.
Esto ocurre porque lo difícil es actualizar de forma segura: la mayoría de los paquetes vulnerables se importan de manera transitiva, alrededor de una cuarta parte de las correcciones requiere un salto a una versión principal y, aunque se supone que las versiones menores y los parches son compatibles con versiones anteriores, a menudo incluyen cambios que causan incompatibilidades.
VulnBump, una nueva investigación que publicamos en Snyk, pone a prueba agentes de IA con 307 actualizaciones reales de dependencias vulnerables. Una actualización cuenta como APROBADA solo si desaparecen las vulnerabilidades y el proyecto sigue instalándose, compilándose y pasando las pruebas.
Novedad: hasta donde sabemos, VulnBump es el primer benchmark de agentes de IA centrado en actualizaciones motivadas por seguridad: cada tarea parte de vulnerabilidades reales que Snyk encontró en un proyecto real, con seis administradores de paquetes. Los benchmarks de actualización anteriores solo comprueban si algo se rompe, no si desaparece la vulnerabilidad.
Entonces, ¿pueden los agentes de IA corregir dependencias vulnerables sin romper la compilación? En general, sí, pero el modelo por sí solo no determina el resultado. Con el mismo modelo, Claude Sonnet 5.5, Evo Remediation Agent de Snyk aprobó el 90,2 % de las actualizaciones. Claude Code de Anthropic aprobó el 77,5 % con la actualización recomendada y el análisis de Snyk (Claude Code + análisis de Snyk), y el 59,6 % sin datos de Snyk (Claude Code sin ayuda). La diferencia supera los 30 puntos porcentuales. Como referencia, la actualización con el administrador de paquetes —una línea base sin IA que solo aplica la versión recomendada por Snyk— ya aprobó el 46,9 %.
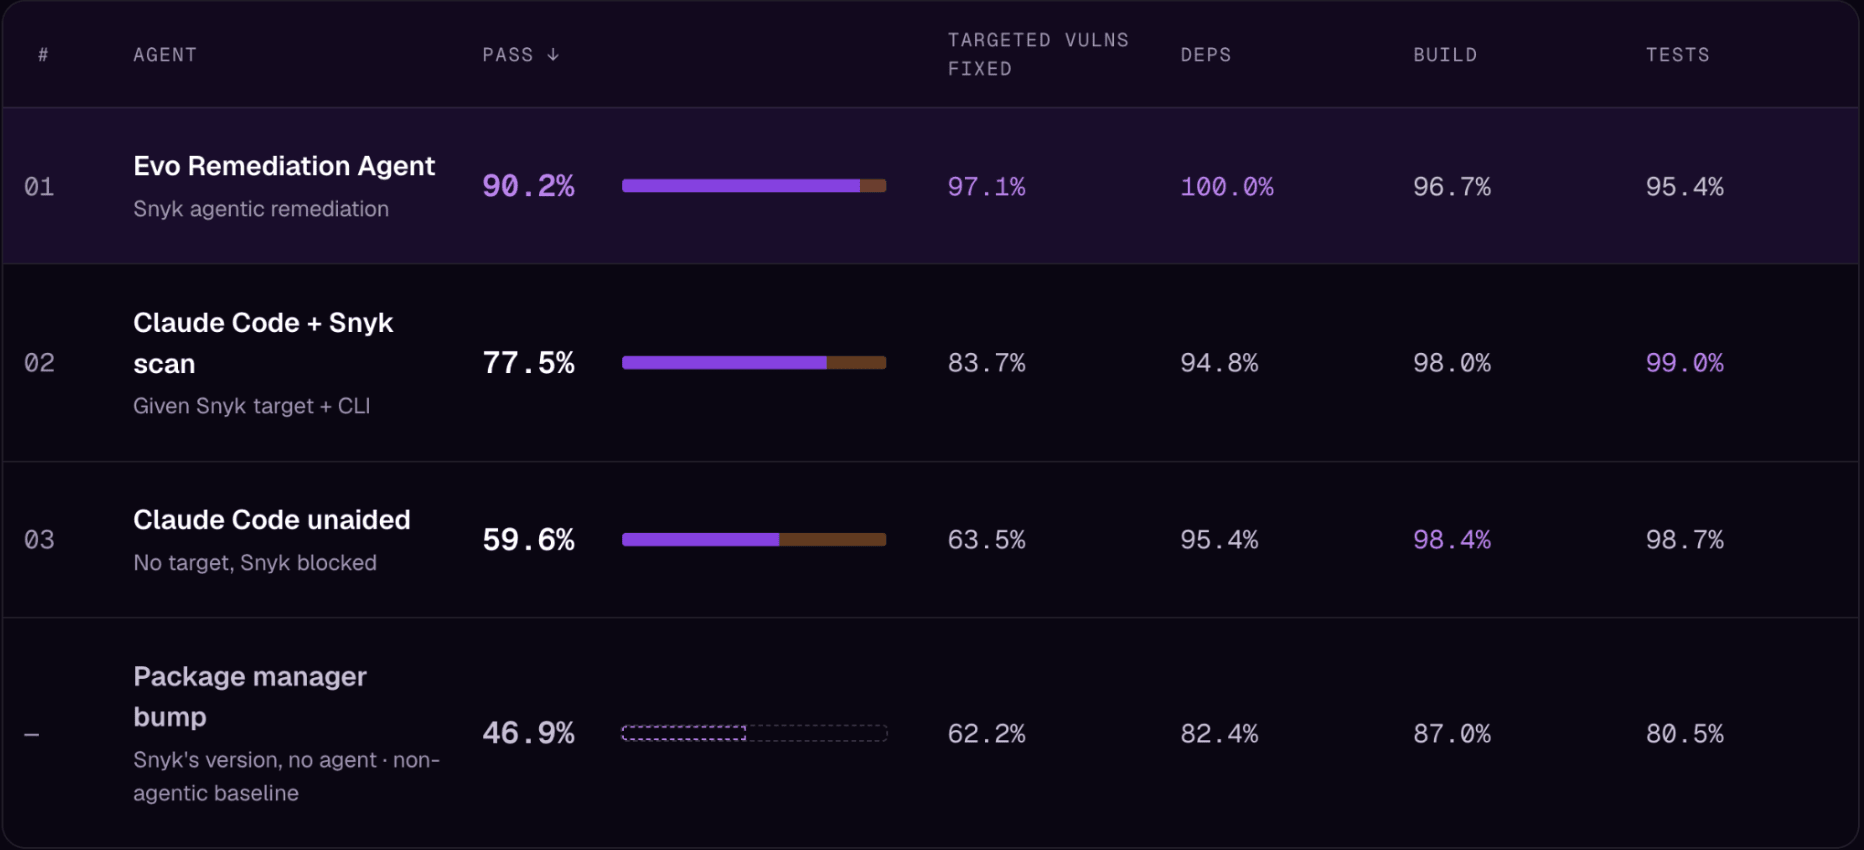
Resultados clave de VulnBump
Mantener la compilación sin errores no fue lo difícil: los tres agentes lo lograron alrededor del 93 % de las veces. Lo difícil fue eliminar la vulnerabilidad. En 70 de sus 124 fallas, Claude Code, sin ayuda, afirmó haber corregido vulnerabilidades que seguían apareciendo en un nuevo análisis.
Nuestros hallazgos coinciden con los de VulnBench, nuestro benchmark de junio sobre revisión de seguridad con IA, que descubrió que Claude y Snyk Code pasan por alto vulnerabilidades diferentes y concluyó que funcionan mejor en conjunto. VulnBump prueba una tarea distinta —actualizar dependencias de código abierto vulnerables— y apunta a la misma conclusión: con la versión recomendada y el análisis de Snyk, la tasa de aprobación de Claude Code aumentó 17,9 puntos. Evo Remediation Agent demuestra cuánto más puede lograr un agente diseñado específicamente para este fin: 12,7 puntos más que Claude Code con el mismo análisis de Snyk. VulnBump también amplía los resultados de remediación que compartimos en mayo, ahora con un modelo más reciente y seis administradores de paquetes.
Cómo creamos VulnBump
Partimos de proyectos reales que reflejan entornos de producción. Recopilamos 767 proyectos candidatos de GitHub, incluidos proyectos populares de código abierto y repositorios que fijan paquetes conocidos por ser vulnerables. Antes de cualquier cambio, cada uno debía instalarse, compilarse y pasar más del 85 % de sus pruebas; además, Snyk debía encontrar al menos una vulnerabilidad. De los 99 que cumplían los requisitos, elegimos 43 que coinciden con los datos de producción de Snyk en cuanto a ecosistema, gravedad de las vulnerabilidades, dependencias directas frente a transitivas y tamaño del salto de versión.

Comparación del conjunto de datos de VulnBump con los datos de producción de Snyk Open Source
Convertimos cada actualización recomendada en una tarea. Cada tarea le pide al agente que aplique una actualización recomendada por Snyk: un paquete, actualizado a una versión que corrige sus vulnerabilidades. Cada tarea parte de una copia nueva del proyecto y se evalúa de forma independiente. Los 43 repositorios generan 307 tareas que abarcan 2.066 vulnerabilidades corregibles y los seis administradores de paquetes que representan alrededor del 92 % de los hallazgos en producción: Maven, Gradle, npm, Yarn, pip y Poetry.
Agregamos un verificador que no confiaba en el agente. Cuando el agente terminaba, copiábamos sus cambios en un contenedor limpio y los comprobábamos desde cero. Allí, un intento solo contaba como APROBADO si superaba las cuatro verificaciones:
Las dependencias se instalan con el comando que ejecutaría CI.
Un nuevo análisis de Snyk confirma que las vulnerabilidades desaparecieron.
El proyecto se compila.
Todas las pruebas que pasaban antes siguen pasando.

El flujo de VulnBump
Los entornos de prueba que evaluamos. Los tres agentes usaron Claude Sonnet 5.5, con un límite de 110 turnos por actualización y el mismo contenedor para cada lenguaje:
Evo Remediation Agent es el motor de remediación agéntica de Snyk. Usa la inteligencia de Snyk y puede ejecutar sus propios análisis, compilaciones y pruebas, además de corregir errores antes de terminar. Lo ejecutamos en modo de aprobación automática, así que aplicó todas las correcciones, incluidas las actualizaciones que Snyk considera propensas a romper la compilación.
Claude Code con análisis de Snyk es el agente de programación de propósito general de Anthropic, al que se le proporciona la recomendación de Snyk para la actualización: el paquete que debe actualizar, la versión de destino y las vulnerabilidades que corrige. También puede ejecutar un análisis de Snyk Open Source para comprobar su trabajo.
Claude Code sin ayuda recibe la misma tarea, pero sin la versión de destino ni acceso a Snyk. Debe determinar por su cuenta qué versión corrige las vulnerabilidades, por ejemplo, buscando en bases de datos de vulnerabilidades en la web.
La actualización con el administrador de paquetes es la línea base sin agentes: aplica la versión recomendada por Snyk con el administrador de paquetes propio del proyecto y no cambia nada más.
En el artículo de investigación: VulnBump: Un benchmark para corregir dependencias vulnerables en proyectos reales y mantener la compilación y las pruebas sin errores se explica cómo elegimos los repositorios, los prompts exactos y las herramientas disponibles para cada agente, y cómo controlamos la filtración de información. También se detallan las limitaciones: probamos un solo modelo, ejecutamos cada actualización una vez y usamos Snyk Open Source como juez, lo que solo puede perjudicar a Claude Code sin ayuda, ya que los otros dos agentes trabajan con los mismos hallazgos de Snyk. Tampoco penalizamos las nuevas vulnerabilidades que introdujo una actualización.
Resultado 1: El mismo modelo, tres resultados distintos
Evo Remediation Agent superó todas las verificaciones en el 90,2 % de las actualizaciones (y corrigió el 95,9 % de las 2.066 instancias de vulnerabilidad). Son 12,7 puntos más que Claude Code + análisis de Snyk —aproximadamente una corrección funcional más cada ocho actualizaciones— y 30,6 puntos más que Claude Code sin ayuda.
Y la clasificación no depende solo de unos pocos repositorios grandes: al promediar las tasas de aprobación por repositorio, los resultados fueron 93,1 % para Evo Remediation Agent, 80,1 % para Claude Code + análisis de Snyk, 68,0 % para Claude Code sin ayuda y 51,3 % para la actualización con el administrador de paquetes.
Hallazgo clave:
Evo Remediation Agent completa de principio a fin 9 de cada 10 actualizaciones motivadas por vulnerabilidades.
Resultado 2: Los agentes deben saber qué versión es realmente segura
Con el mismo modelo, proporcionarle a Claude Code el análisis de Snyk y la actualización recomendada aumentó su tasa de aprobación 17,9 puntos: del 59,6 % al 77,5 %.
La diferencia más clara está en la versión que elige. Sin ayuda, Claude Code eligió una versión que Snyk todavía marca como vulnerable en 64 casos. Con el análisis de Snyk, esa cifra bajó a 13. Las bases de datos de vulnerabilidades no siempre coinciden en qué versión corrige una vulnerabilidad, así que una versión que parece segura en una fuente puede seguir apareciendo como vulnerable en otra.
La guía de Snyk es más importante para las vulnerabilidades transitivas, presentes en paquetes que el proyecto no declara directamente. Si contamos solo las actualizaciones que superaron todas las verificaciones, más que duplicó la proporción de vulnerabilidades transitivas que Claude Code corrigió: del 28 % al 59 %.
Hallazgo clave:
El análisis de Snyk y la versión objetivo aumentaron en 17,9 puntos la tasa de aprobación de Claude Code y más que duplicaron las vulnerabilidades transitivas que corrigió.
Resultado 3: Las recomendaciones de Snyk por sí solas resuelven cerca de la mitad; después, los agentes marcan la diferencia
La actualización con el administrador de paquetes divide las 307 actualizaciones en dos grupos: en las 144 que aprueba, basta con la versión recomendada por Snyk y un agente solo puede mantener o echar a perder una corrección sencilla. Las otras 163 requieren algo más que cambiar de versión, como adaptar el código a cambios incompatibles o resolver conflictos entre dependencias.

Agentes en las 144 actualizaciones que se resuelven con las recomendaciones de Snyk y en las otras 163
Con la guía de Snyk, los agentes casi nunca rompen lo que resuelve la actualización; en cambio, Claude Code sin ayuda tuvo regresiones en 20 de las 144, y en 15 de ellas eligió una versión que Snyk todavía marca como vulnerable. La diferencia real se nota en la mitad difícil: de las otras 163 actualizaciones, Evo Remediation Agent aprobó el 82,2 %, Claude Code + análisis de Snyk el 61,3 % y Claude Code por sí solo el 36,2 %.
Hallazgo clave:
De las 163 actualizaciones que requieren más que cambiar la versión, Evo Remediation Agent aprobó el 82,2 %, frente al 61,3 % de Claude Code + análisis de Snyk y al 36,2 % de Claude Code sin ayuda.
Resultado 4: Una compilación sin errores puede ocultar una vulnerabilidad sin corregir
La manera más fácil de mantener una compilación sin errores es dejar la vulnerabilidad intacta, y eso fue principalmente lo que observamos en las fallas de Claude Code. El nuevo análisis fue la primera verificación que falló en 107 de las 124 fallas de Claude Code sin ayuda, en 48 de las 69 fallas de Claude Code + análisis de Snyk y en 9 de las 30 fallas de Evo Remediation Agent.
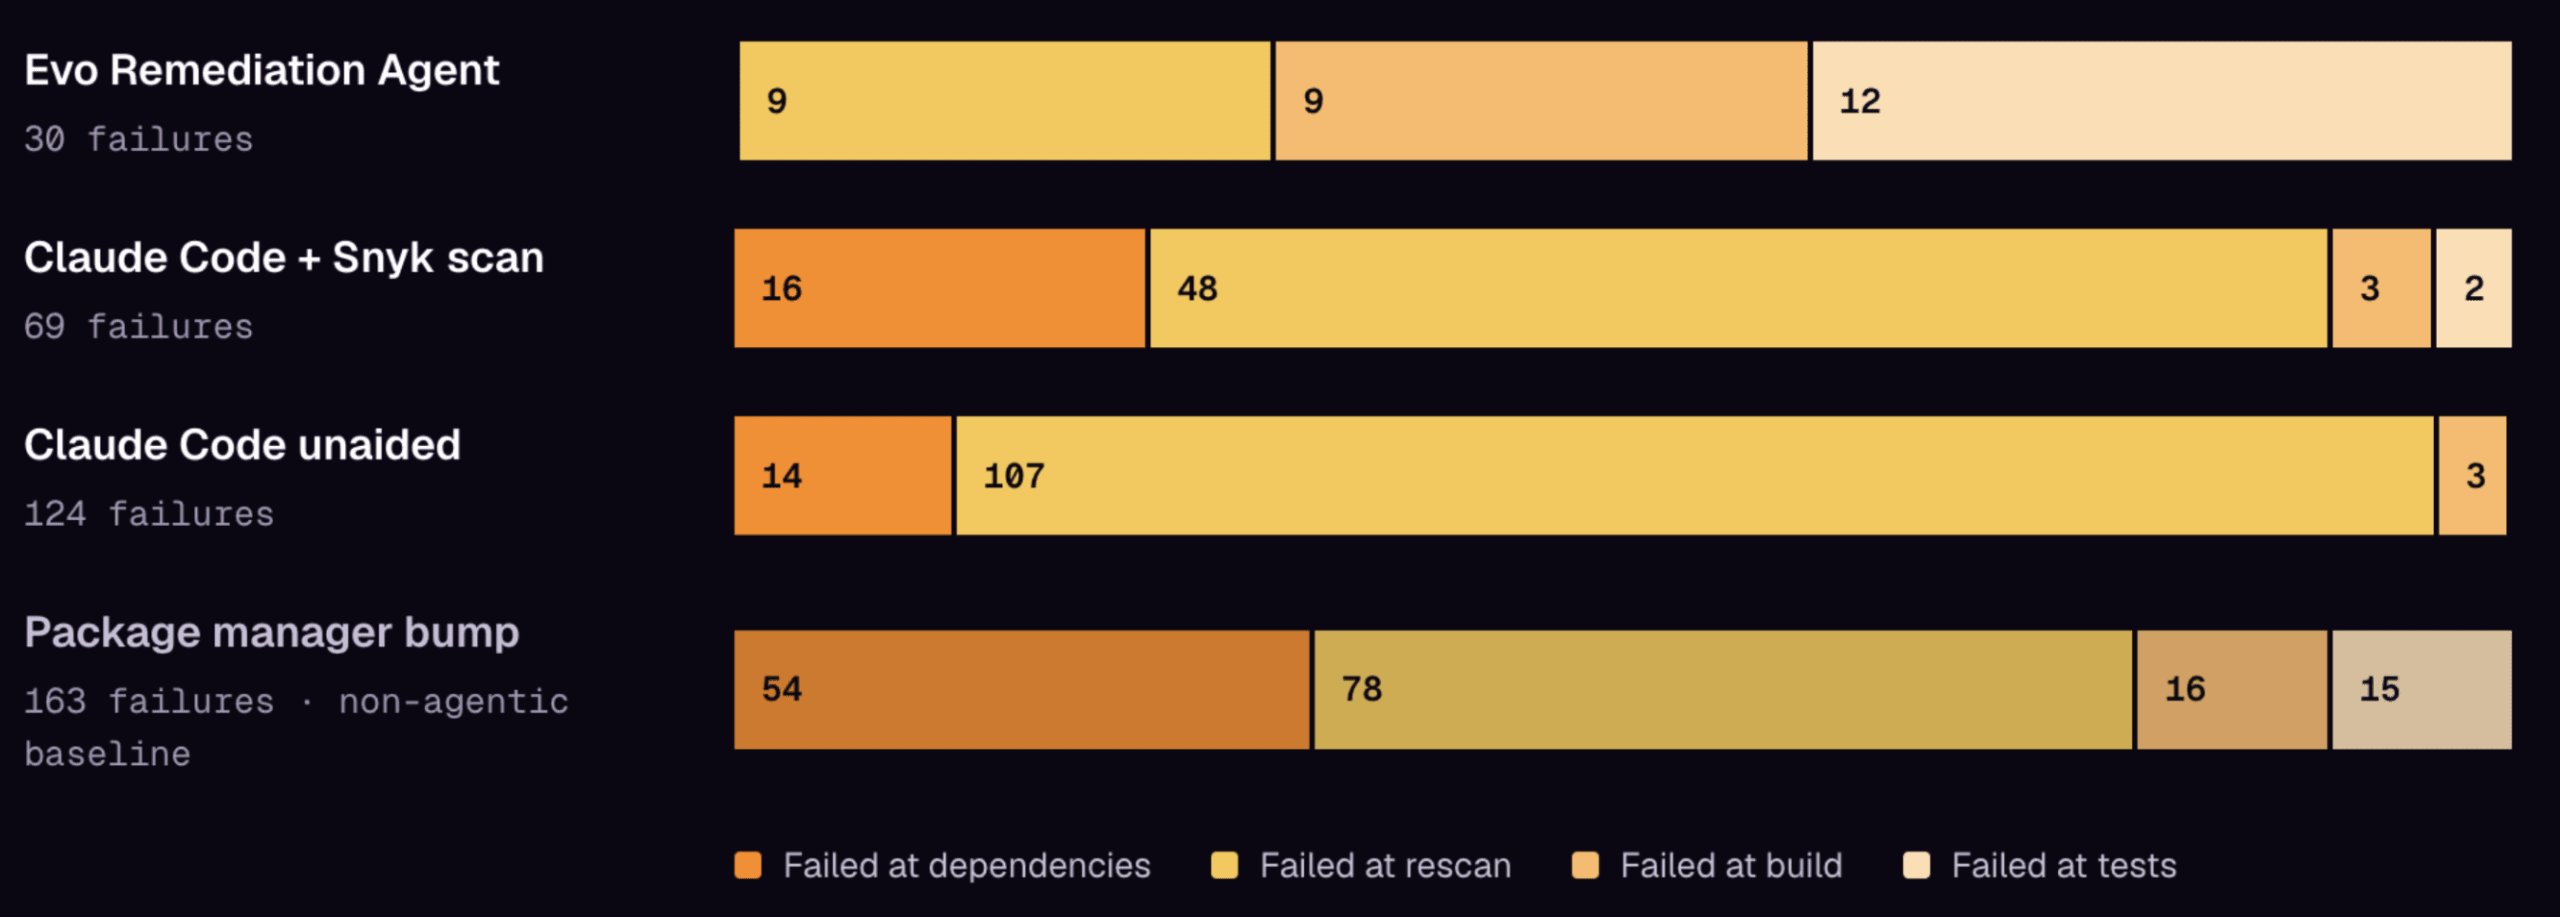
Primera verificación que falló en cada intento no aprobado
Las fallas de Evo Remediation Agent son visibles (y eso no es malo). 21 de sus 30 fallas rompieron la compilación o las pruebas, en su mayoría durante actualizaciones principales que los otros agentes suelen evitar. Una falla evidente es mucho más segura que una silenciosa: cuando una actualización sale mal, la compilación y las pruebas del proyecto lo muestran, así que un desarrollador puede verlo y actuar al respecto.
Hallazgo clave:
Los agentes de propósito general fallan sin avisar; Evo Remediation Agent falla cuando CI lo detecta.
Resultado 5: Saber cuál es la versión de destino no es suficiente
El análisis de Snyk ayuda mucho a Claude Code, pero hacer bien la actualización requiere más: con los mismos hallazgos y versiones de destino, Evo Remediation Agent aprobó 39 actualizaciones más que Claude Code con análisis de Snyk, 23 de ellas con saltos a versiones principales.
Evo Remediation Agent combina la inteligencia de Snyk con un ciclo en el que compila, prueba y repara el proyecto antes de terminar. Aunque nuestra configuración no permite aislar qué componente marca la diferencia, sí muestra cuánto puede influir en el resultado el sistema que rodea a un modelo, en línea con DepBench, donde cambiar solo el entorno de prueba modificó los resultados hasta en 16,3 puntos.
Hallazgo clave:
Mismo modelo, mismos hallazgos de Snyk: Remediation Agent de Evo sigue superando por 12.7 puntos.
Resultado 6: Los grandes saltos de versión y las dependencias transitivas siguen siendo las tareas más difíciles
Todos los agentes siguen teniendo dificultades con las migraciones importantes de frameworks: 23 actualizaciones, en su mayoría migraciones de Spring, Spring Boot y Dropwizard, superaron a los tres agentes.
En las actualizaciones principales frente a las que no lo son, las tasas de aprobación bajaron del 96 % al 81 % para Evo Remediation Agent, del 88 % al 61 % para Claude Code + análisis de Snyk y del 70 % al 42 % para Claude Code sin ayuda, respectivamente. Las actualizaciones principales también son aquellas que requieren cambios en el código: aproximadamente la mitad de las aprobaciones de Evo Remediation Agent para actualizaciones principales modificaron el código fuente de la aplicación, frente al 5 % de sus aprobaciones para actualizaciones no principales.
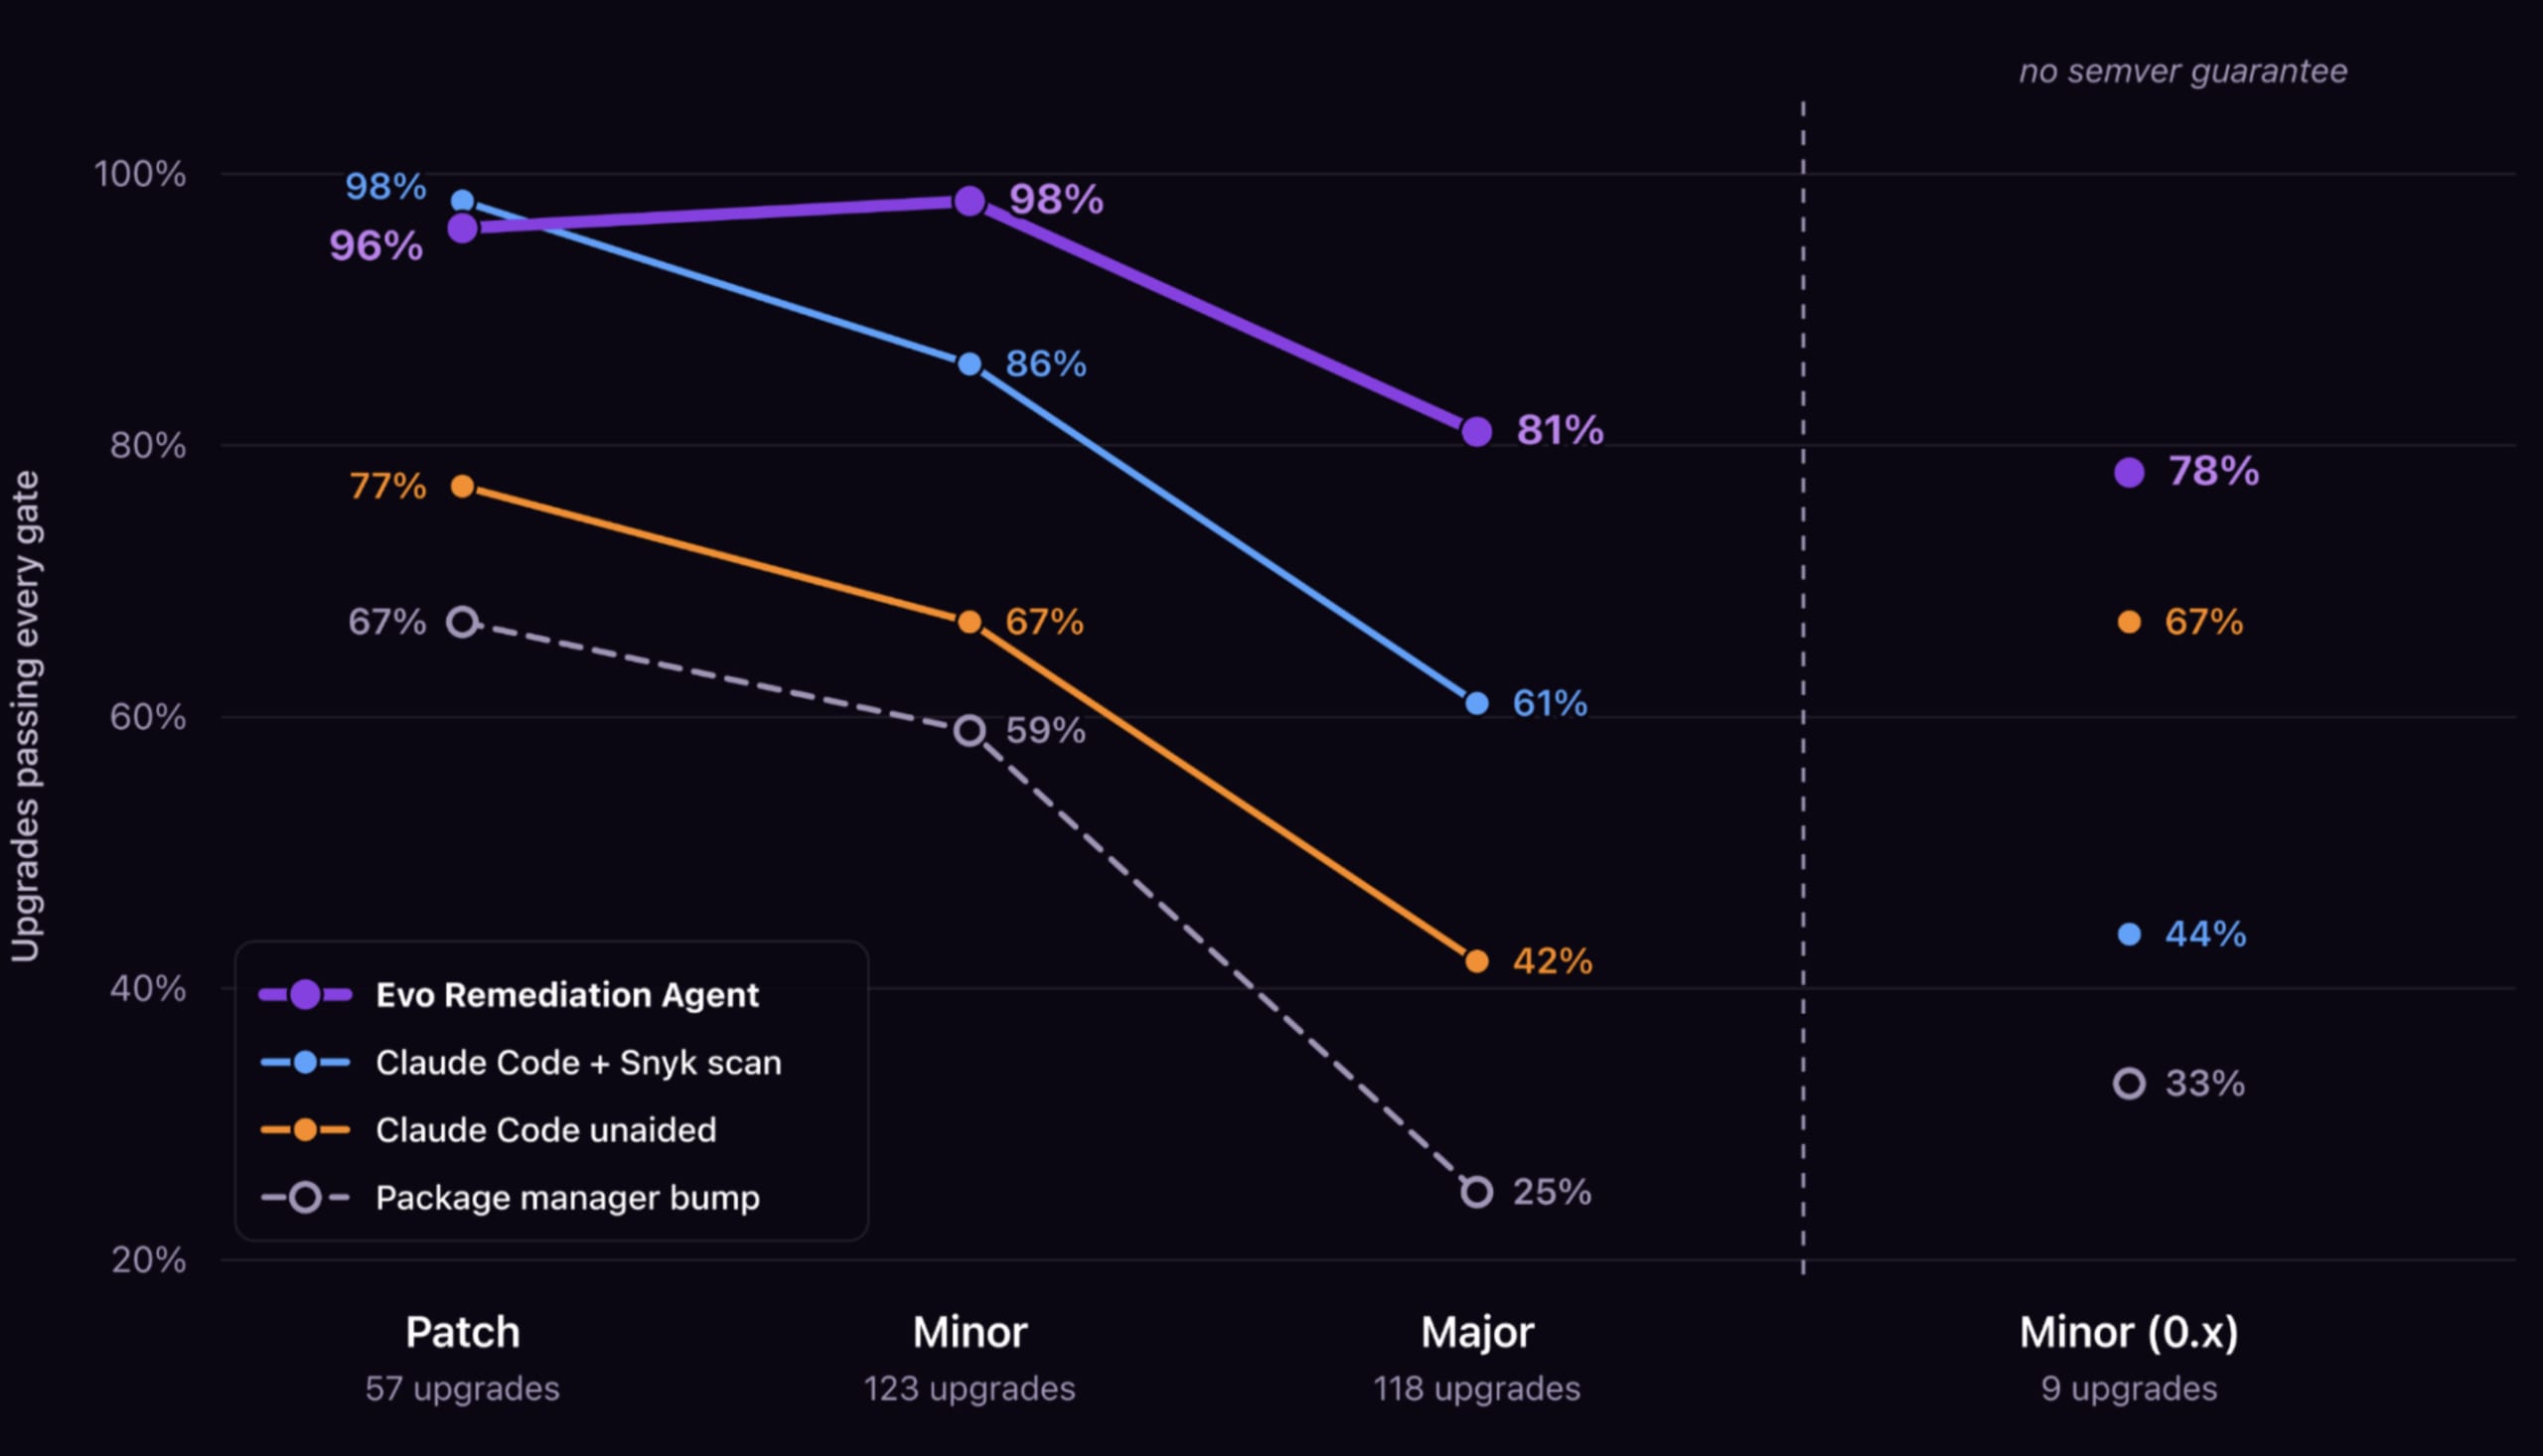
Actualizaciones que superaron todas las verificaciones, según el tamaño del salto de versión
Las vulnerabilidades transitivas, en las que el paquete vulnerable no está declarado en el manifiesto, representan el 70 % de las instancias corregibles y son más difíciles para todos los entornos de prueba evaluados. Si contamos solo las correcciones de intentos que superaron todas las verificaciones, Evo Remediation Agent corrigió el 73 % de las instancias transitivas, Claude Code + análisis de Snyk el 59 % y Claude Code sin ayuda el 28 %. En el caso de las instancias directas, las cifras fueron 91 %, 71 % y 62 %, respectivamente.
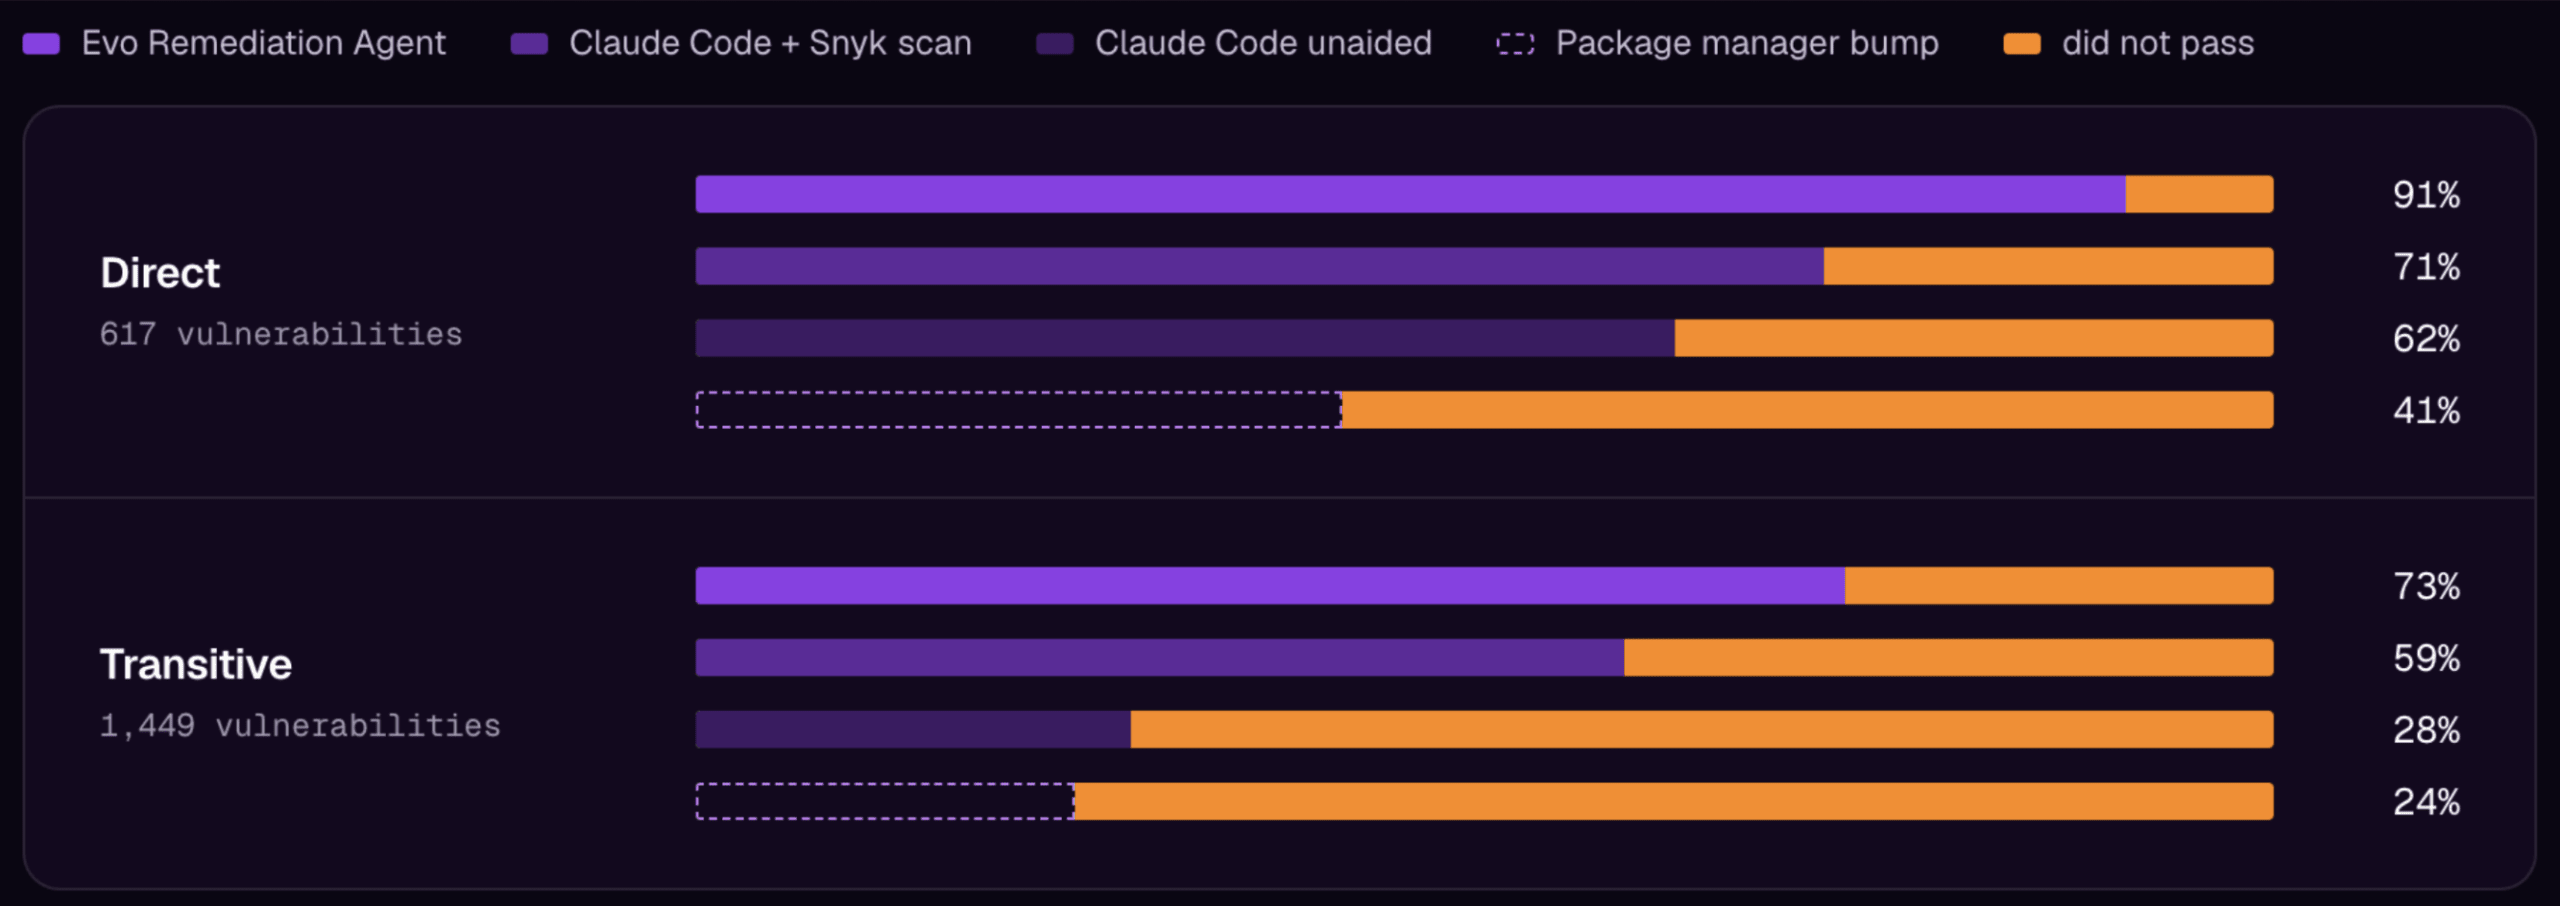
Tasa de aprobación por tipo de dependencia (directa frente a transitiva)
Hallazgo clave:
Evo Remediation Agent lidera en las actualizaciones más difíciles, las versiones principales y las dependencias transitivas, pero las migraciones importantes de frameworks siguen superando a todos los agentes.
¿Cómo se relaciona VulnBump con VulnBench?
VulnBench evalúa cómo los agentes de programación con IA encuentran vulnerabilidades en el código que escribes: con qué consistencia detectan los mismos problemas en ejecuciones repetidas y cuánto coinciden sus hallazgos con una línea base SAST determinista. VulnBump evalúa si pueden corregir vulnerabilidades en el código del que dependes: actualizar dependencias de código abierto vulnerables sin romper la compilación ni las pruebas.
Al leer ambos estudios en conjunto, se llega a la misma conclusión: los modelos aportan capacidades de razonamiento que las herramientas deterministas simplemente no tienen. Por sí solos, reportan hallazgos distintos entre ejecuciones y a menudo no llegan a corregirlos. En toda la plataforma, resumimos esa lección de forma más sencilla: el generador no puede ser el validador.
¿Qué significa esto para los equipos que delegan tareas de seguridad en agentes?
Evalúa una corrección con pruebas que el agente no generó: el informe del agente sobre su propia corrección es una afirmación, mientras que un nuevo análisis, una compilación y una ejecución de pruebas son evidencia. Si un agente corrige tu backlog, exígele las mismas comprobaciones.
Evalúa en conjunto la vulnerabilidad y la compilación: Por separado, cualquiera de las dos oculta un fallo. Las comprobaciones que solo detectan errores de compilación no identifican las vulnerabilidades que siguen sin corregirse, mientras que las que solo detectan vulnerabilidades no identifican las correcciones que rompen el proyecto.
Proporciónale los datos de seguridad al agente: El análisis de Snyk y la actualización recomendada sumaron 17.9 puntos para un agente de propósito general con el mismo modelo.
Evo Remediation Agent es el motor de remediación agéntica de Snyk, disponible a través de Snyk CLI y como servicio en la nube. Es uno de los agentes de Evo Agentic AppSec, que se lanza hoy.
Pon a prueba tu agente con VulnBump
El entorno de pruebas de VulnBump y los 43 casos de evaluación son de código abierto en github.com/snyk-labs/snyk-vulnbump.
La metodología completa, el análisis de fallos y las limitaciones se detallan en el artículo de investigación. Si estás desarrollando tu propio agente de remediación, ponlo a prueba con VulnBump y cuéntanos qué descubres.
VulnBump fue creado por Gabija Pasiunaite, Ryan McMorrow, Brian Clark, Liran Tal y Luke Tu.
INVESTIGACIÓN