Revisión de código seguro: 8 prácticas recomendadas de seguridad

20 de abril de 2020
0 minutos de lectura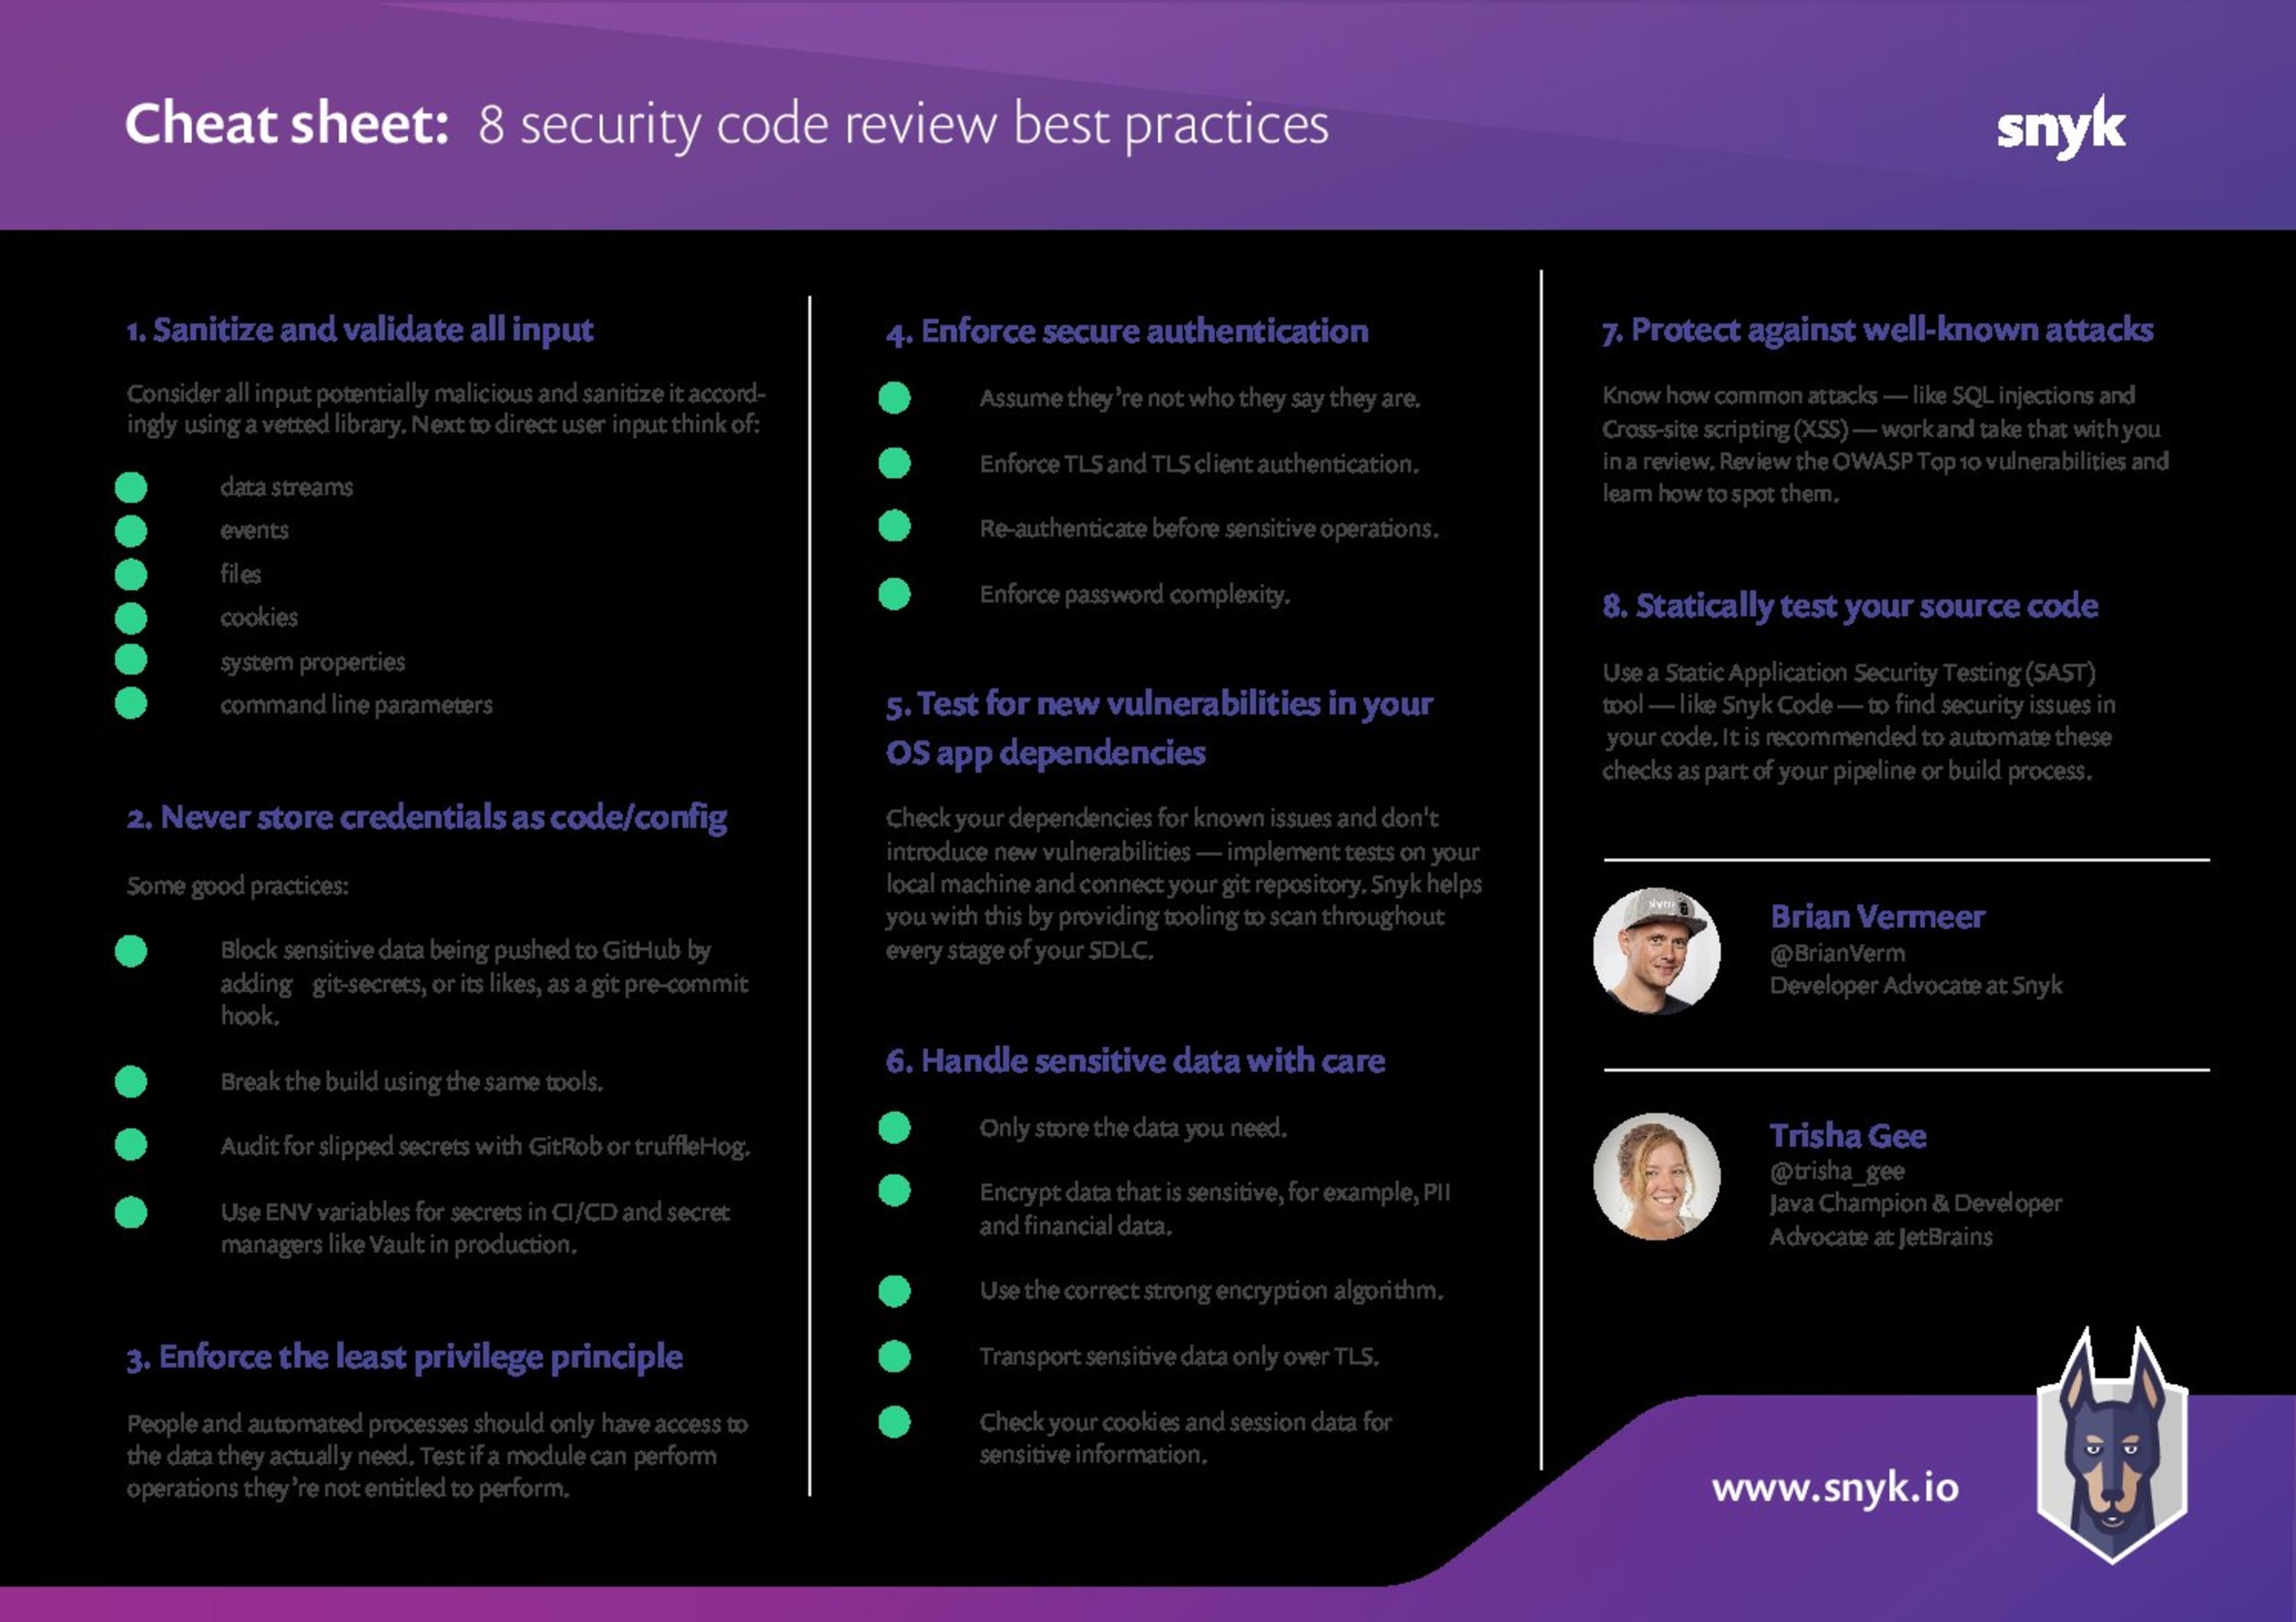
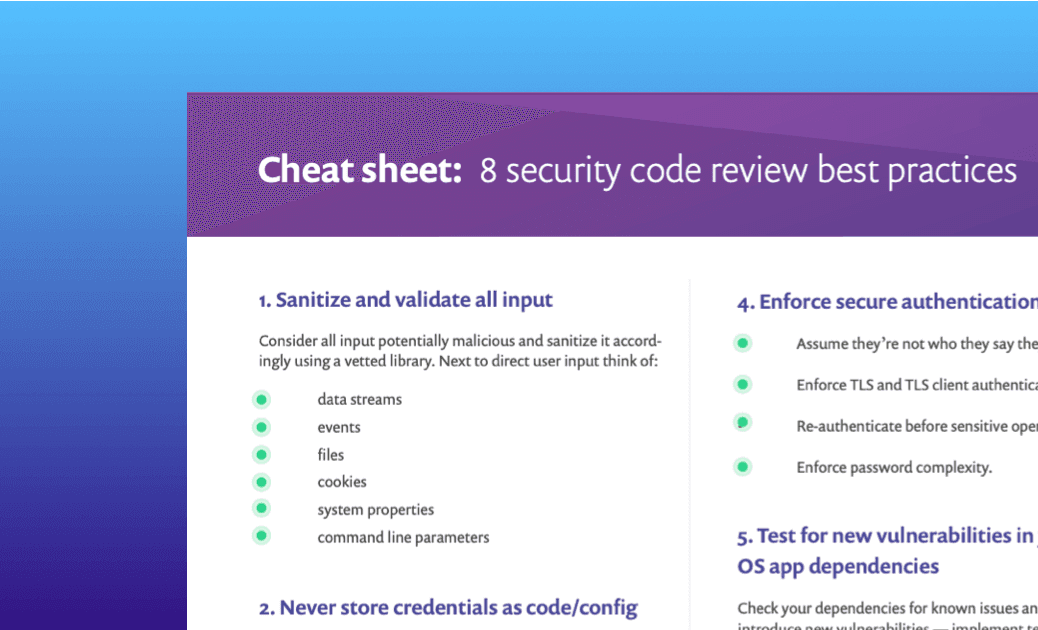
«Siempre es buena idea buscar problemas de seguridad en el código que revisas. Si no sabes qué buscar, aquí tienes una lista práctica que te dará algunas pautas para tus próximas revisiones de código». Hacer bien las revisiones de código es difícil, sobre todo cuando no tienes del todo claro qué errores debes buscar. El enfoque DevSecOps desplaza las pruebas de seguridad hacia las primeras etapas del proceso, para que las vulnerabilidades se puedan detectar y corregir antes, durante el diseño, el desarrollo o las etapas de CI/CD del flujo de trabajo. Siempre es buena idea buscar problemas de seguridad en el código que revisas. Si no sabes qué buscar, aquí tienes una lista práctica que te dará algunas pautas para tus próximas revisiones de código.
Al revisar código, ten presente que no todo el código es igual. Piensa también en lo que hay detrás del código que revisas y, por lo tanto, en los datos y activos que intentas proteger. Este conocimiento práctico no es fácil de incluir en una lista de verificación. Sin embargo, usar los consejos de esta guía junto con tus conocimientos del dominio te ayudará a decidir dónde dedicar más tiempo y dónde esperar un mayor riesgo y distintos tipos de ataques. Una excelente manera de determinar cuáles son tus áreas de mayor riesgo es crear árboles de ataque, que te mostrarán dónde concentrar tus esfuerzos primero o más.
Empecemos con nuestra lista de 8 consejos de seguridad para revisar código, que puedes tener en cuenta al revisar futuros pull request.
1. Sanitiza y valida todas las entradas
Las aplicaciones web modernas deben interactuar con todo tipo de entradas de terceros. Una de las más evidentes es la entrada directa de un usuario final en el navegador. Como desarrolladores, sabemos que los usuarios ingresarán cosas inesperadas cuando sea posible. Asegurarse de que las entradas directas de los usuarios se validen y saniticen correctamente es una práctica recomendada fundamental para evitar que las aplicaciones sean vulnerables a la inyección de contenido. Sin embargo, la entrada directa de los usuarios no es lo único que debes revisar. Básicamente, toda entrada que provenga de los límites externos de tu sistema debe considerarse y tratarse como potencialmente dañina. Piensa en elementos como:
fuentes de datos
archivos
eventos — un sistema basado en eventos, como los que funcionan en estrecha colaboración con plataformas de Functions as a Service
respuestas de datos de otros sistemas
cookies
Además, una entrada que a primera vista parece estar bajo tu control podría ser dañina. Piénsalo: si un usuario malicioso puede conectarse directamente a tu base de datos, existe una puerta trasera para insertar, por ejemplo, código malicioso que se ejecutará en tu sistema. El mismo principio se aplica a:
parámetros de línea de comandos
variables de entorno
propiedades del sistema
almacenamiento de datos
Todas las entradas, incluso las que parecen estar bajo tu control, deben validarse y sanitizarse. Comprueba que tengan sentido. Usar el sistema de tipos de un lenguaje con seguridad de tipos puede ser de gran ayuda. Además, revisa el formato, el rango, el tamaño, el tipo y el nombre del archivo, y no des nada por sentado. Las entradas de los usuarios deben sanitizarse, de preferencia con una biblioteca de eficacia comprobada, antes de almacenarlas o usarlas.
2. Nunca guardes secretos en el código o la configuración
Es muy fácil guardar credenciales, tokens u otros secretos como variables o constantes, porque, bueno, solo estamos probando que funcione. Pero ese código puede llegar con la misma facilidad a tu repositorio porque olvidaste quitarlo. Te recomendamos asegurarte de que no haya nada confidencial en el código que revisas. Si usas un repositorio de código basado en Git, hay varias herramientas excelentes, como git-secrets, que pueden analizar estáticamente tus commits mediante un hook de pre-commit de Git para asegurarse de que no intentes enviar contraseñas ni información confidencial a tu repositorio. Los commits se rechazan si la herramienta detecta coincidencias con alguno de los patrones de expresiones regulares configurados que indican que se almacenó información confidencial de forma incorrecta. Esto puede ralentizar un poco los envíos, pero vale mucho la pena.
Establecer reglas para todo el equipo que impidan guardar credenciales en el código es una excelente manera de detectar malas prácticas en el flujo de trabajo actual de desarrollo. Usa herramientas como Vault para administrar tus secretos en producción. Por último, considera usar una cadena de herramientas de administración de identidades y usuarios, como Keycloak (que actualmente mantienen varios desarrolladores de Red Hat), entre otras.
Hay muchas maneras de evitar incluir credenciales en tu repositorio desde el principio, y lo mejor es implementar todas las que puedas. Sin embargo, siempre existe la posibilidad de que se cuele información confidencial. También deberías auditar tus repositorios con regularidad y usar herramientas como GitRob o truffleHog, que analizan tu base de código para buscar información confidencial mediante la coincidencia de patrones.
3. Busca nuevas vulnerabilidades de seguridad introducidas por dependencias de código abierto de terceros
El desarrollo de aplicaciones modernas depende en gran medida de bibliotecas de terceros. Gracias a los administradores de paquetes como npm, Maven, Gradle, PyPI o equivalentes, tenemos acceso fácil a bibliotecas y marcos de trabajo disponibles públicamente. Como desarrolladores, queremos enfocarnos en la lógica de negocio específica, no tanto en crear funciones repetitivas. Por eso, usar marcos de trabajo y bibliotecas para que hagan el trabajo pesado es una opción evidente.
Es posible que no sepas cuántas dependencias directas usa tu aplicación. En un proyecto promedio, tu código puede representar apenas el 1 %; el resto son bibliotecas y marcos de trabajo importados. Gran parte del código que llega a producción no es nuestro, pero dependemos mucho de él. También es muy probable que no sepas cuántas dependencias transitivas usa tu aplicación. Hoy en día, los marcos de trabajo más grandes dependen de otras bibliotecas que, a su vez, dependen de otras más. Al agregar una sola biblioteca o marco de trabajo, es probable que agregues al menos una docena más, de las que quizá no siempre estés al tanto. Así, las dependencias conforman la mayor parte de tu aplicación. Los atacantes apuntan cada vez más a las dependencias de código abierto, ya que reutilizarlas les permite tener muchas víctimas. Por eso, es importante asegurarse de que no haya vulnerabilidades conocidas en todo el árbol de dependencias de tu aplicación.
Tomemos Snyk como ejemplo. Snyk analiza estáticamente tu proyecto para encontrar dependencias vulnerables que quizá uses y te ayuda a corregirlas. Puedes probar tus repositorios desde la interfaz de Snyk para encontrar problemas y también evitar que los usuarios agreguen nuevas bibliotecas vulnerables: prueba los pull request y falla la prueba si se introduce una nueva vulnerabilidad. También puedes optar por PR automatizados con correcciones.
Según tu forma de trabajar, puedes conectar tu repositorio a la interfaz de Snyk o analizar el proyecto en tu máquina local con la CLI (consulta la guía rápida de la CLI), una integración en tu sistema de compilación o un complemento en tu IDE. Desde el extremo izquierdo (la máquina local de los desarrolladores) hasta el extremo derecho (tu sistema en producción), y en cada paso intermedio, debes analizar tus dependencias automáticamente para obtener comentarios rápidos.
4. Aplica una autenticación segura
La autenticación verifica que un usuario, servicio o entidad (interna o externa) sea quien dice ser. Puede ser algo tan sencillo como que un usuario te proporcione sus credenciales o que un servidor te presente su certificado TLS para validar que realmente es el servidor que afirma ser. La autenticación no te dice qué puede hacer el usuario o servicio; solo confirma que realmente es ese usuario o servicio. Veamos algunas prácticas recomendadas de autenticación que debes tener en cuenta:
Asume que no son quienes dicen ser.
Debes partir del principio de que no son quienes dicen ser hasta que presenten las credenciales que lo demuestren. Suponer que el usuario o servicio no debería tener acceso a tus datos es, por supuesto, la opción más segura. Asegúrate de que tu código lo refleje.
Exige contraseñas complejas
En el caso de los usuarios, considera ser más flexible con los nombres de usuario, sobre todo si usan direcciones de correo electrónico. Por ejemplo, no tiene mucho sentido distinguir entre Patch@snyk.io y patch@snyk.io, mientras que sí es importante exigir contraseñas complejas (al menos 1 carácter en mayúscula, 1 carácter en minúscula (a-z), 1 dígito (0-9) y 1 carácter especial) y que tengan una longitud suficiente (NIST SP800-132). Entiendo que es difícil recordar todas esas contraseñas largas y complejas, sean aleatorias o no. Pero, ¡vamos! Estamos en 2020 y los administradores de contraseñas están aquí para ayudarte.
Vuelve a autenticar antes de realizar operaciones confidenciales
Solicitar las credenciales de los usuarios antes de transferir dinero o realizar acciones confidenciales mitiga posibles ataques de falsificación de solicitudes entre sitios (CSRF) y secuestro de sesiones. Un atacante podría llevar a cabo estas tareas confidenciales sin haber proporcionado nunca las credenciales del usuario. Aunque esta medida de seguridad pueda ser incómoda para tus usuarios, puede protegerlos a largo plazo.
Autenticación de cliente TLS
La autenticación de cliente TLS, también conocida como autenticación TLS bidireccional, requiere que tanto el navegador como el servidor se autentiquen y envíen sus certificados TLS durante un enlace TLS. Esto se logra cuando un usuario o servicio obtiene un certificado de cliente del servidor y lo presenta en interacciones posteriores. Si usa un navegador, es posible que el usuario tenga que instalar el certificado.
5. Aplica el principio de privilegio mínimo
Además de la autenticación, está la autorización. Aunque suenan parecido, son conceptos muy distintos. Como vimos en el punto 4, la autenticación demuestra que un usuario o servicio es quien dice ser, mientras que la autorización va más allá y verifica que esa persona o servicio tenga permiso para realizar la tarea o acción que intenta llevar a cabo. Sabemos que debemos comprobarlo y asegurarnos de que esos usuarios, servicios o procesos se ejecuten o existan con un rol que les dé autoridad para realizar la acción. Sin embargo, desde el punto de vista de la programación, es muy fácil conceder más acceso del necesario.
El principio de privilegio mínimo establece que cada módulo (como un proceso, un usuario o un programa, según el caso) debe poder acceder únicamente a la información y los recursos necesarios para cumplir su propósito legítimo. En esencia, concede a las personas o los procesos solo los privilegios y permisos mínimos que necesitan para alcanzar su objetivo.
Una excelente manera de comprobarlo es escribir pruebas unitarias y de integración automatizadas y específicas que no solo prueben el flujo esperado, sino también, y más importante, los casos de seguridad en los que algo sale mal. Estas pruebas deben autenticarse correctamente, pero intentar realizar operaciones para las que no tienen autorización. Debes agregar siempre estas pruebas cuando cambies los roles con los que se ejecuta tu aplicación o incorpores recursos nuevos que requieran un rol específico para acceder a ellos.
6. Maneja los datos confidenciales con cuidado
Exponer datos confidenciales, como información personal o números de tarjetas de crédito de tus clientes, puede ser perjudicial. Pero incluso un caso más sutil puede tener las mismas consecuencias. Por ejemplo, exponer identificadores únicos de tu sistema es perjudicial si ese identificador se puede usar en otra llamada para obtener datos adicionales.
En primer lugar, debes revisar detenidamente el diseño de tu aplicación y determinar si realmente necesitas esos datos. Además, asegúrate de no exponer información confidencial, por ejemplo, mediante registros, autocompletado o transmisión de datos.
Almacenamiento de datos confidenciales
Si necesitas conservar datos confidenciales, como información de identificación personal (PII) o datos financieros, asegúrate de usar el cifrado adecuado. Probablemente quieras y necesites cumplir con el RGPD, pero, ante todo, no quieres que los datos de tus clientes queden expuestos. El cifrado debe usar un algoritmo sólido de cifrado bidireccional si necesitas recuperar los datos en su forma original, o un algoritmo sólido de hash criptográfico si necesitas almacenar contraseñas. No caigas en la trampa de crear tu propio cifrado: averigua qué tipo de cifrado necesitas y usa una biblioteca confiable y bien probada para implementarlo. Por ejemplo, usa BCrypt para aplicar hash a las contraseñas y los algoritmos Triple DES, RSA y AES para cifrar los datos que necesites recuperar. Lo más importante es revisar periódicamente si los algoritmos que usas siguen siendo seguros. Lo que hoy es perfectamente seguro podría quedar comprometido mañana.
También ten en cuenta que los datos confidenciales pueden permanecer en la memoria. Si cambias una contraseña en tu sistema, evita almacenarla temporalmente en un tipo de datos inmutable. Por ejemplo, si usas un String en Java para guardar la contraseña en la memoria, el valor original permanecerá allí hasta que el recolector de basura lo elimine, ya que String es inmutable. En este caso, sería mejor usar un arreglo de bytes.
Transmisión de datos confidenciales
Si necesitas transferir datos confidenciales, comprueba que la conexión sea segura. Los datos confidenciales solo deben transferirse cifrados y mediante TLS. También debes asegurarte de que la versión de TLS esté actualizada. Es evidente que enviar los datos de la tarjeta de crédito de alguien como parámetro de consulta o en texto sin formato en el cuerpo de una solicitud HTTP no es nada seguro.
Datos de sesión
Por último, pero no menos importante, considera también los datos de sesión como datos confidenciales. Se recomienda no almacenar datos confidenciales en cookies, sino usar un identificador de sesión y guardar los datos en una sesión administrada por el servidor. Además, asegúrate de que las cookies estén cifradas y tengan una longitud adecuada (por ejemplo, 128 bits). Comprueba que los atributos como HttpOnly, Secure, y SameSite estén configurados correctamente en la cookie y que esta venza en un plazo razonable. Ten en cuenta que, si un usuario cierra sesión desde el cliente, la sesión debe invalidarse para que no pueda usarse en otro lugar.
7. Protégete contra los ataques conocidos
Podemos dar por hecho que los atacantes seguirán vulnerando nuestras aplicaciones mediante vectores de ataque predecibles, conocidos y reconocidos. La falta general de conocimiento sobre las vulnerabilidades comunes y cómo se pueden explotar suele llevar a repetir los mismos errores de seguridad en el código una y otra vez. Revisa las vulnerabilidades del OWASP Top 10 y entiende cómo funcionan estos ataques comunes. Aquí tienes algunos consejos para evitar los tipos de vulnerabilidad más frecuentes.
XSS
La premisa central de un ataque de Cross-site Scripting (XSS) es que un usuario inyecta datos maliciosos en tu aplicación, que terminan en un contexto —como un documento HTML— donde pueden ejecutarse para divulgar información confidencial o realizar otras actividades maliciosas. Si quieres permitir que los usuarios envíen datos en tu sitio y que estos se muestren en una página, debes aprender a prevenir XSS de forma defensiva. Hay varias maneras de reducir la probabilidad de sufrir ataques XSS, como codificar en HTML los caracteres peligrosos. Entre ellos están &, <, >, “ y ‘. No permitir estos caracteres o depurarlos evitará que un atacante salga de la etiqueta HTML y ejecute código malicioso. Para dificultarlo aún más, podemos codificar en HTML todos los caracteres HTML que recibimos, de modo que no aparezcan en una forma que permita salir de una etiqueta HTML, como se muestra a continuación:
Entidad HTML | Codificación HTML |
|---|---|
& | & |
< | < |
> | > |
“ | " |
‘ | ' |
Del mismo modo, podemos hacerlo con atributos de etiquetas, controladores de eventos e incluso propiedades de estilo. Es común usar bibliotecas de depuración para definir una lista de permitidos con los caracteres que debemos aceptar. Usar bibliotecas de depuración existentes también significa que no tenemos que ser expertos en seguridad para contemplar todas las posibilidades. Esto es especialmente útil para desarrolladores con menos experiencia.
Inyección de SQL y NoSQL
Una de las razones por las que la inyección de SQL resulta tan atractiva para los atacantes es que les da acceso directo a los datos que quieren obtener. Con demasiada frecuencia, un ataque es simplemente una forma de descubrir o recopilar información sobre el sistema que se intenta vulnerar. Esto suele significar que el atacante debe investigar dónde están los datos y cómo acceder a ellos. La inyección de SQL, en cambio, es un mecanismo que, si se explota con éxito, puede dar al atacante acceso directo a información confidencial almacenada en una base de datos. Esto no se limita a las bases de datos SQL: muchas bases de datos NoSQL también pueden verse comprometidas de forma similar.
Tanto XSS como la inyección de SQL son ataques muy comunes. Debes saber cómo funcionan y cómo detectarlos en tu código. La falta de depuración de las entradas en cualquier parte del sistema es una gran señal de alerta de XSS. Para la inyección de SQL, comprueba si se parametrizan las consultas. Debes distinguir entre la consulta y los parámetros. Vincular los parámetros a un tipo específico antes de incluirlos en la consulta (y depurarlos correctamente) evitará este tipo de ataques.
Hay muchos otros tipos de vulnerabilidades a los que tu aplicación podría estar expuesta, algunos más que otros. Dedica tiempo a aprender cuáles afectan más a tu aplicación, desde el código que producen directamente tus equipos hasta los tipos de bibliotecas de los que depende tu aplicación.
8. Analiza automáticamente el código fuente de forma estática
El análisis estático de código es una herramienta muy potente para los desarrolladores. Las herramientas de pruebas de seguridad de aplicaciones estáticas (SAST) son un subconjunto de estas herramientas centrado en la seguridad. Al analizar de forma estática el código que tú y tu equipo escribieron, una herramienta SAST puede detectar si se filtró un error relacionado con la seguridad en el código fuente. Una herramienta SAST como Snyk Code puede señalar problemas como inyecciones de SQL y vulnerabilidades en el código.
Para la seguridad, recomendamos usar SAST en lugar de un linter. Aunque los linters pueden ser muy útiles para el análisis estático de código (errores, defectos, etc.), generan muchos falsos positivos. Como todos los linters se basan en reglas y no analizan todo el contexto del código, en muchos casos marcarán código como defectuoso o como un problema de seguridad cuando no lo es. Aun así, si ajustas el conjunto de reglas, un linter puede evitar errores graves. Lo mejor es automatizar estos procesos tanto como sea posible, por ejemplo, como parte del proceso de compilación o cuando se envía un nuevo pull request a tu repositorio. Snyk Code se encarga de todo eso y agrega capacidades SAST directamente a tus flujos de trabajo.
Si no tienes una herramienta SAST, puedes usarla durante la revisión manual del código o, mejor aún, automatizarla en tu proceso para que el equipo detecte los problemas evidentes cuanto antes. También puedes probar la herramienta gratuita de revisión de código de Snyk para obtener una idea rápida de la seguridad de tu código.
Empieza con Capture the Flag
Aprende a resolver desafíos de Capture the Flag viendo nuestro taller virtual introductorio a pedido.


