Funciones avanzadas del depurador de IntelliJ que te estás perdiendo


30 de enero de 2023
0 minutos de lecturaHace poco terminé de escribir mi libro sobre depuración y un curso de depuración. Como resultado, con frecuencia me preguntan cuáles son mis funciones de depuración favoritas. La depuración es mucho más que el depurador del IDE. De hecho, solo el primer capítulo del libro trata ese aspecto. Pero cuando pensamos en depuración, nuestra mente se dirige al IDE. Sin embargo, aún quedan muchos rincones por explorar en estas increíbles herramientas.
La razón principal es sencilla: nunca aprendimos a depurar. No se puede evaluar el conocimiento de depuración, así que las universidades no lo enseñan.
Lo aprendemos sobre la marcha en el trabajo, lo cual es terrible. No es de extrañar que algunos desarrolladores traten la depuración como sacar la basura: se tapan la nariz y corren hacia la puerta para deshacerse de ella. La depuración es mucho más que la suma de sus partes, y los depuradores son herramientas fantásticas que nos ayudan a comprender a fondo nuestro trabajo. Revelan el funcionamiento interno de la aplicación desde una perspectiva completamente nueva y nos dan un nivel de conocimiento que no ofrece ninguna otra disciplina.
En esta publicación, veremos tres funciones del depurador que, según mi experiencia, son las favoritas del público cuando doy charlas sobre este tema. Aunque todas deberían funcionar en la mayoría de los IDE de JetBrains, lamentablemente ninguna de las tres está disponible en VS Code. Creo que el equipo de VS Code tomó esta decisión de forma consciente para simplificar el entorno; espero que la reconsidere.
Tres funciones de depuración de IntelliJ:
Configuración de depuración con objetos marcadores
Renderizadores de entradas
Seguimiento de memoria
Configuración de depuración de IntelliJ con objetos marcadores
Uno de los mayores desafíos durante la depuración es llevar un registro de lo que hacemos. Nos detenemos en un punto de interrupción y vemos un objeto. ¿Es el mismo que vimos antes? ¿Tiene la misma referencia, los mismos valores, la misma identidad o la misma dirección de puntero?
Antes anotaba las direcciones de los punteros en un papel para recordar lo que había visto y comprobar que no fuera una dirección nueva. Es frustrante y confuso. Ni siquiera puedo leer mi letra… ¿Tiene que haber una forma mejor?
La hay. Cuando inspeccionamos un objeto en el depurador, en vez de anotar su valor, podemos marcarlo desde el menú contextual.
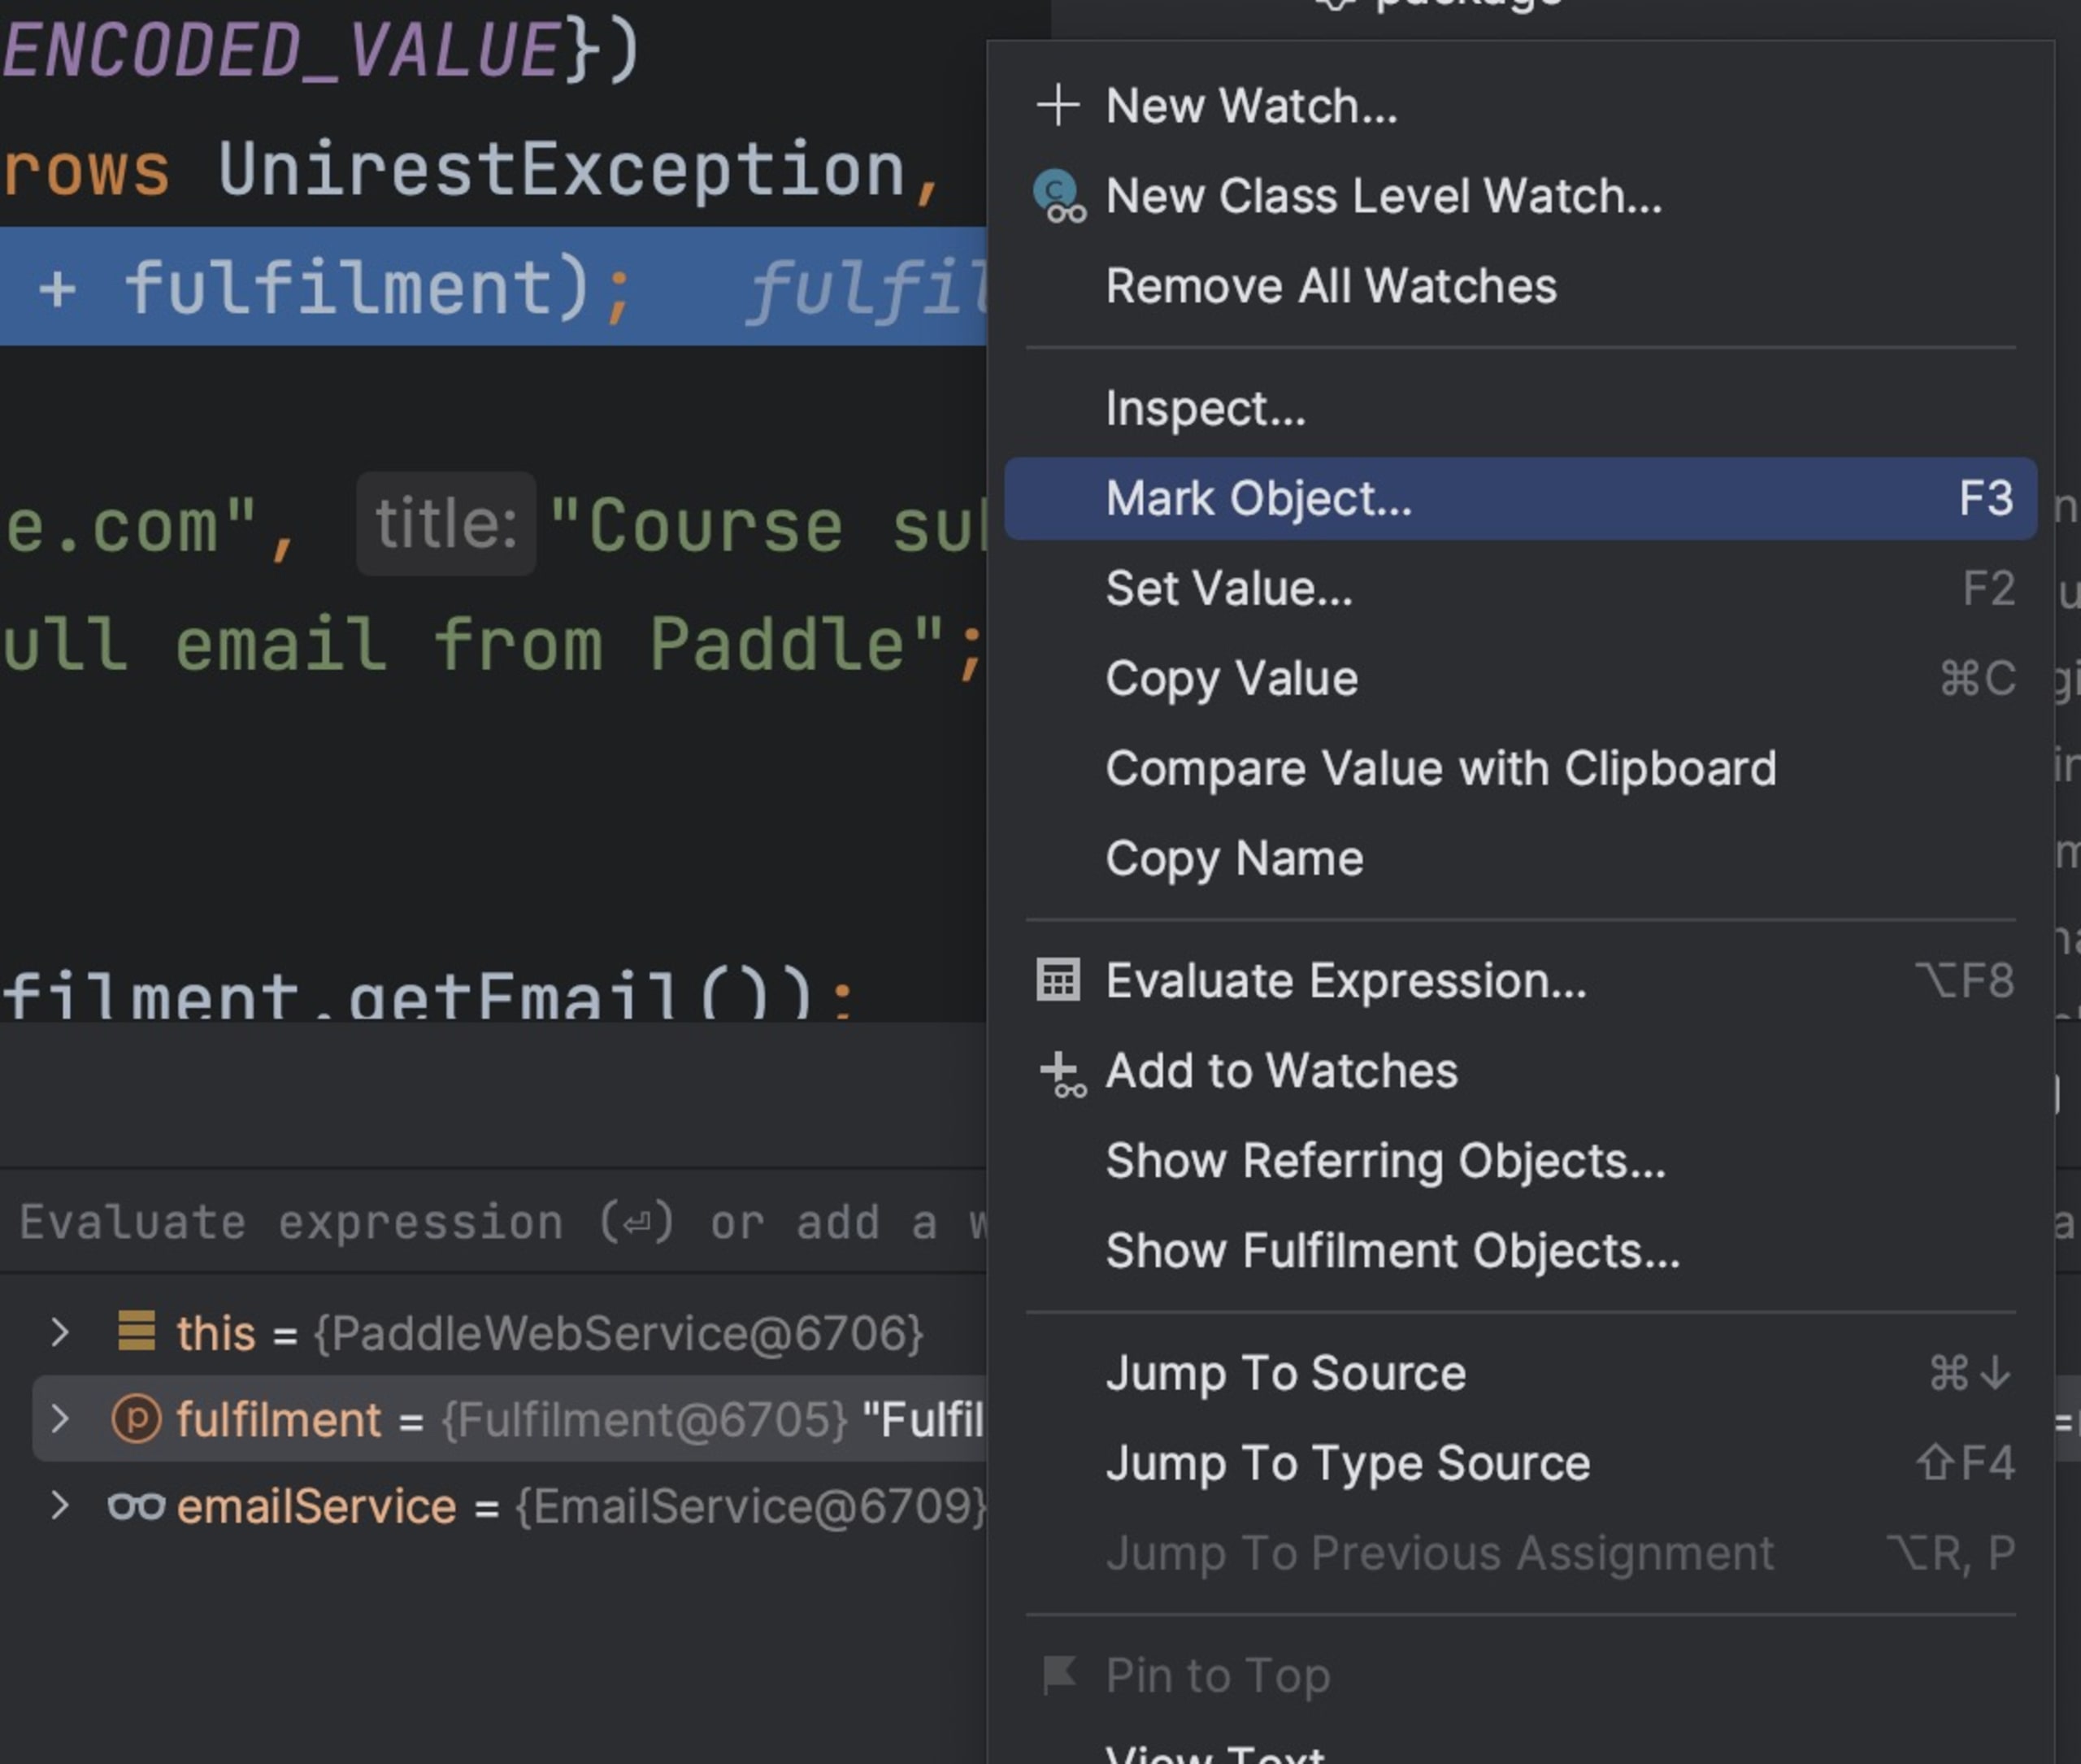
Al seleccionar esa opción, se nos pide que le pongamos un nombre al objeto. Es un cuadro de diálogo confuso. Podrías pensar, por error, que solo es un alias para la entrada de observación. No lo es.
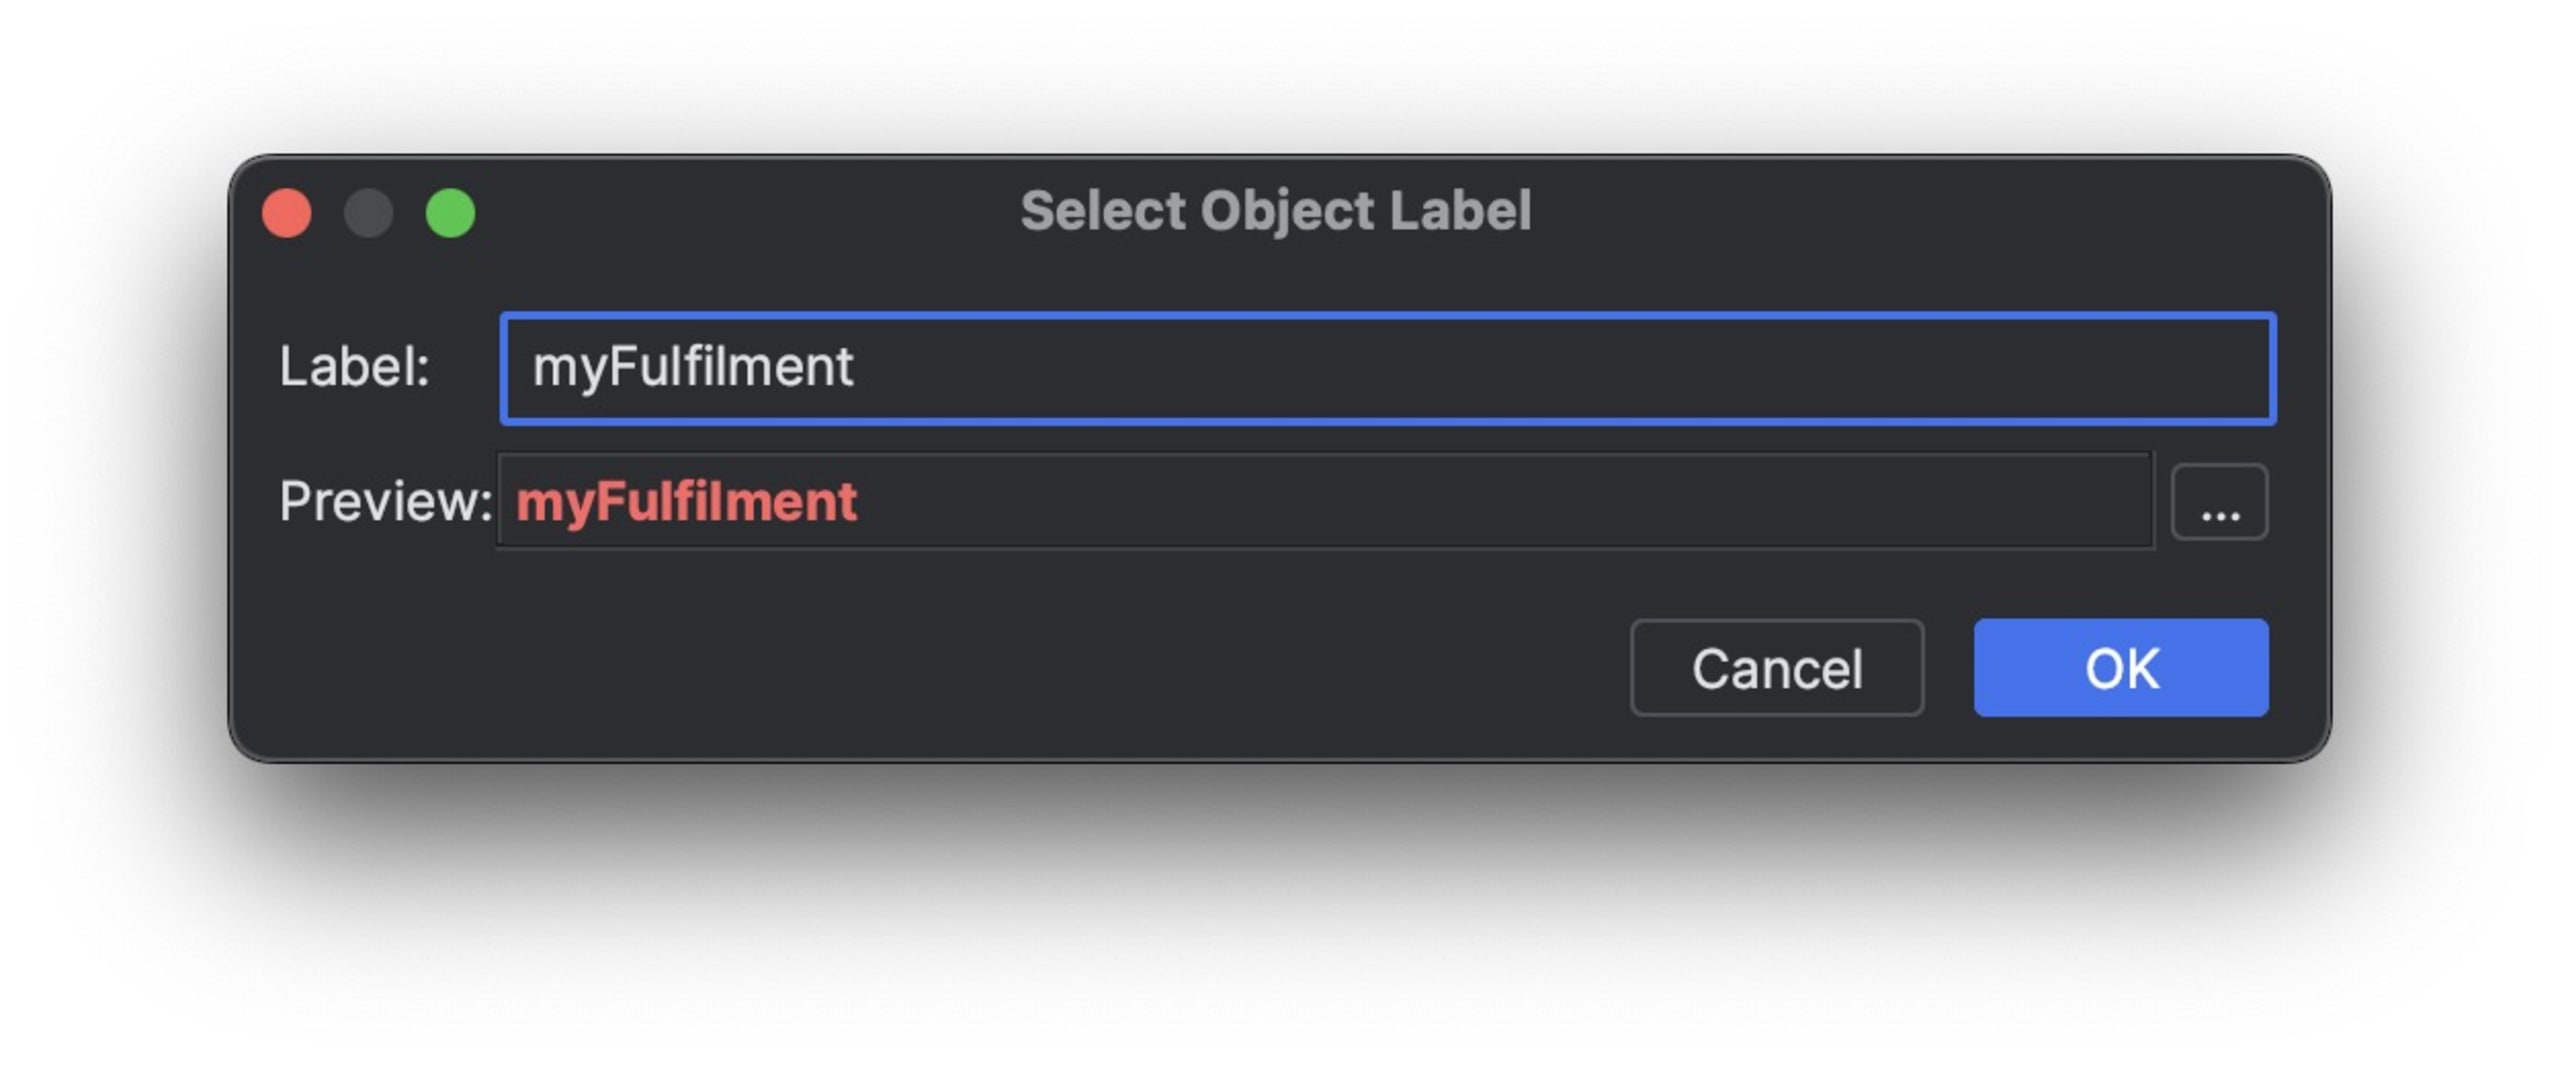
Lo que hacemos aquí es definir una nueva variable global. Podemos inspeccionar su valor en la sección de observación, sin importar el alcance (lo cual ya es bastante útil), pero también podemos usarla en instrucciones condicionales para que un punto de interrupción solo se active si el valor cambia, como vemos aquí.
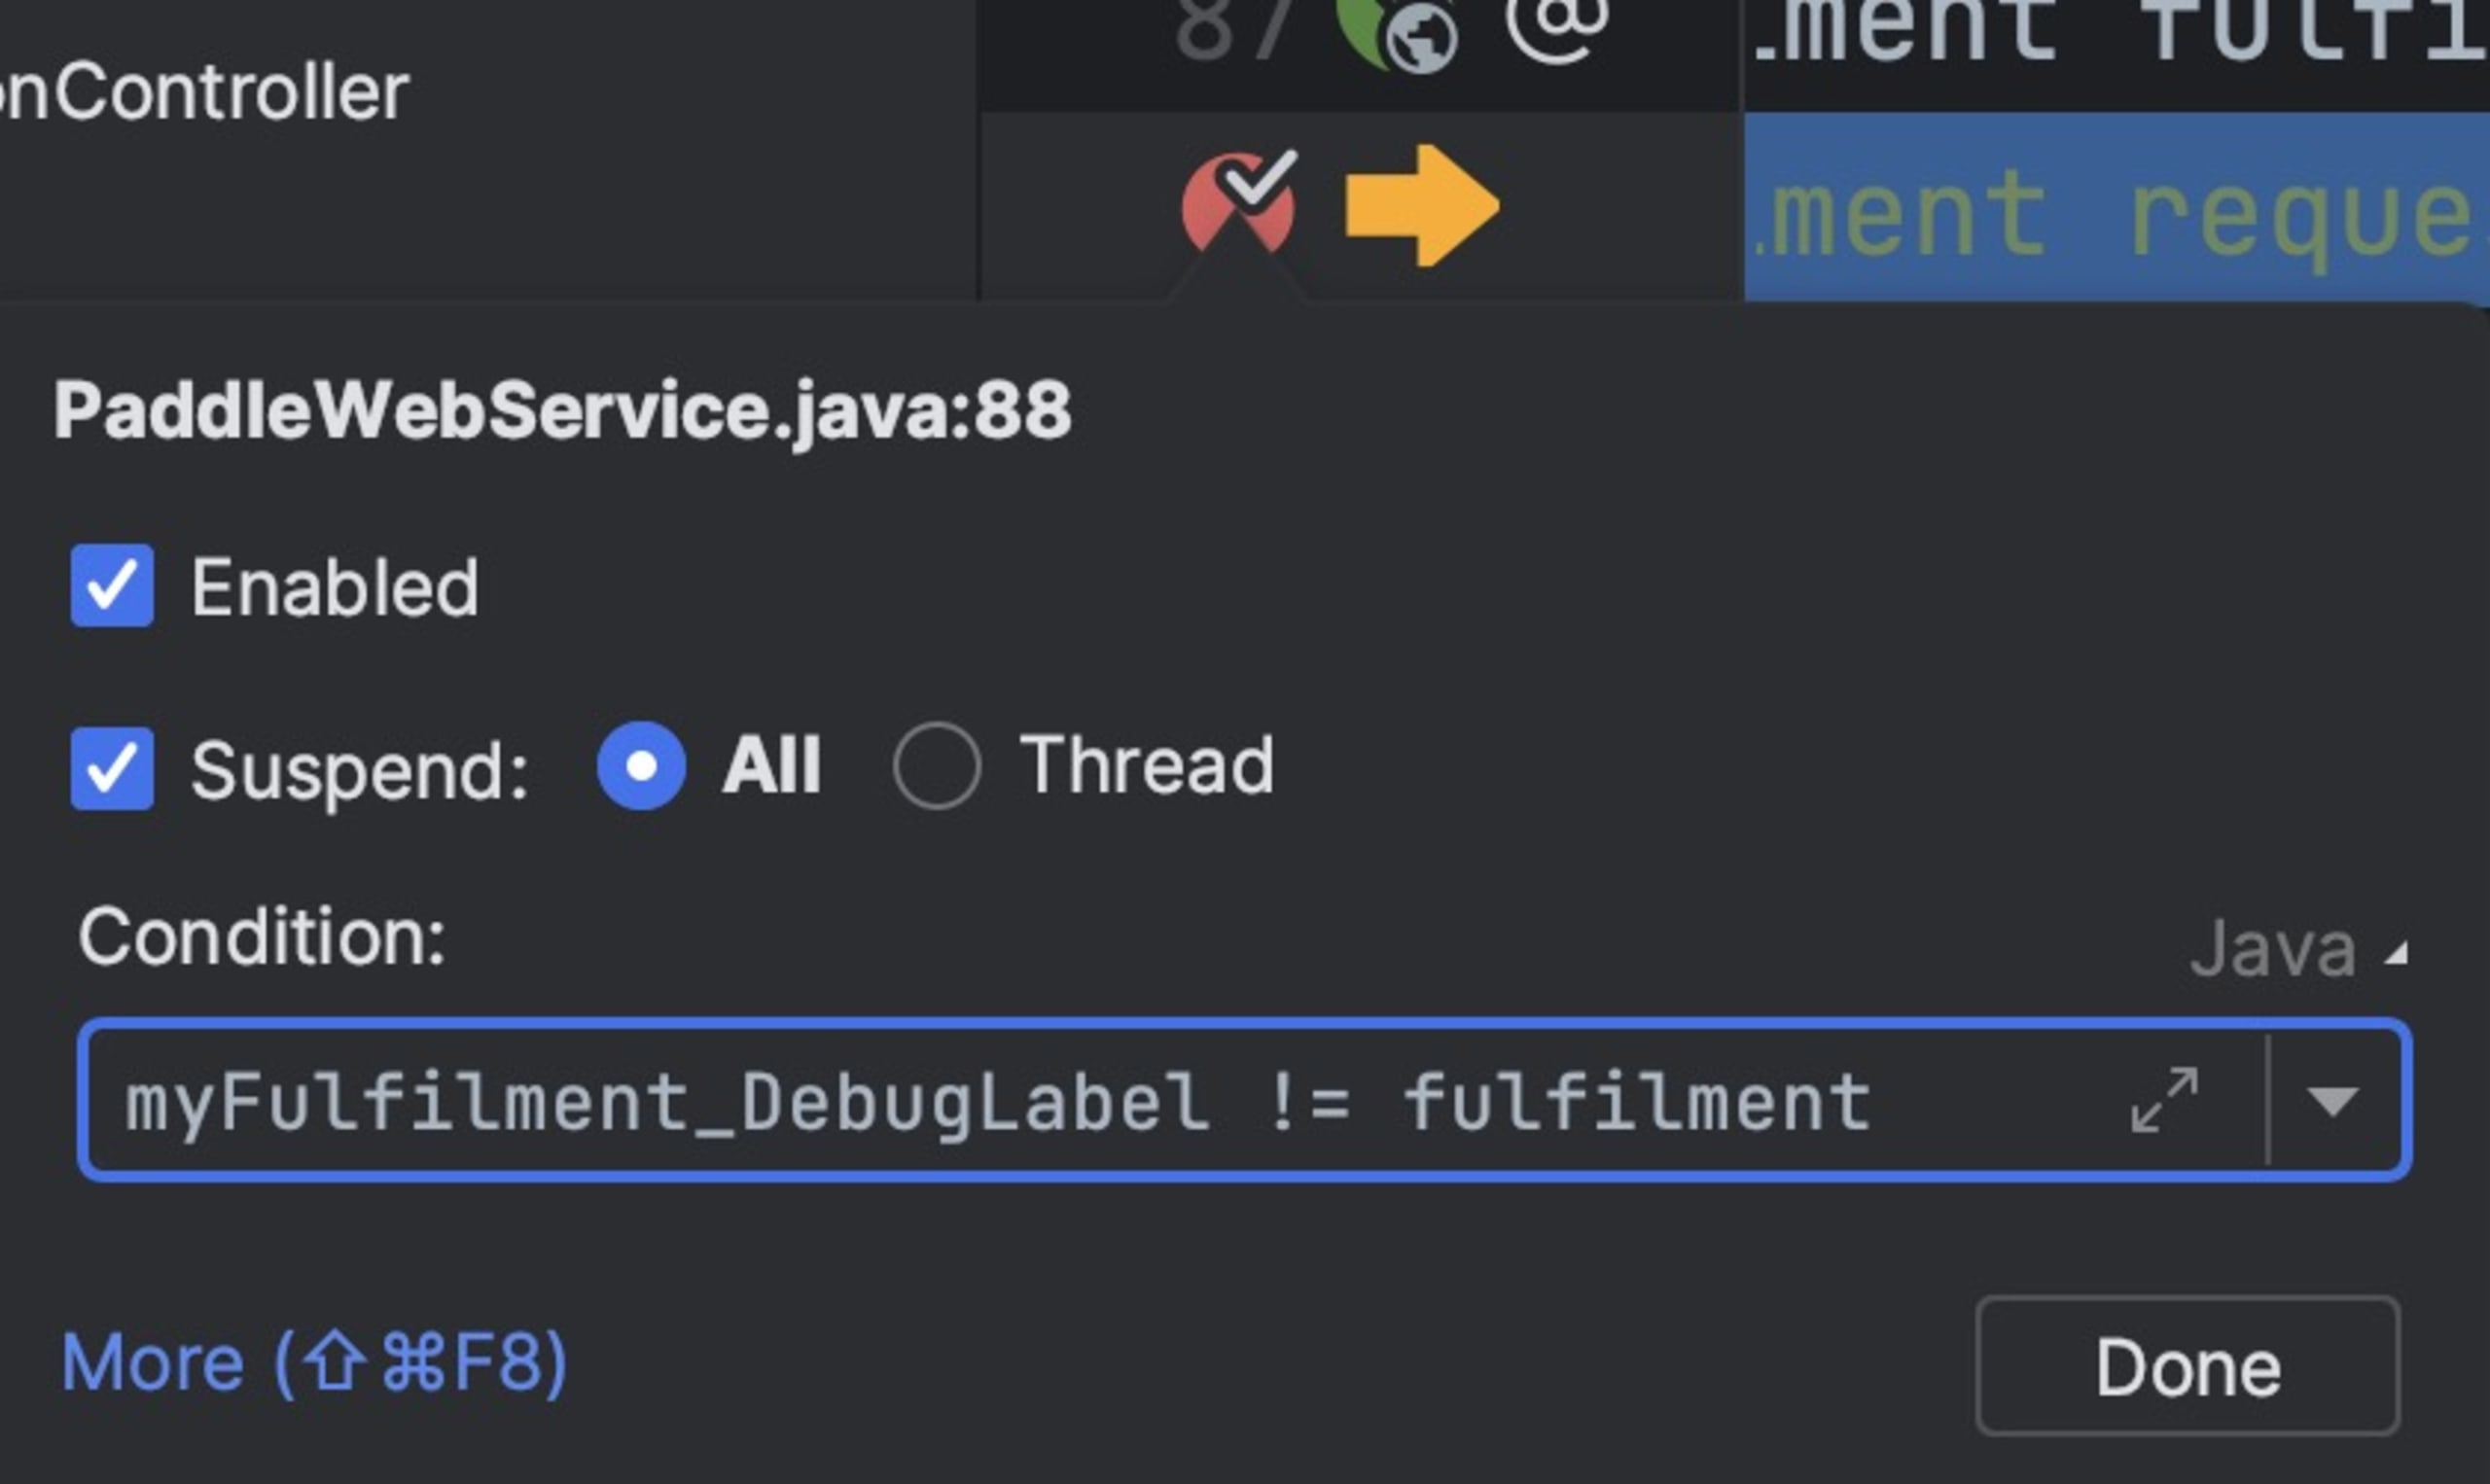
Es una función increíblemente potente. Podemos usarla para detectar problemas de concurrencia al marcar el hilo actual. También puedes usarla para llevar un registro de objetos que tienen la misma identidad, pero distintos punteros. Un buen ejemplo sería el mapeo objeto-relacional, donde podríamos tener dos instancias de la misma entidad al mismo tiempo. Esos errores son muy difíciles de rastrear.
Renderizadores de entradas
La sección de observación es una de las funciones más increíbles de los IDE modernos. A medida que avanzamos paso a paso por el código, nos muestra de un vistazo toda la información que necesitamos. Pero a veces ese “vistazo” se convierte más bien en una búsqueda a tientas: tenemos que expandir variables y explorar una jerarquía compleja solo para encontrar el valor de una variable que nos interesa.
En Java, una solución habitual es sobrescribir toString() para mostrar un valor más descriptivo. Pero hay varias razones por las que quizá no quiera hacerlo:
Puede que el objeto no sea mío; podría estar definido por el framework.
Quizá sea algo específico de mi caso. No quiero cambiar
toString()para todos.toString()es importante y puede afectar mucho el rendimiento de la aplicación (por el costo del registro, entre otras cosas).toString()es demasiado básico. ¿Y si quiero inspeccionar una variable que contiene una lista de elementos?
Los renderizadores nos permiten aprovechar la potencia de la sección de observación sin esos inconvenientes. Lo mostraré con una versión ligeramente modificada de la demostración Spring Pet Clinic. La demostración usa Java Persistence API (JPA) para el almacenamiento. La compatibilidad de Spring Data incluye el concepto de repositorio. Podemos pensar en un repositorio como una tabla de base de datos. No es una equivalencia “exacta”, ya que un repositorio es una abstracción más amplia, pero en general es una aproximación útil.
Al llegar a un punto de interrupción, normalmente vemos el desorden inútil de la siguiente imagen. visitRepository es un repositorio, pero no me ofrece información útil para depurar. ¿Cuántos elementos hay en la tabla? ¿Cuáles son sus valores?
Puedo expandir aún más la entrada de observación, pero no llegaré a ninguna parte: este objeto proxy no ofrece información útil para observar.
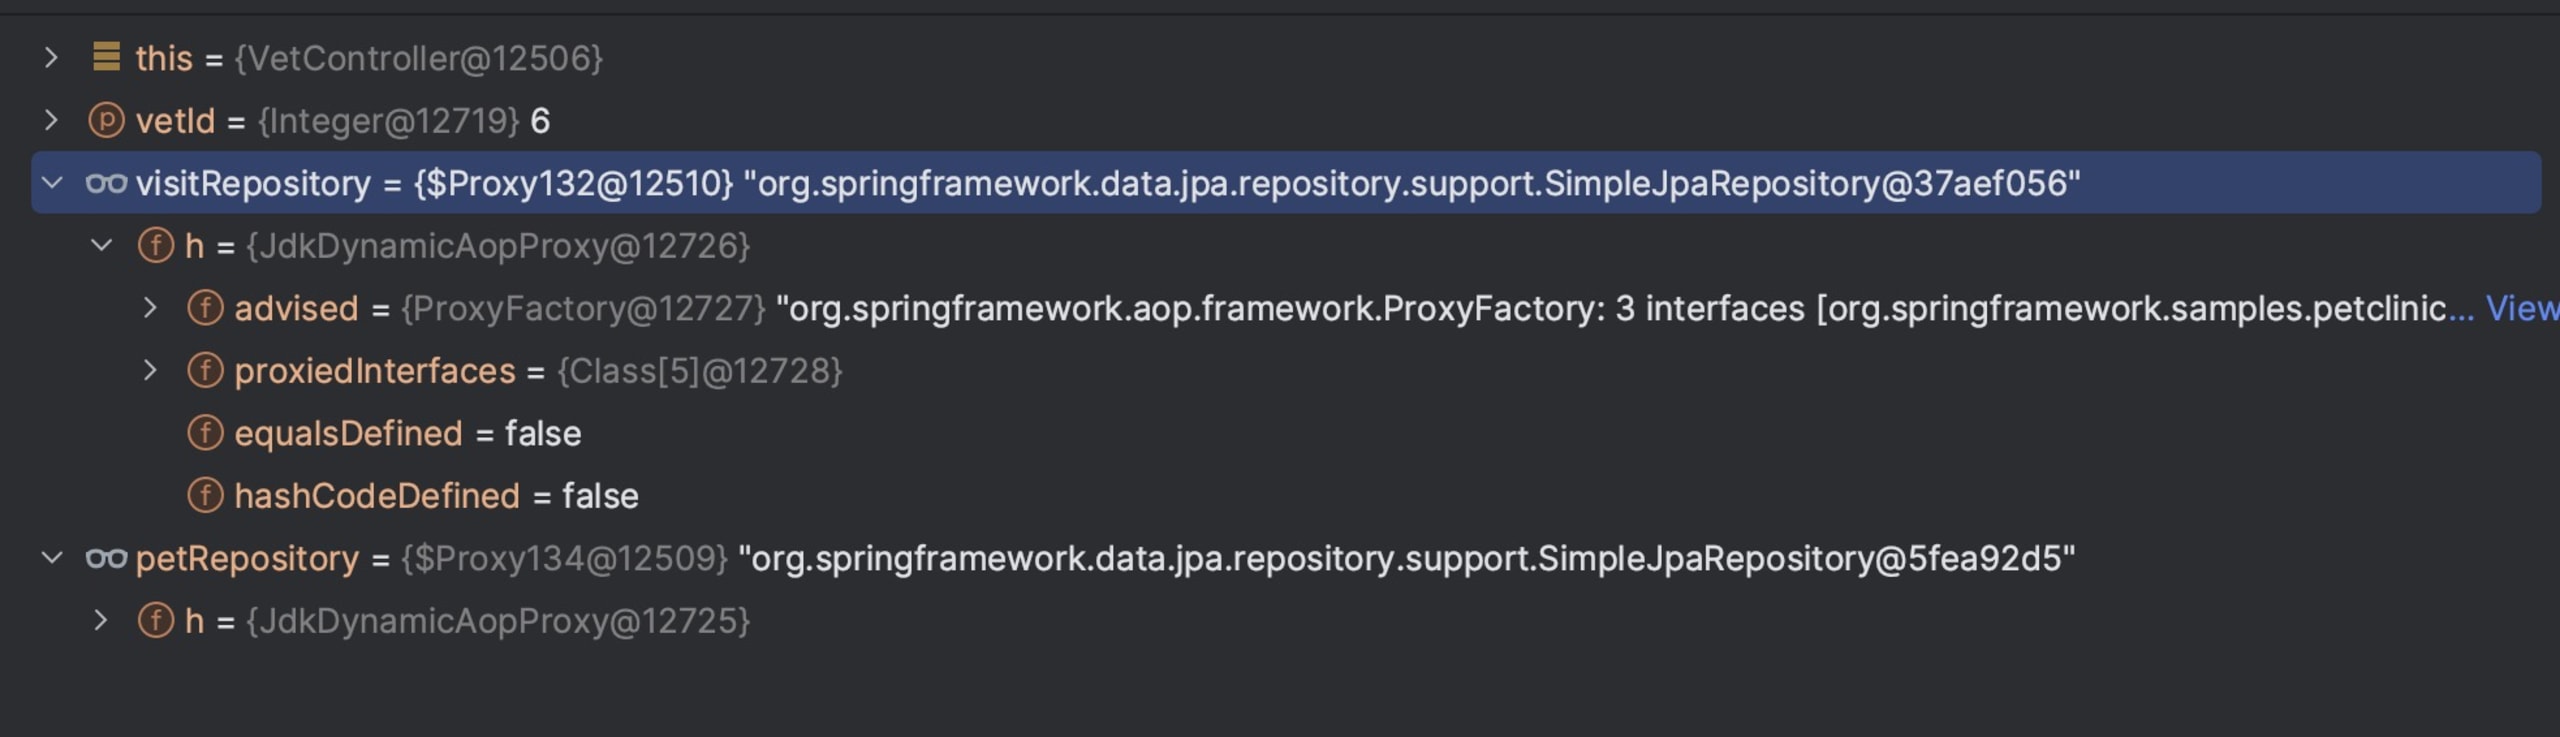
Podemos hacerlo mejor con renderizadores. Para empezar, haz clic derecho en la sección de observación y selecciona Personalizar vistas de datos.
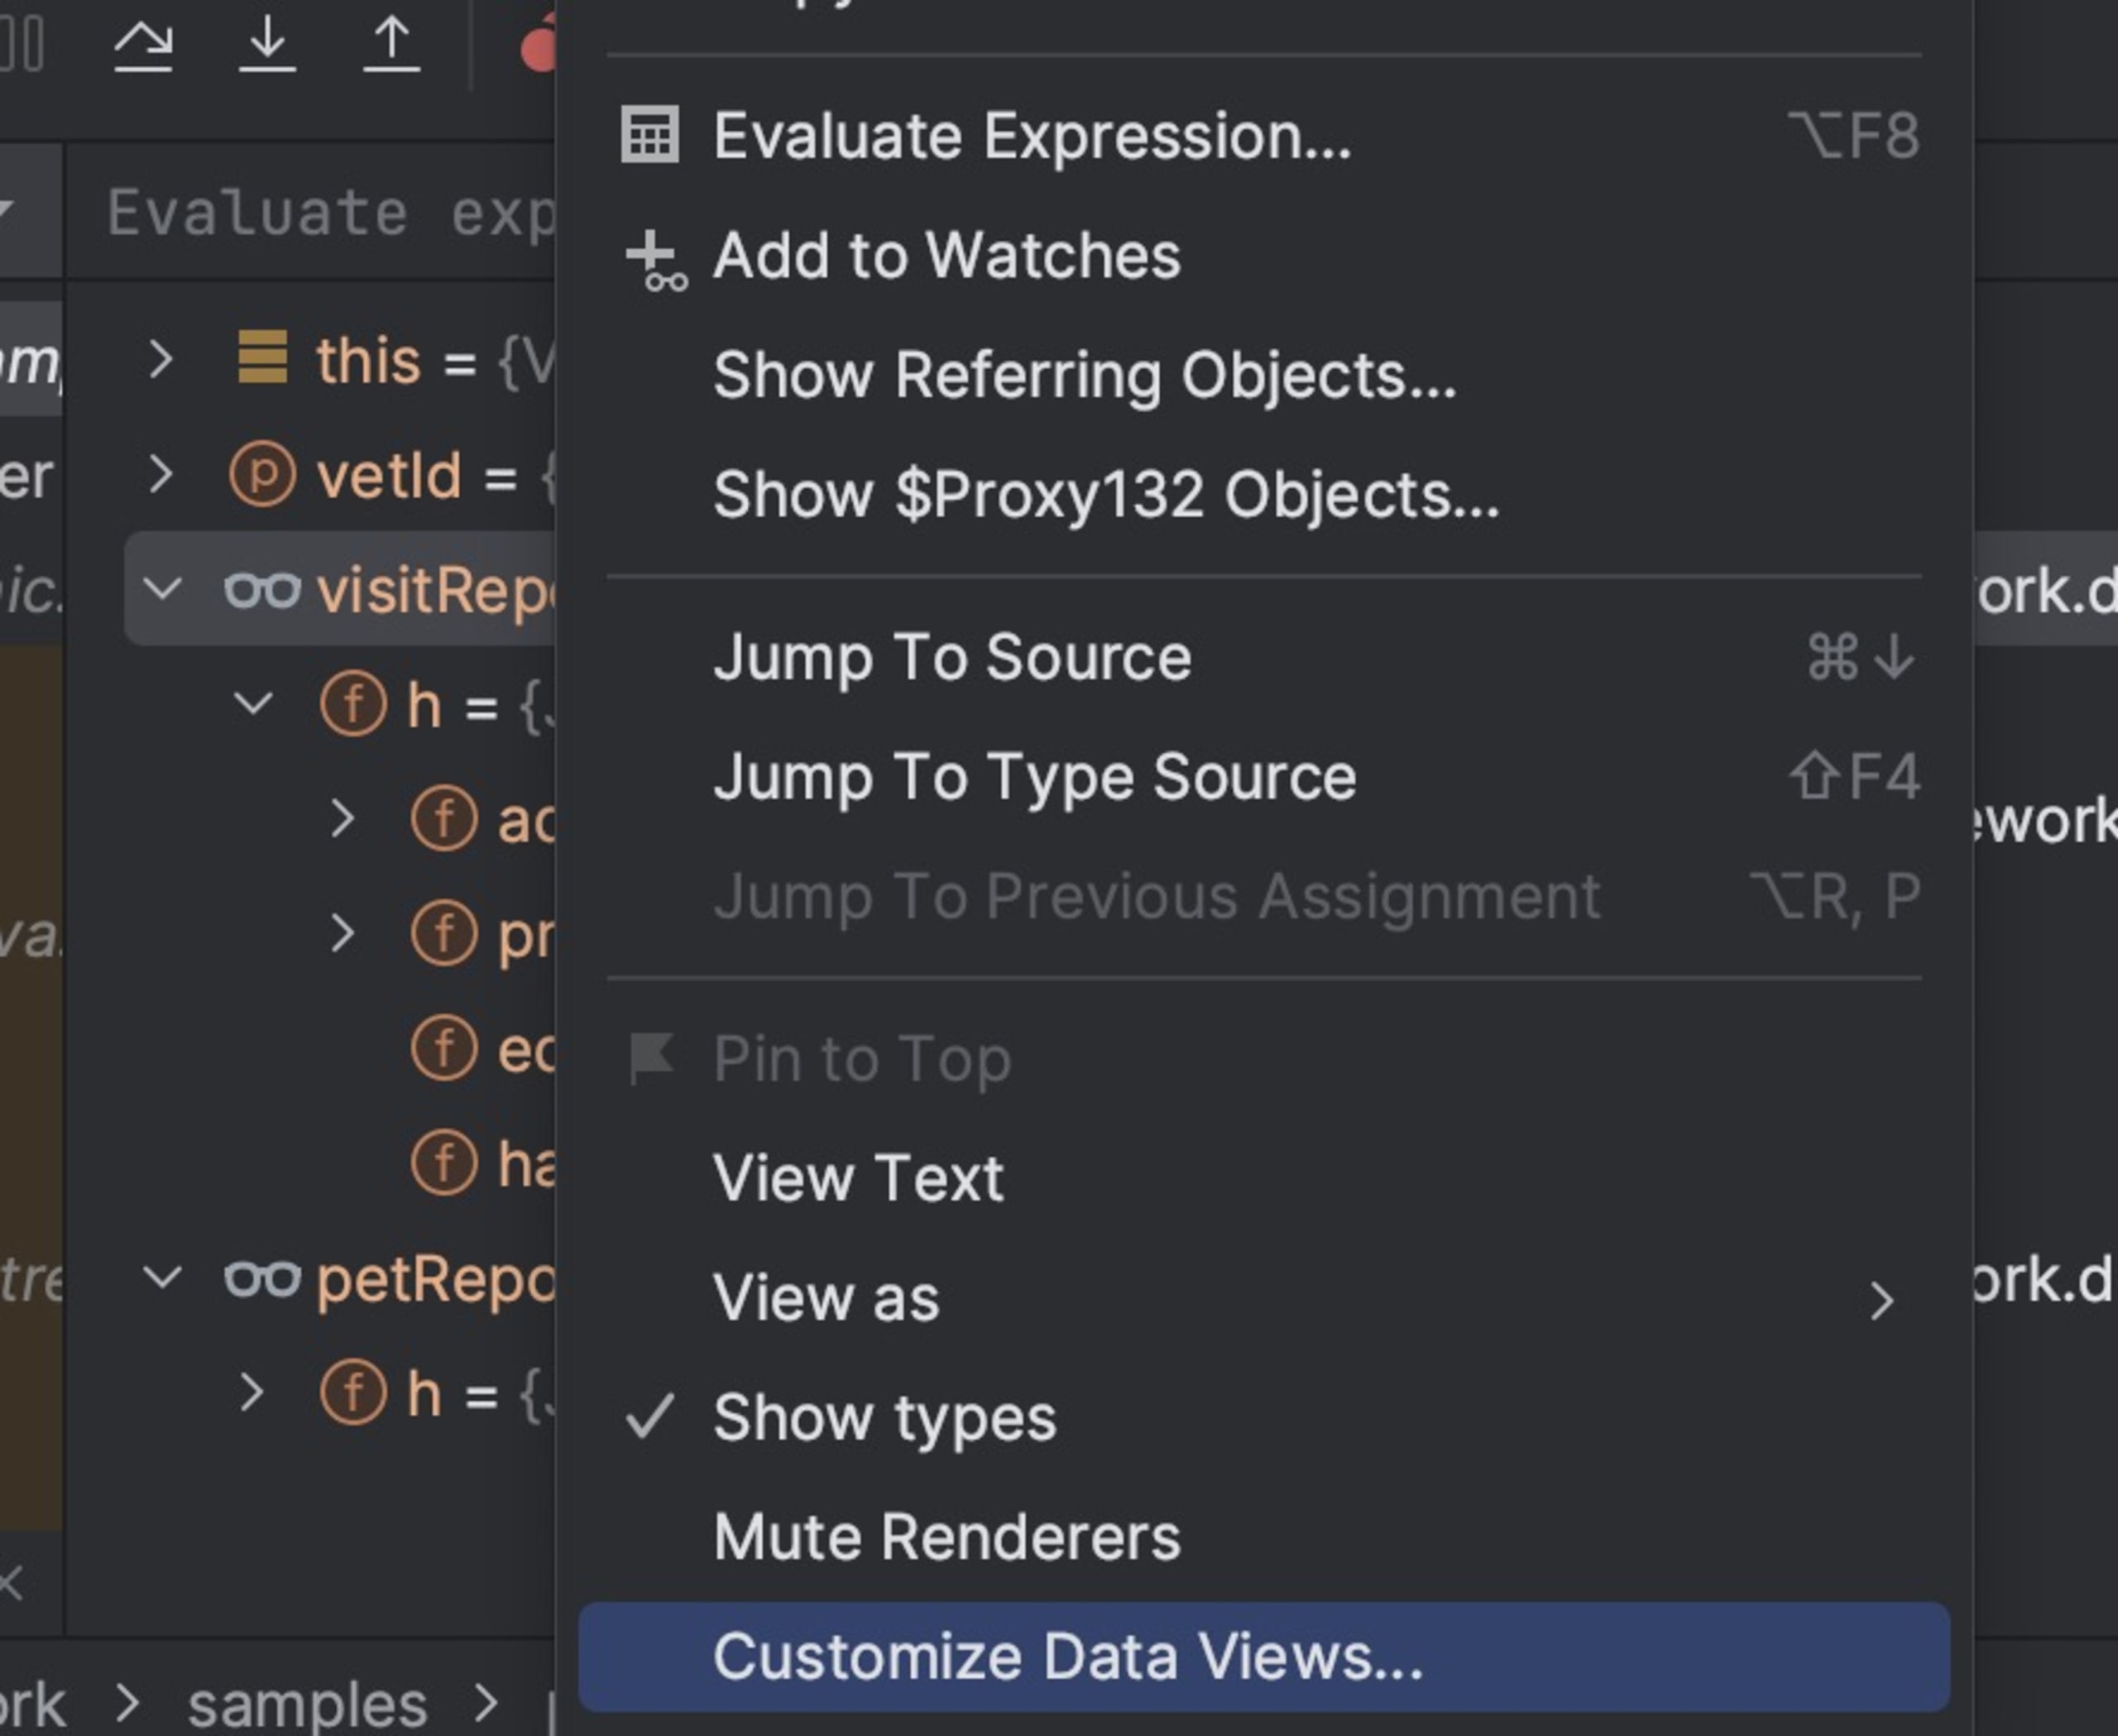
En el cuadro de diálogo que aparece, puedo definir los elementos del renderizador para obtener un resultado mucho más útil. Ahora, la sección de observación nos permite ver de un vistazo cuántos elementos hay y revisar cada uno por separado si queremos.

A la izquierda puedes ver cómo funciona. Elegimos personalizar JPARepository. Observa que perRepository en la sección de observación es otro tipo de repositorio; por eso no se vio afectado. A continuación, definiremos el código correspondiente que se ejecutará para implementar el renderizado. Llama al método count() en el objeto para obtener la cantidad de objetos y crear una cadena para mostrar en la sección de observación.
La segunda parte es aún más interesante. Podemos aprovechar findAll() para recopilar los elementos del repositorio y mostrarlos cuando se expanda el objeto. La última parte determina si debe aparecer un signo más junto al repositorio para permitir expandirlo.
Increíble. Pero tiene una gran desventaja: hay que hacerlo para cada tipo de objeto que definamos. Es tedioso… ¿o no?
Podemos definir anotaciones que representen estas configuraciones e incluir soluciones como esta directamente en la distribución de nuestra biblioteca. Esto puede facilitar mucho la depuración de bibliotecas de terceros.
Seguimiento de memoria
Cuando hablamos de memoria, pensamos en herramientas de perfilado. ¿Qué mejor forma hay de hacer un seguimiento de la memoria?
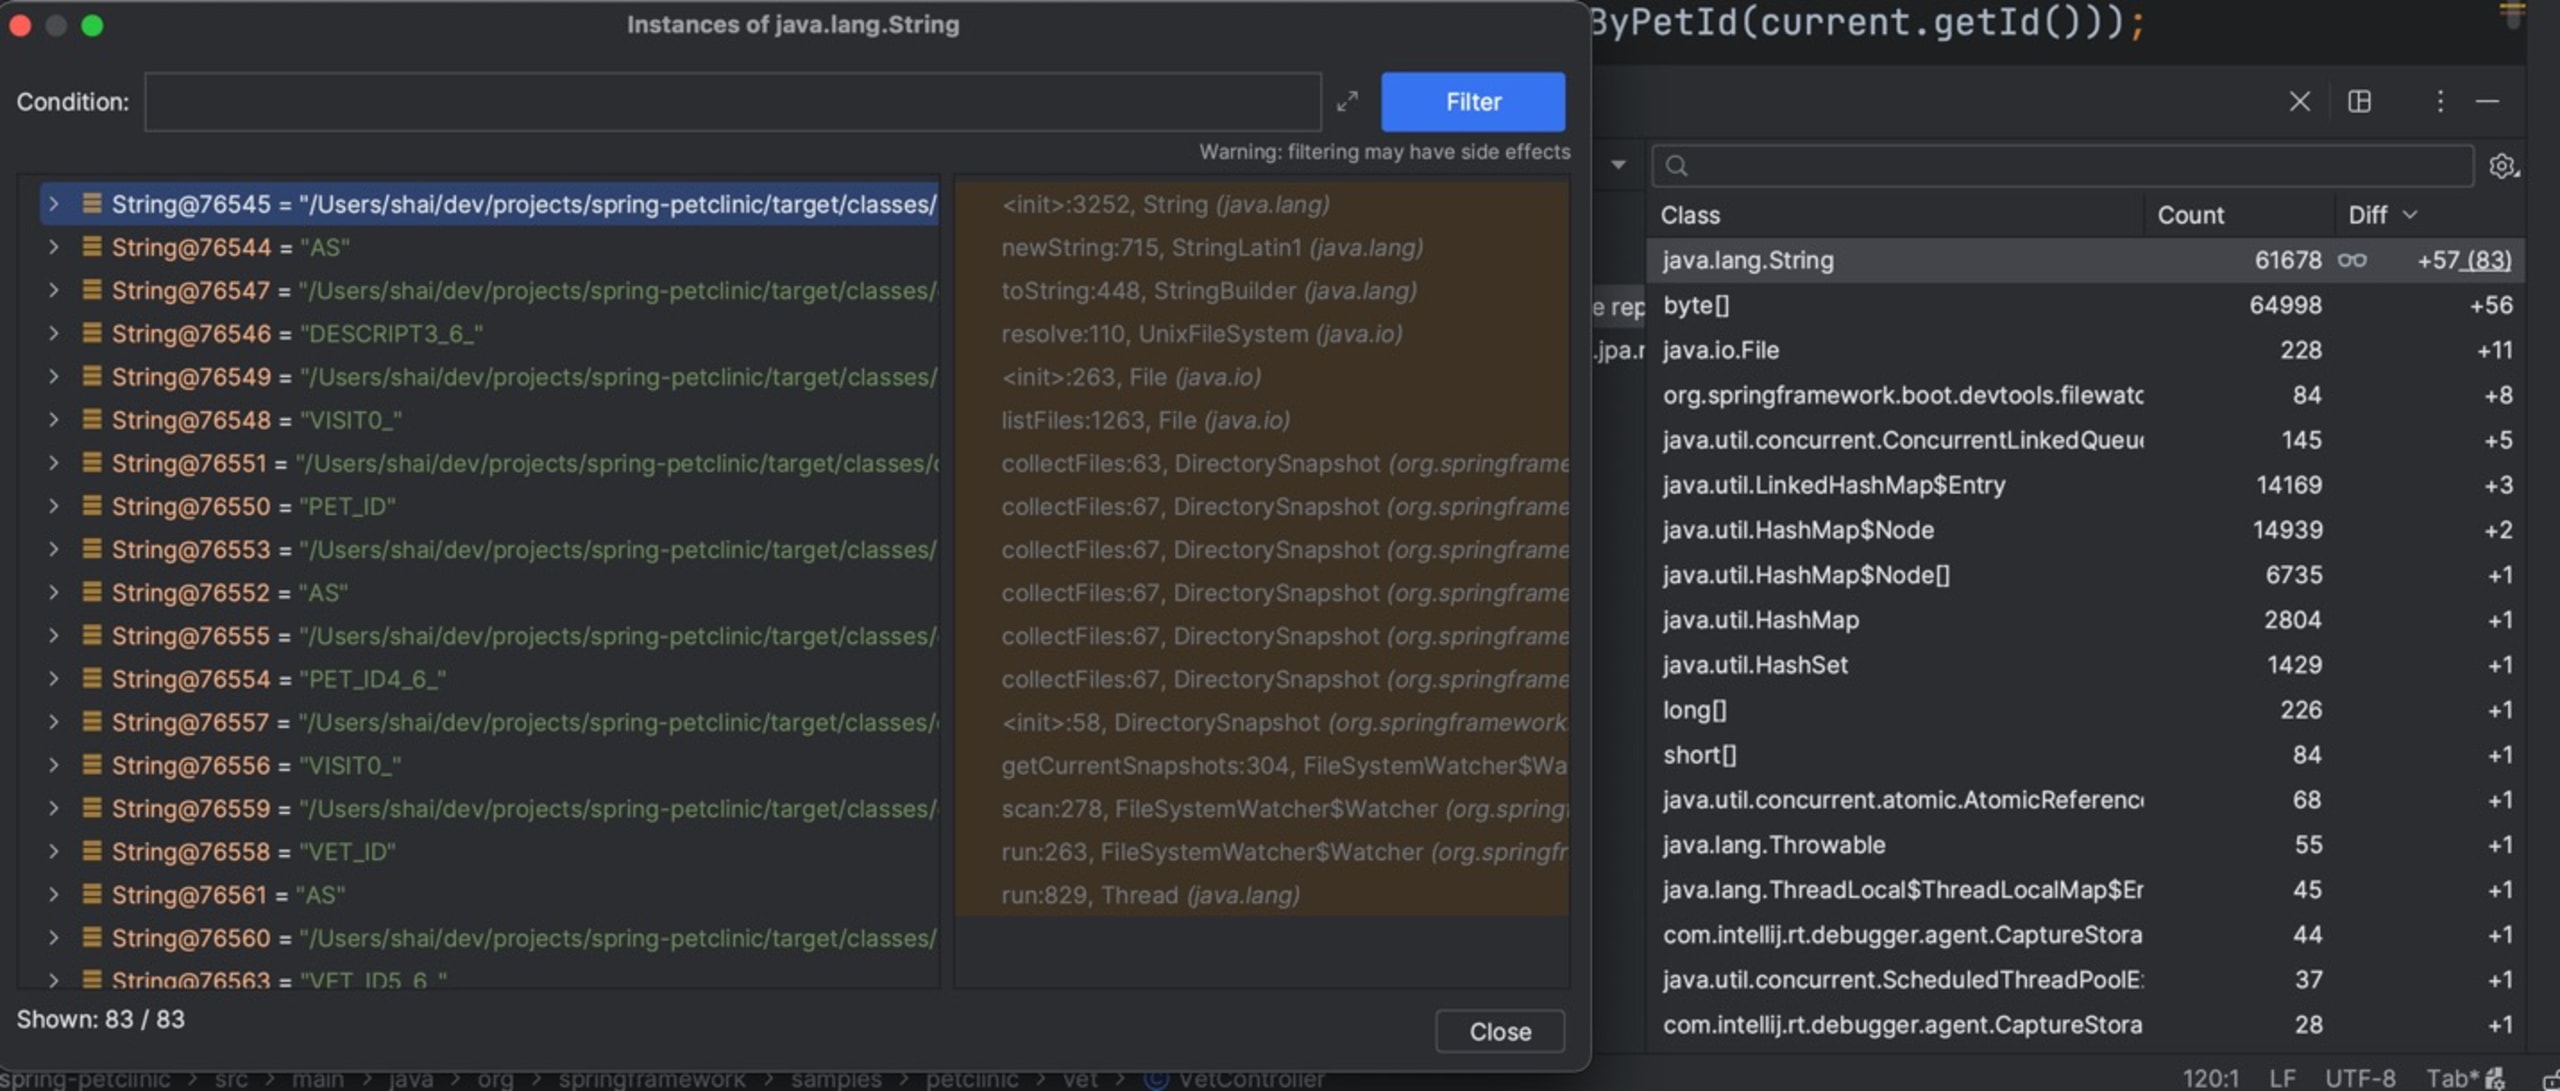
Los perfiladores son excelentes, sin duda. Pero son herramientas amplias. Les falta una solución para la “última milla” cuando nos enfocamos en un error. Tampoco son adecuados para rastrear un objeto problemático u obtener una vista detallada del sistema. Por ejemplo, podemos activar la vista de memoria haciendo clic en la parte superior derecha de la sección de observación y habilitando “Memoria”.
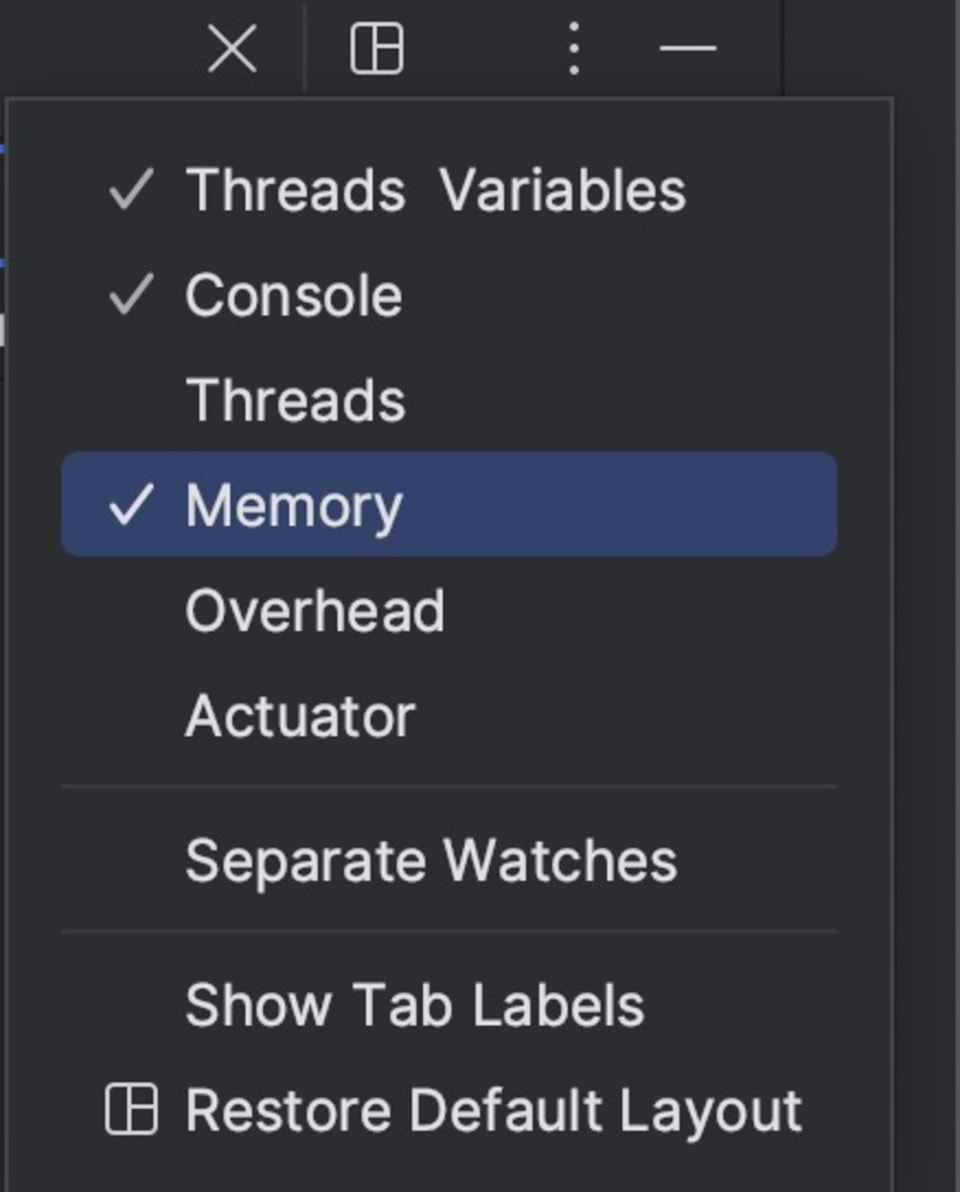
Al hacerlo, podemos ver una lista de los objetos en memoria y hacer doble clic en cada uno para obtener una lista completa de los objetos que contiene. También podemos ver, en la columna “diff”, cuántos objetos de cada tipo se asignaron entre este punto de interrupción y el anterior.
Esto por sí solo ya es increíble, pero también tiene limitaciones. No sabemos qué objetos se asignaron en un momento determinado. Para hacerlo, el IDE tendría que registrar cada asignación de objetos de todos los tipos y conservar una referencia a todos los objetos. Eso no es viable. Pero podemos elegir un tipo de objeto específico, hacer clic derecho y seleccionar la opción Registrar instancias nuevas.
Lo hice con java.lang.String en la captura de pantalla anterior. Eso es lo que indica el ícono de observación que aparece a su lado. Así podemos ver los objetos específicos que se asignaron entre un punto de interrupción y el siguiente. Es sumamente útil, porque nos permite entender lo que hace nuestro código de sistema internamente. Pero hay más…
Al hacerlo, también podemos obtener el seguimiento completo de la pila de cada asignación de objetos y ver las líneas que la provocaron. Esto nos ayuda a comprender cada asignación y el motivo detrás de ella. Podemos usarlo para entender lo que sucede internamente en sistemas grandes y desconocidos.
Es el complemento perfecto para tu perfilador.
Para terminar
Espero que esta publicación haya generado el efecto de asombro que buscaba. Creo que los desarrolladores sienten un temor injustificado ante el proceso de depuración. En gran medida, esto se debe a la falta de herramientas, procesos y mentoría adecuada.
Depurar debería ser una experiencia liberadora. Es una experiencia que nos hace humildes: al depurar, todos nos sentimos principiantes, pero eso no tiene nada de malo. Aunque sea un desafío, el proceso debería ser divertido y emocionante. Deberíamos celebrar las herramientas que tenemos a nuestro alcance y aprovecharlas al máximo.
No trates tu próximo error como una fuga tras un choque. Trátalo como una aventura: una oportunidad para sacar estos nuevos juguetes del garaje y enfrentarte al error con tus nuevas habilidades.


