5 prácticas recomendadas para crear servidores MCP
Escrito por

0 minutos de lectura
Crear servidores MCP se ha convertido en una forma habitual de exponer las capacidades de los productos a aplicaciones de IA y flujos de trabajo impulsados por IA. Si estás empezando a crear servidores MCP, ¿cómo puedes seguir las buenas prácticas y convenciones para aprovechar al máximo tu servidor MCP? Recopilé una lista de prácticas recomendadas a partir de mi experiencia creando algunos con Node.js.
Si leíste artículos anteriores en el centro de recursos de Snyk, es probable que nos hayas visto analizar 7 servidores MCP para gerentes de producto, enseñar a los desarrolladores cómo agregar servidores MCP a Cursor y crear conciencia sobre los riesgos de seguridad de programar con IA por intuición que provocan una vulnerabilidad de seguridad en una aplicación de Node.js.
Esta guía reúne algunos matices y componentes básicos de los patrones que ayudan a que los servidores MCP funcionen bien, y aborda aspectos de la experiencia de desarrollo de los clientes MCP y las capacidades de depuración.
Práctica recomendada 1 para servidores MCP: Sigue los estándares para nombrar herramientas
Los servidores MCP exponen herramientas mediante un nombre y una descripción, y las ponen a disposición en una lista de herramientas que envían como respuesta a los clientes MCP que las solicitan.
Este es un ejemplo de una definición sencilla de herramienta cuyo nombre es getNpmPackageInfo:
Aviso de seguridad: El código de ejemplo anterior de un servidor MCP es vulnerable deliberadamente a la inyección de comandos y forma parte de un artículo educativo sobre vulnerabilidades de seguridad en servidores MCP.
Podrías haber elegido alguno de los siguientes nombres para la herramienta, entre otras opciones:
getNpmPackageInfo(el que usamos en el ejemplo anterior)get-Npm-Package-Infoget.Npm.Package.Infoget Npm Package Information
He observado que, cuando te alejas de las convenciones de facto para nombrar herramientas —usar un guion (-), un guion bajo (_) o snake case (getNpm…)—, los clientes MCP no pueden mostrar la herramienta para que se use, y la experiencia del usuario final es que la herramienta no se ejecuta.
Mi recomendación: No uses espacios ni puntos como separadores (.), y tampoco uses paréntesis o corchetes como ( o ) en el nombre de la herramienta. Esto genera confusión e interfiere por completo con la invocación de la herramienta MCP. Usa siempre la convención snake case para el nombre de la herramienta. GPT-4o entiende mejor la tokenización de esta forma. Como alternativas, puedes usar guiones o guiones bajos como separadores.
La tokenización de los LLM es clave para el nombre de la herramienta
La razón depende del modelo que se use, de la implementación de los clientes MCP y de los hosts MCP que la aprovechan, pero el proceso de tokenización de los LLM es uno de los factores.
Por ejemplo, considera los siguientes casos de cómo los modelos de OpenAI, como GPT-4o, tokenizan el texto:
nodeCryptose divide en dos tokens.
node.Cryptose divide en tres tokens.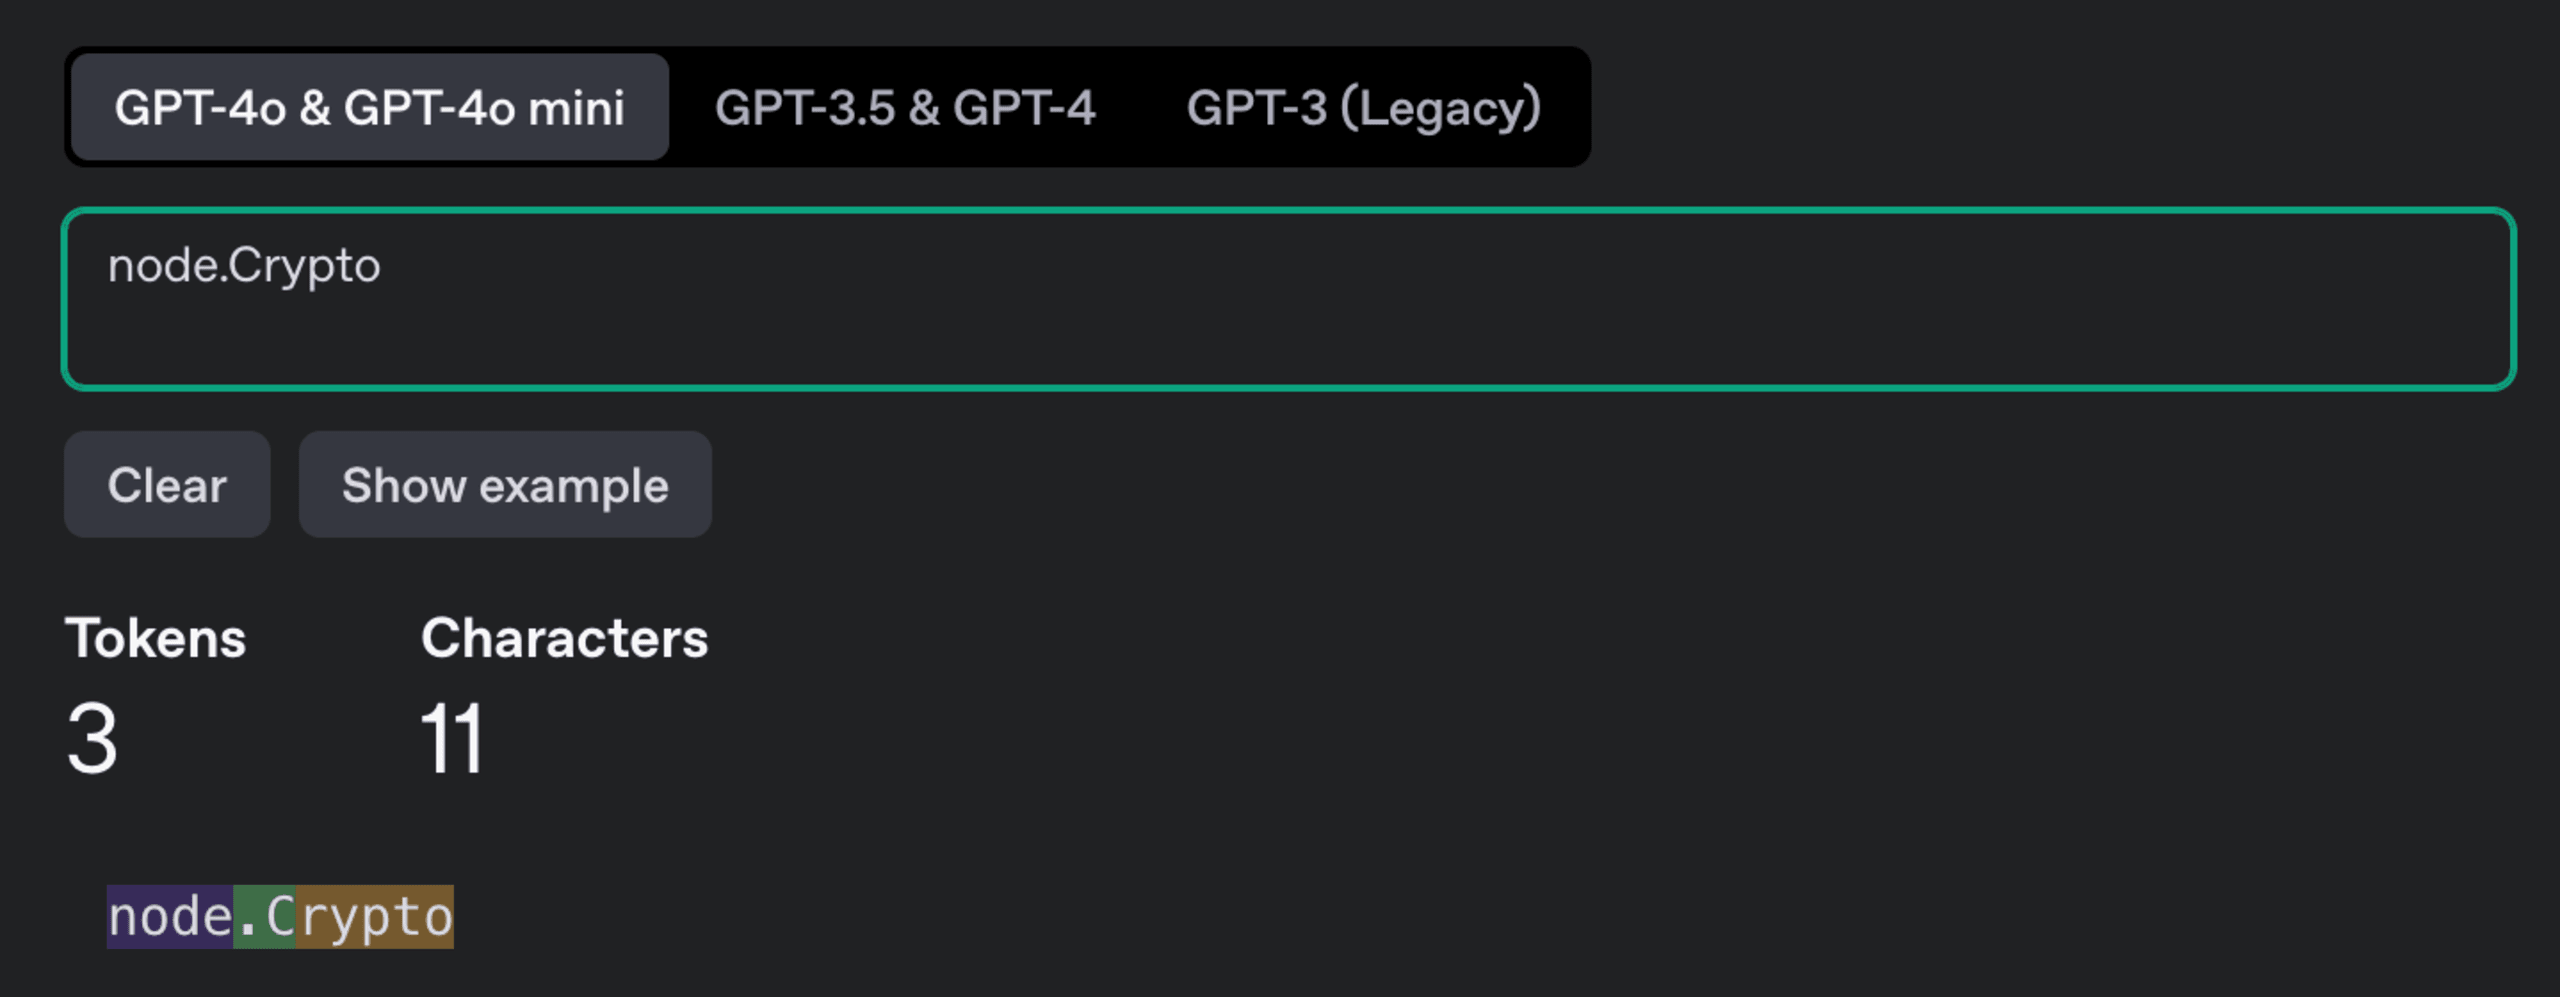
node_cryptose divide en dos tokens.
npm_Utilsse divide en tres tokens.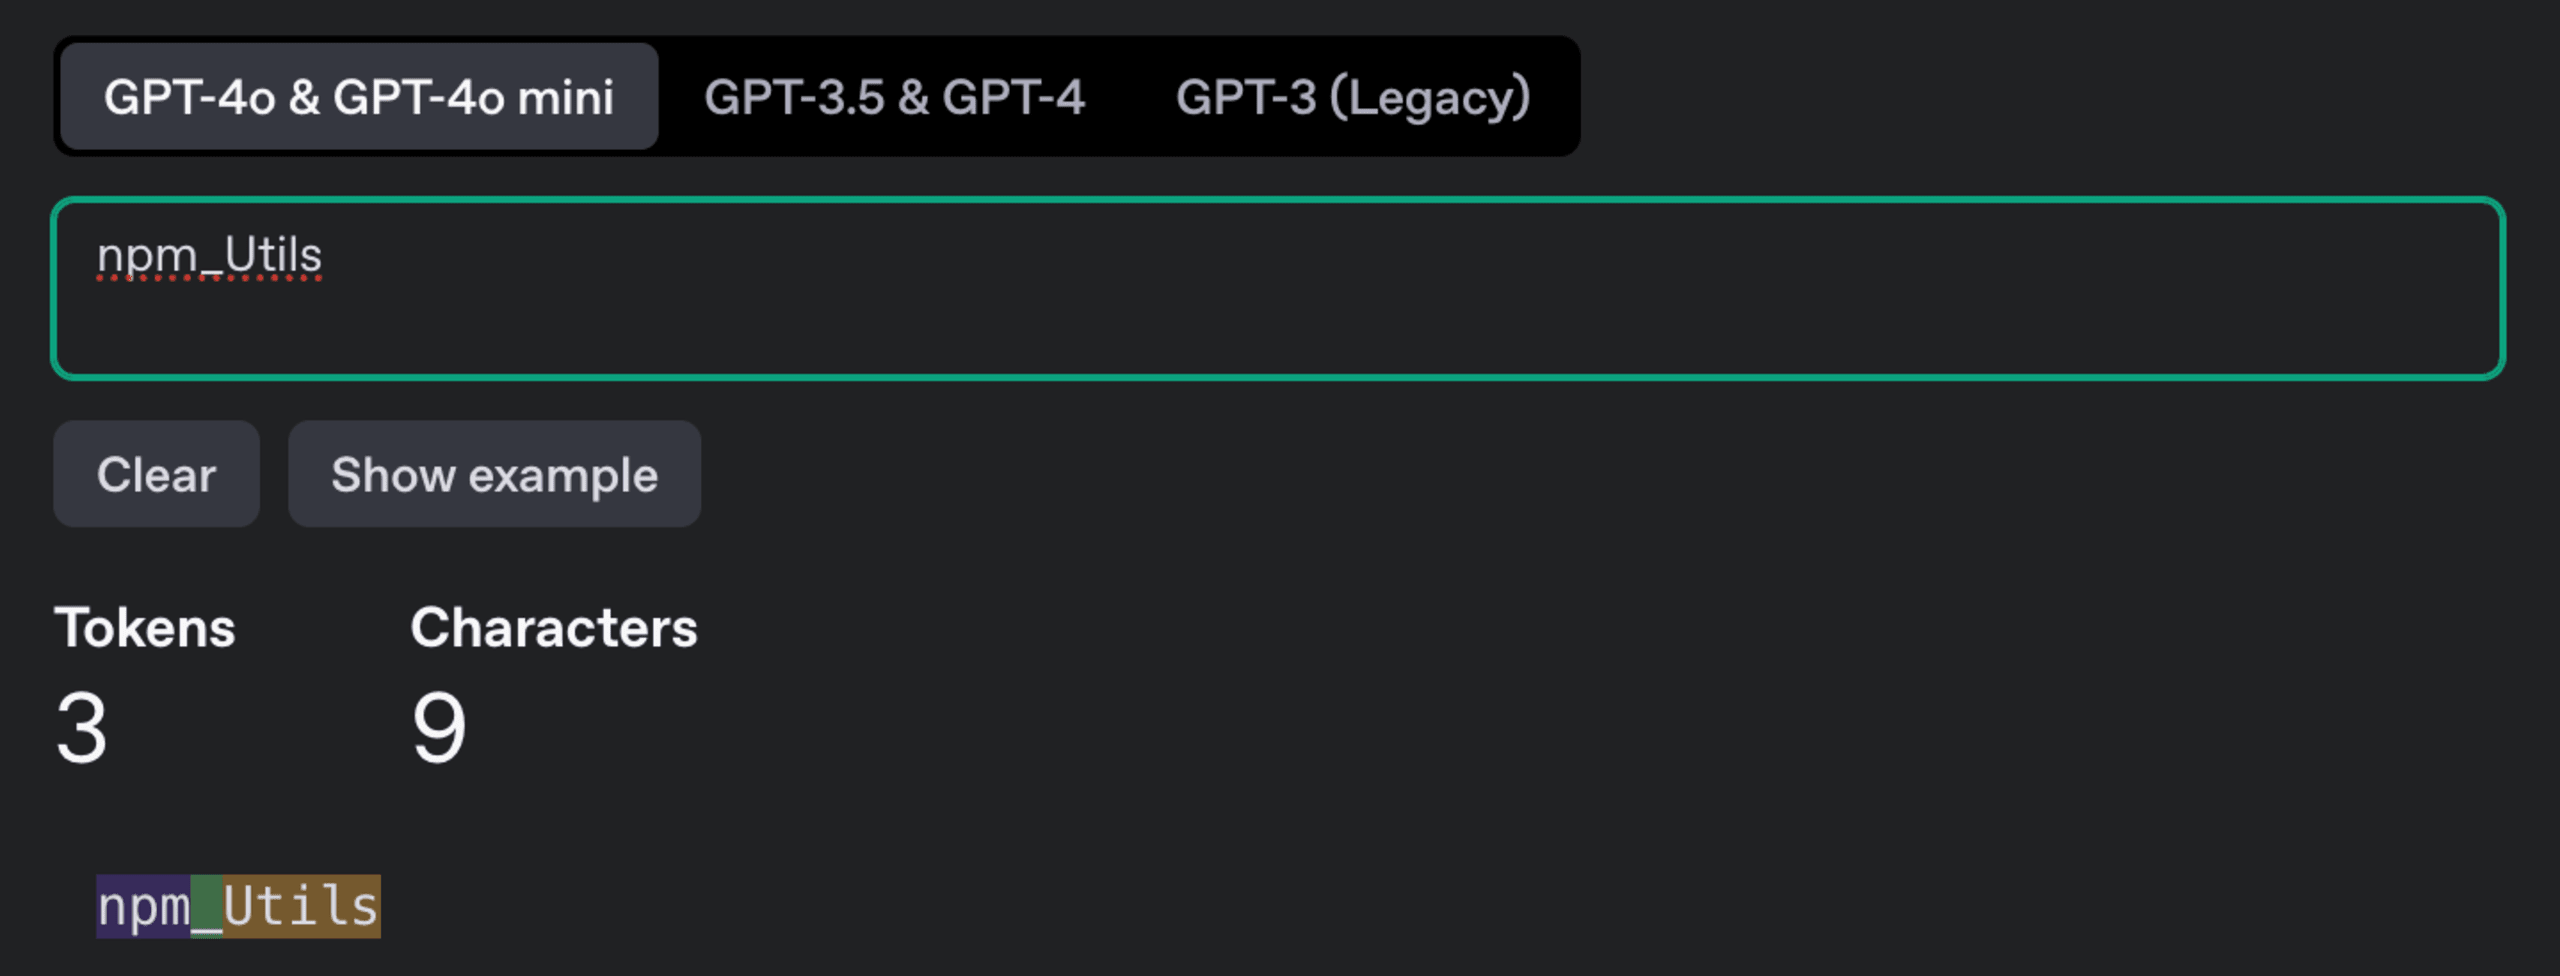
npm_Get_Package_Infose divide en cinco tokens.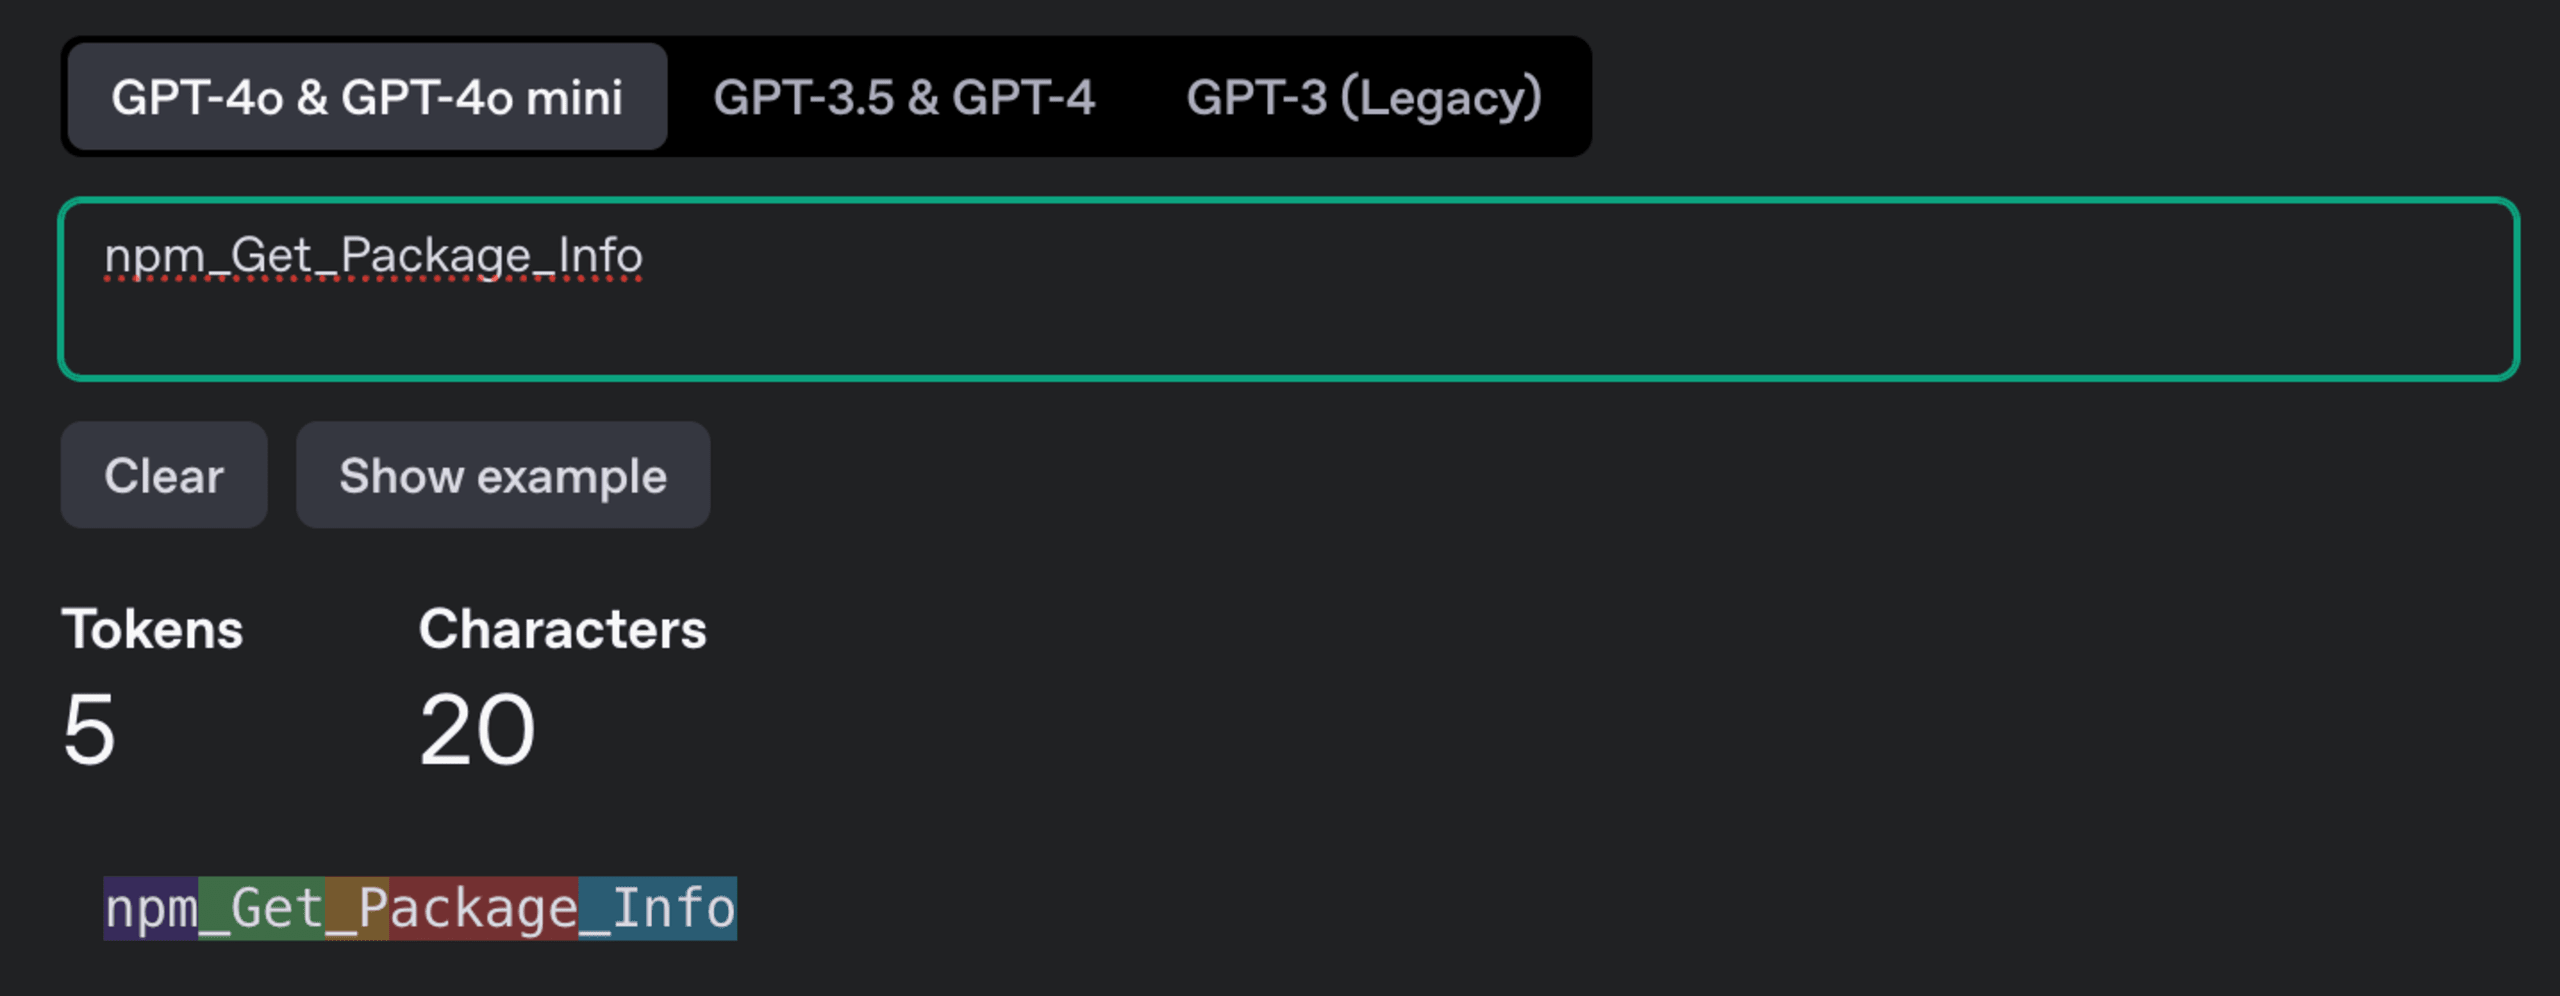
Práctica recomendada 2 para servidores MCP: registro del servidor MCP
¿Cómo puedes saber si la interacción entre el cliente y el servidor MCP no funciona bien? ¿Se llega a invocar la herramienta?
Si intentaste crear un servidor MCP, en especial uno sencillo que depende de STDIO de procesos (entrada/salida estándar), probablemente descubriste que console.log() no funciona bien.
Registrar actividad en la consola o la terminal de los servidores MCP que usan STDIO no es sencillo, porque ese canal de comunicación se usa para intercambiar información entre el cliente MCP y los servidores MCP.
Sin embargo, prescindir por completo del registro no es una opción. El registro eficaz es fundamental para los servidores MCP, ya que ofrece visibilidad esencial sobre la dinámica del programa para resolver las invocaciones de herramientas y otros procesos de la lógica de definición de herramientas. Es probable que necesites solucionar problemas de servidores MCP con eficiencia y obtener información clave sobre la ejecución de flujos de trabajo de IA.
Por lo tanto, para los servidores MCP que siguen el tipo de transporte STDIO de procesos según la especificación MCP, la opción más sencilla es registrar la actividad en archivos: el canal de salida será un archivo de registro y los mensajes se escribirán en un archivo designado para analizarlos después.
Mi recomendación: Usa una biblioteca de registro como pino. En Node.js, agiliza la implementación. Es una excelente opción, creada por colaboradores de Node.js con una larga trayectoria y de confianza, además de los autores de bibliotecas del ecosistema Fastify.
Considera el siguiente ejemplo de uso de pino:
Esta demostración muestra cómo usar pino para crear un registrador que envía los registros a /tmp/mcp-server.log.
Así, se pueden registrar sistemáticamente entradas como la inicialización del registrador. Esta práctica permite monitorear con precisión el flujo del programa de un servidor MCP y tener visibilidad sobre él.
Los servidores MCP que usan transporte HTTP pueden manejar el registro de otra manera; esta práctica recomendada no los abarca.
Práctica recomendada 3 para servidores MCP: Evita los mensajes de respuesta «no encontrado»
Esta recomendación se refiere más al texto de respuesta y a la lógica de implementación de las invocaciones de herramientas, y se basa en mi experiencia, aunque es limitada. Aun así, mis observaciones y experimentos parecen confirmarla.
La idea es la siguiente: cuando implementes invocaciones de herramientas como «search», evita responder con un mensaje de «no encontrado». En su lugar, proporciona al LLM la mayor cantidad posible de datos generales.
Un caso práctico fue cuando creé un servidor MCP para la documentación de la API de Node.js e implementé una herramienta nodeSearch. Si los usuarios preguntan por una API relacionada con un método del entorno de ejecución de Node.js, puede que no la encuentren al principio porque la implementación de la herramienta nodeSearch busca módulos principales de Node.js por nombre, no los métodos reales de la API subyacente.
Al principio, la respuesta que elegí para esos casos fue Module <xyz> not found. <here is everything I have>, pero descubrí que, aunque proporcionara todos los módulos y métodos, el texto «no encontrado» al comienzo de la respuesta orientaba al LLM y evitaba que buscara el método en uno de los módulos principales de Node.js compatibles con los datos que había proporcionado.
Mi recomendación: No devuelvas un mensaje de «no encontrado». En su lugar, proporciona otros datos pertinentes. Por supuesto, hay excepciones, porque a veces no puedes devolver todos los datos. Por ejemplo, si quieres buscar usuarios, probablemente sería incorrecto, inseguro y una violación de la privacidad.
¿Te interesa ver esta práctica antes y después de aplicarla? Mira a continuación.
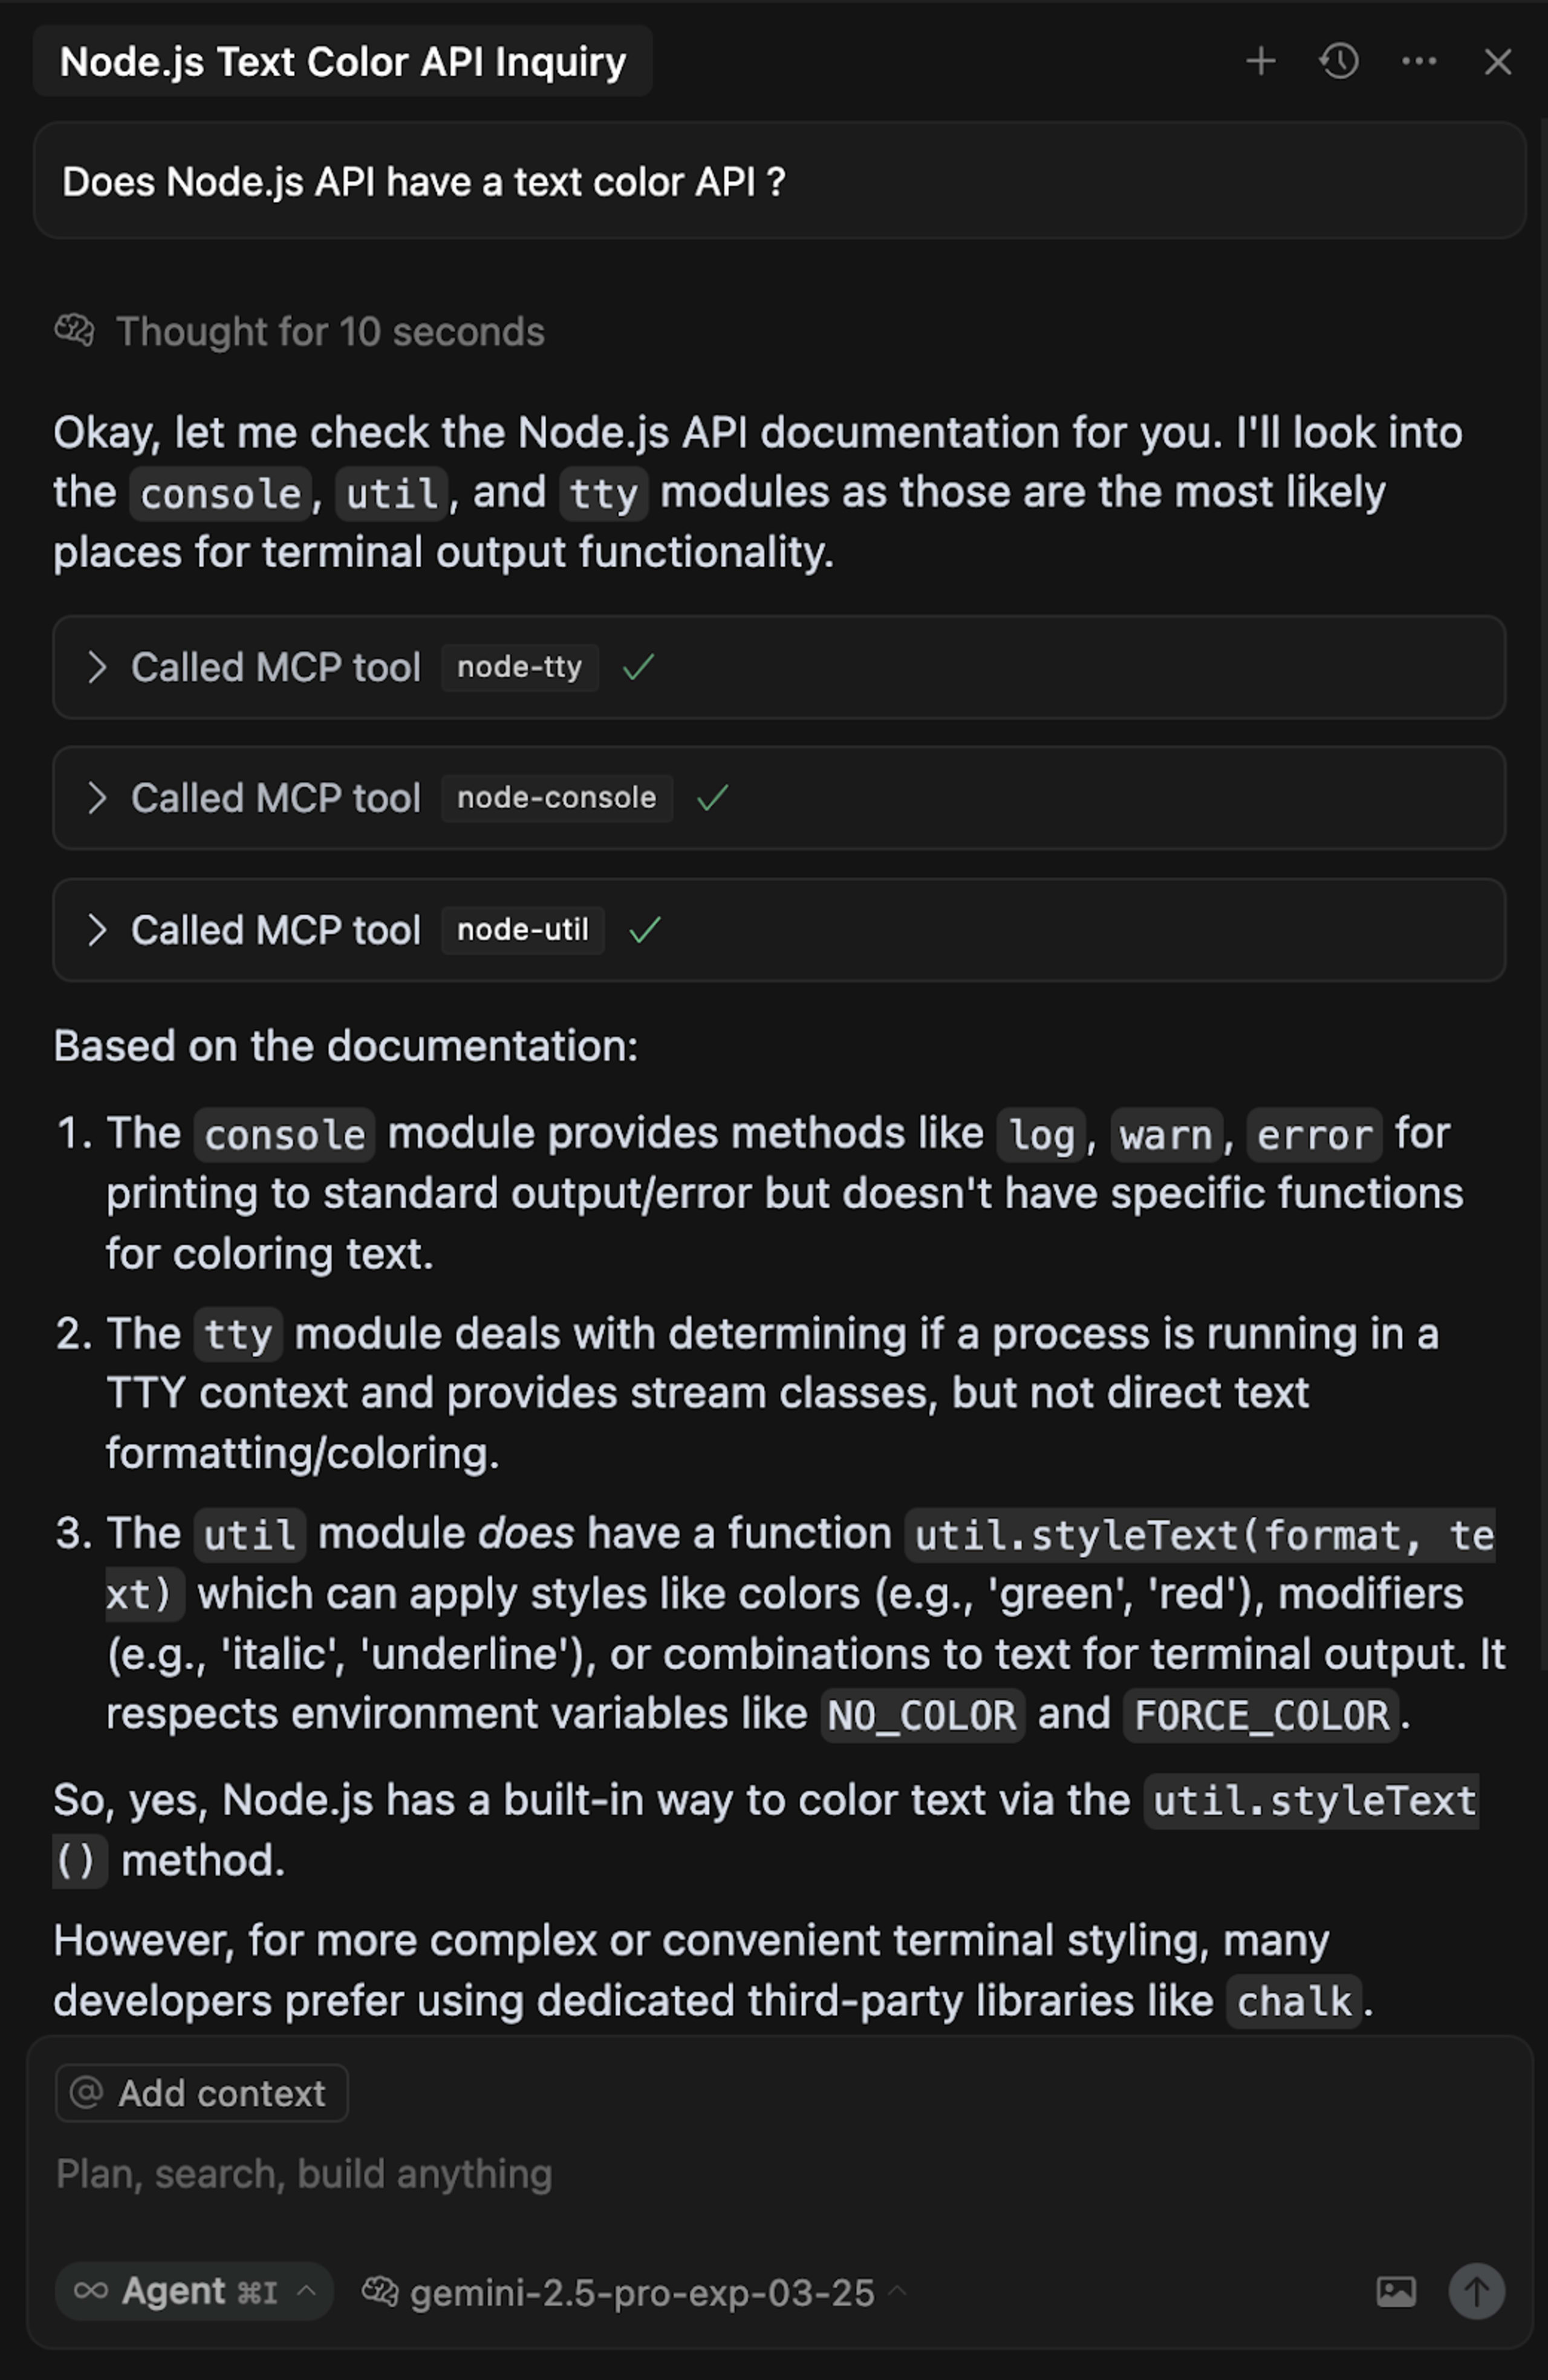
Este es un ejemplo de una interacción de chat en un IDE que usa un servidor MCP con una invocación de herramienta que devuelve un mensaje de «no encontrado». Como puedes ver, no logra identificar la respuesta correcta:
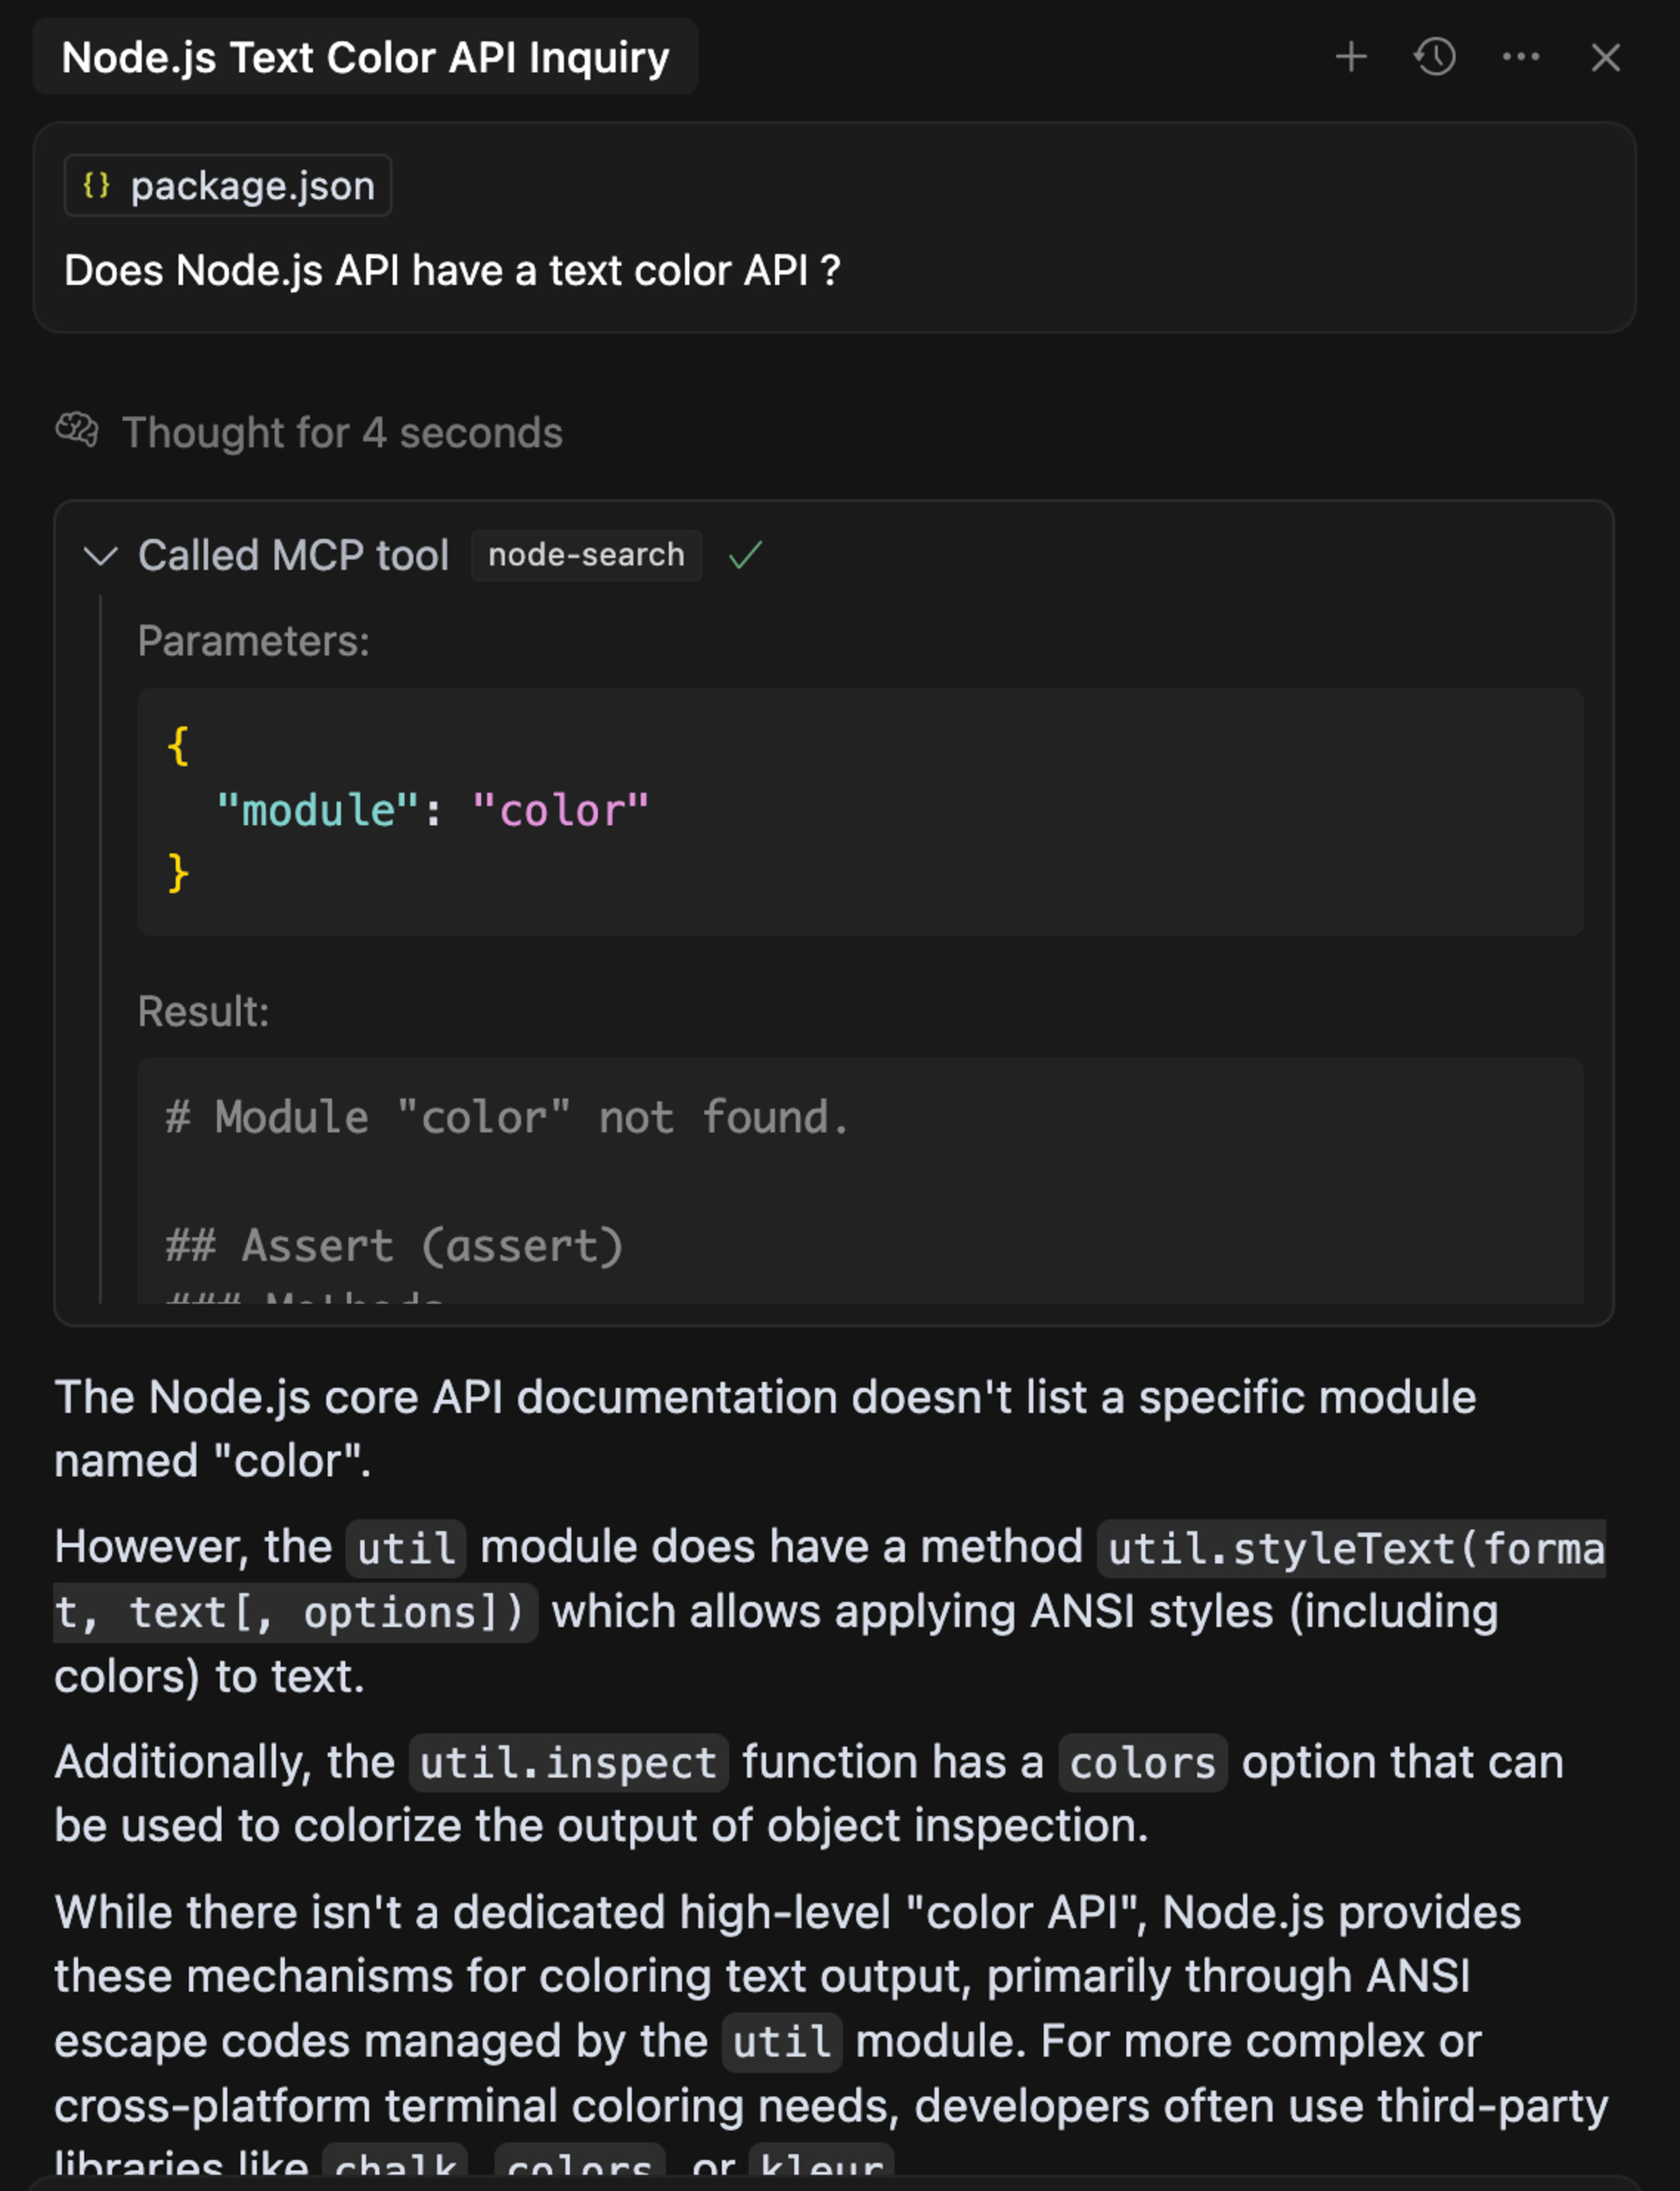
Sin embargo, cuando quitamos # Module “color” not found de la parte superior de la respuesta de texto y respondemos con todos los módulos principales de Node.js disponibles y sus métodos, el LLM puede explorar distintos módulos y encontrar una mejor solución.
Funciona:
Práctica recomendada 4 para servidores MCP: Evita los componentes vulnerables de terceros
No podemos dejar de lado la seguridad en una serie sobre prácticas recomendadas de una empresa de seguridad de IA como Snyk, ¿verdad?
Para que los servidores MCP se adopten ampliamente en las organizaciones y los acepten los equipos de infraestructura interna, deben cumplir requisitos estrictos de seguridad y cumplimiento. Los equipos de TI y seguridad de productos conocen muy bien los riesgos de incorporar dependencias potencialmente vulnerables a sus flujos de trabajo. No es algo nuevo: forma parte de los requisitos de SBOM establecidos por la orden ejecutiva de Biden tras las consecuencias del ataque a SolarWinds.
Es fundamental evitar los componentes vulnerables de terceros. Cualquier software que dependa de bibliotecas de terceros o contenga código con vulnerabilidades conocidas puede convertirse en un punto de entrada para actores maliciosos. Por su función, un servidor MCP suele tener amplio acceso y capacidades de integración, por lo que cualquier vulnerabilidad representa un riesgo significativo.
Por eso, garantizar que tus servidores MCP no tengan vulnerabilidades no es solo una práctica recomendada: es necesario para implementarlos con éxito.
Mi recomendación es usar Snyk. Pero ¿cómo empezar a proteger los servidores MCP y dónde buscar?
Analiza el código en busca de vulnerabilidades: Snyk puede analizar tu base de código para detectar fallas de seguridad y patrones de código inseguro, y ofrecer correcciones en el IDE o en otros flujos de trabajo de desarrollo.
Revisa si hay dependencias vulnerables: Una de las fortalezas fundamentales de Snyk es proteger el software de código abierto. Snyk analiza las dependencias del proyecto con una base de datos integral de vulnerabilidades conocidas y te alerta sobre los riesgos y las versiones a las que debes actualizar.
Garantiza el cumplimiento: Las implicaciones legales pueden parecer aburridas para los desarrolladores, pero son muy importantes para las empresas. Snyk te ayuda, como desarrollador, a evitar problemas de responsabilidad legal al identificar vulnerabilidades que incumplen los estándares de seguridad y licencias.
Aquí tienes una demostración práctica de cómo usar Snyk para encontrar dependencias vulnerables de código abierto:

Snyk también detecta código vulnerable en tu propia base de código, como inyección de comandos, traversal de rutas y otros tipos de código inseguro que hayas escrito o que quizá haya generado el LLM. En cualquier caso, Snyk analiza el código.
Práctica recomendada 5 para servidores MCP: Empaqueta el servidor MCP como un contenedor Docker
Crear servidores MCP es beneficioso, pero implementarlos y administrarlos puede generar complejidades para los usuarios finales.
A menudo, los servidores MCP necesitan un entorno de ejecución específico, como Python con uv o Node.js con npm. Esta dependencia de un entorno de programación específico puede dificultar el uso de estos servidores para los usuarios finales. Deben configurar su entorno con precisión para ejecutar correctamente el servidor MCP, lo que puede provocar inconsistencias, conflictos de versiones, errores y un proceso de configuración complicado.
Una solución eficaz a este problema es empaquetar el servidor MCP como un contenedor Docker. Los contenedores Docker ofrecen un entorno estandarizado y aislado que incluye todas las dependencias, bibliotecas y componentes de ejecución necesarios para que el servidor MCP funcione correctamente. Al distribuir el servidor MCP como una imagen de contenedor, los usuarios solo necesitan tener Docker instalado para ejecutarlo.
Docker incluso creó un centro de servidores MCP en forma de imágenes de contenedor para los servidores MCP más populares:
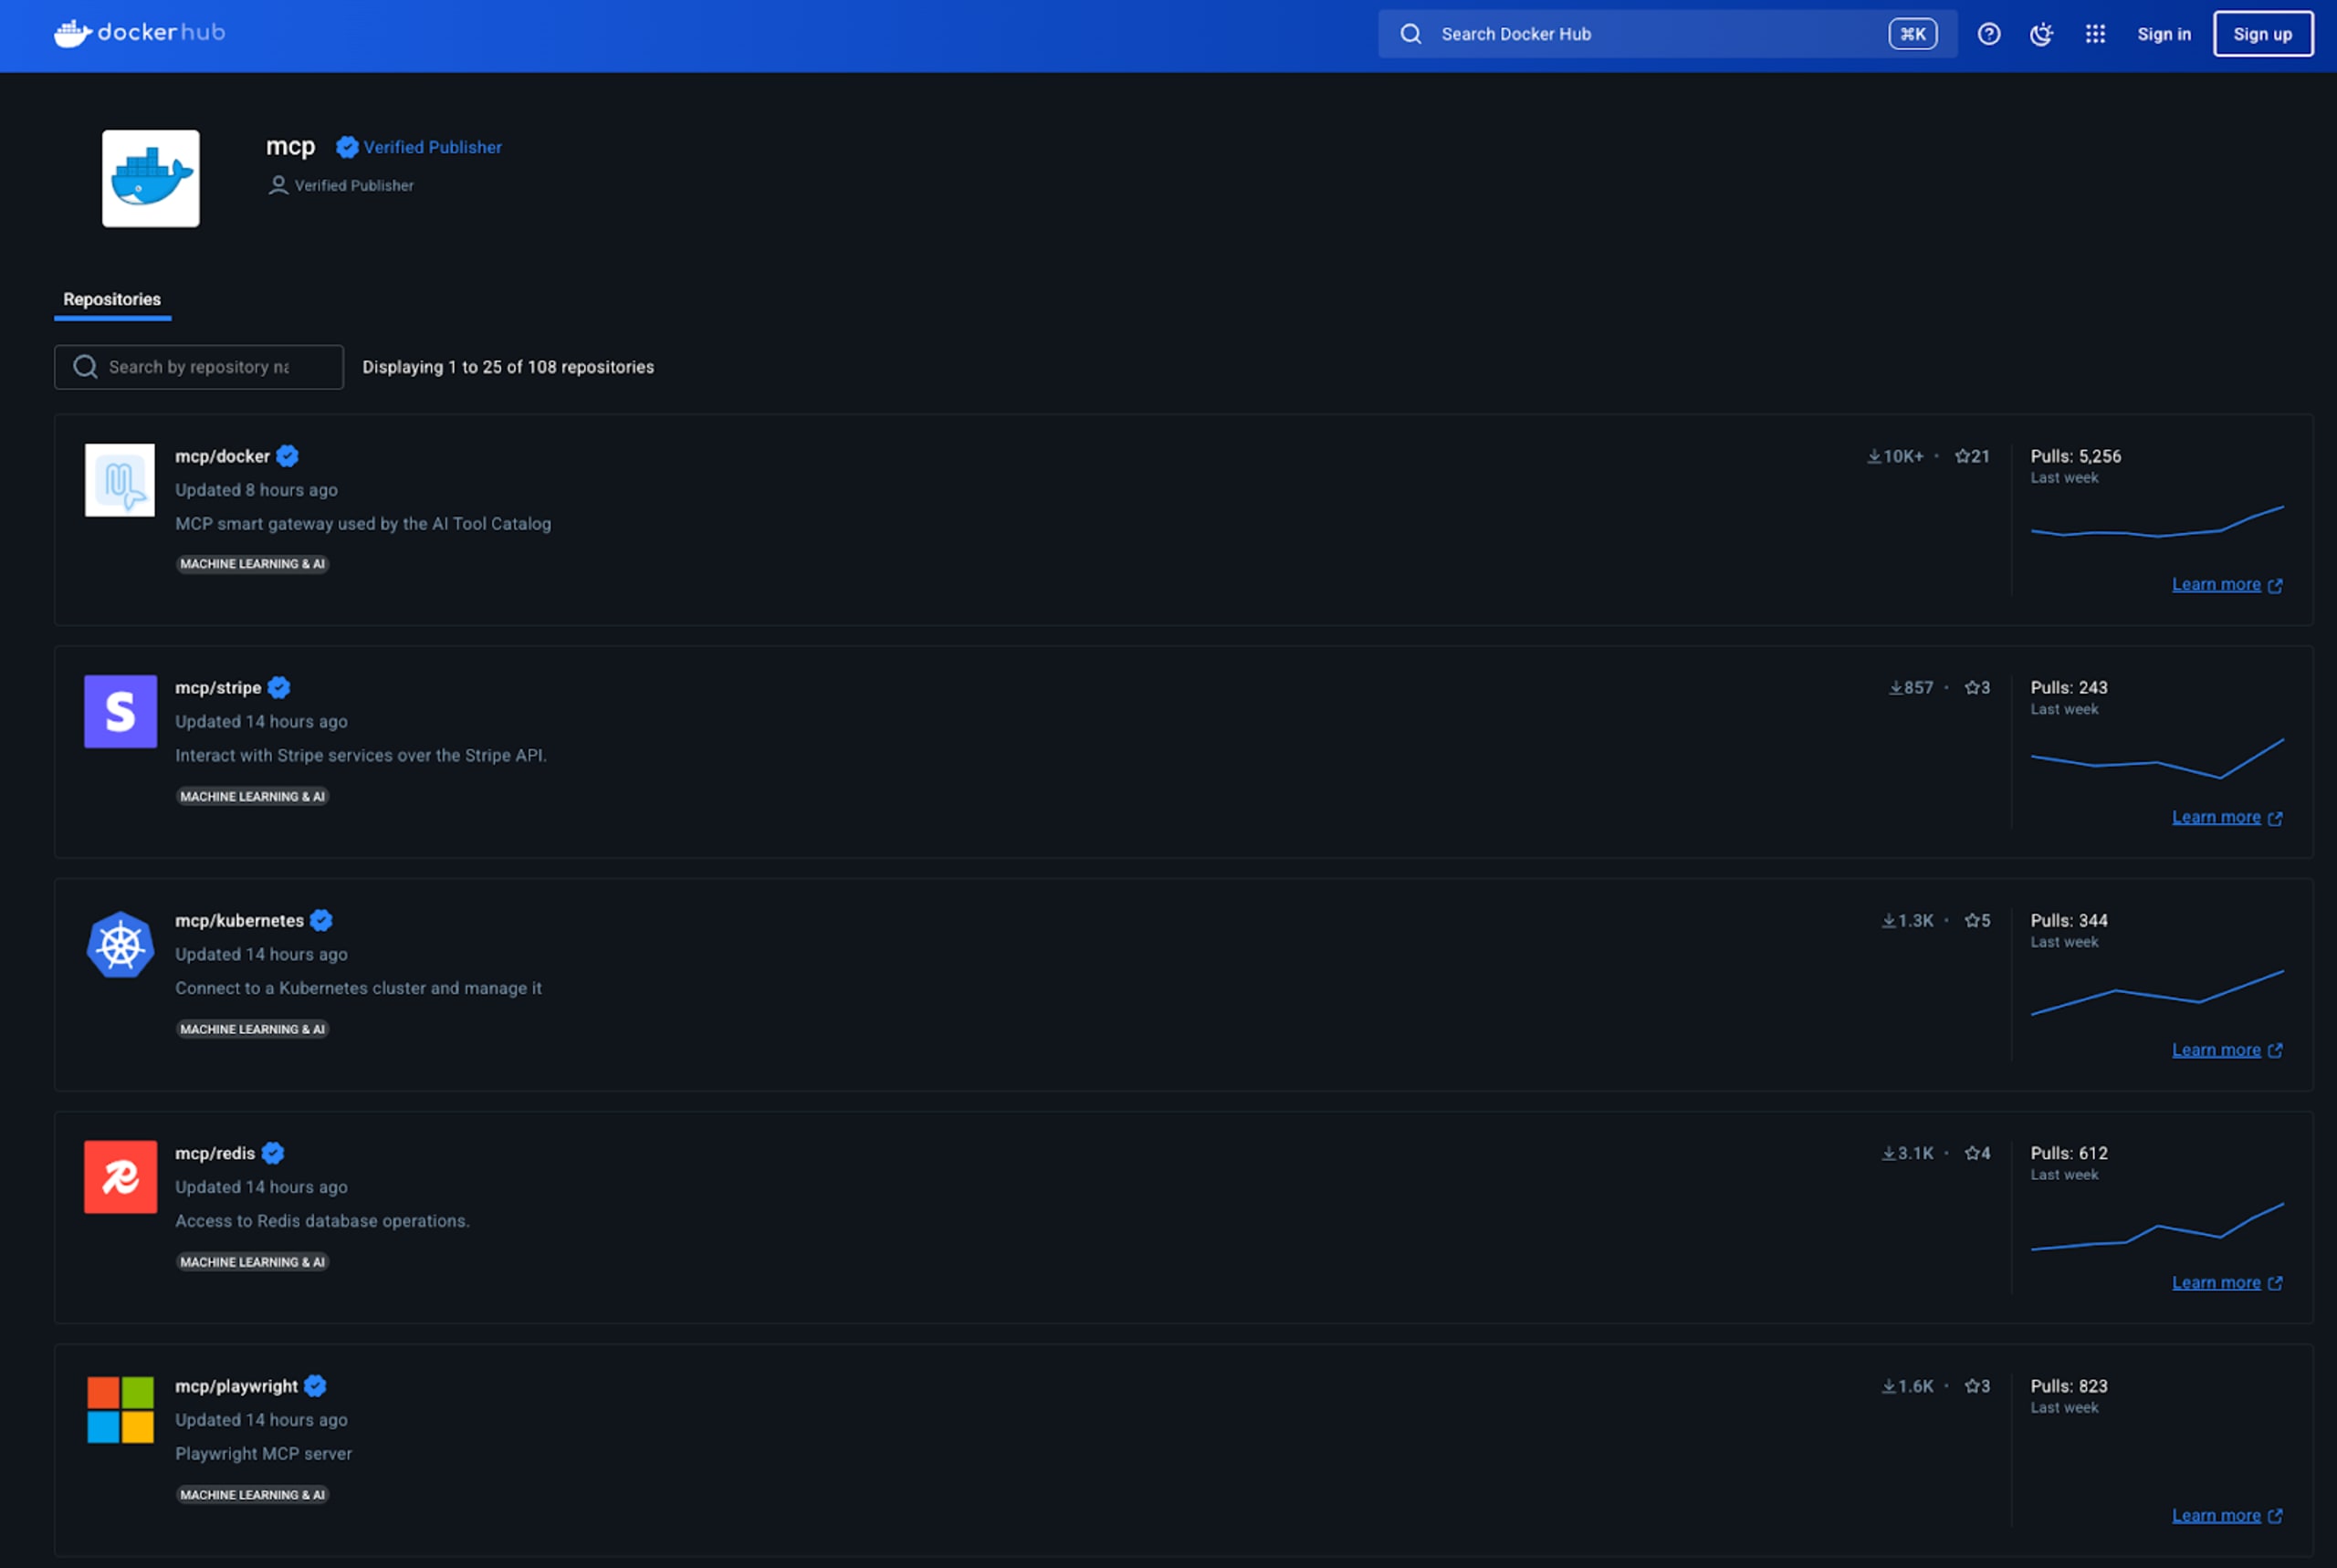
Docker funciona como una capa de abstracción aceptada por la industria que empaqueta las aplicaciones y sus dependencias en un contenedor portátil. Este enfoque simplifica la implementación, garantiza la coherencia entre distintos entornos y elimina el problema de «en mi máquina sí funciona».
Estas son algunas ventajas de ofrecer imágenes Docker para los servidores MCP que crees:
Coherencia: Garantiza que el servidor MCP funcione de la misma manera en desarrollo, pruebas y producción.
Aislamiento: Evita conflictos entre las dependencias del servidor MCP y otras aplicaciones del sistema host.
Portabilidad: Facilita la implementación del servidor MCP en cualquier sistema compatible con Docker.
Implementación simplificada: Reduce los pasos que deben seguir los usuarios finales para poner en marcha el servidor MCP.
Administración de recursos: Docker ofrece herramientas para administrar recursos como CPU, memoria y red, y garantizar que el servidor MCP funcione de manera eficiente.
Buenas prácticas para desarrollar con IA de forma segura
10 consejos para ayudar a desarrolladores y profesionales de seguridad a mitigar eficazmente los posibles riesgos y aprovechar al máximo los beneficios del desarrollo con IA.