Prévention des pertes de données pour les développeurs

24 mai 2023
0 minutes de lectureUne faille de sécurité entraînant une violation de données peut causer des dommages coûteux à la réputation d’une entreprise. Mais qu’est-ce qu’une violation de données, au juste ? La Commission européenne a divisé les violations de données en trois catégories distinctes : les violations de confidentialité, d’intégrité et de disponibilité :
Une violation de confidentialité se produit lorsque des données personnelles sont divulguées ou consultées sans autorisation, ou par accident.
Une violation d’intégrité se produit lorsque des données personnelles sont modifiées sans autorisation ou par accident.
Une violation de disponibilité se produit lorsque l’accès à des données personnelles est perdu ou que celles-ci sont détruites, par accident ou sans autorisation.
Dans cet article, vous découvrirez ce qu’est une violation de données et comment les prévenir lors de la conception et du développement de vos logiciels.
Qu’est-ce qu’une perte de données ?
Avant d’apprendre à prévenir les pertes de données, il est important de définir ce qu’elles sont exactement, car elles peuvent prendre plusieurs formes, comme une attaque par rançongiciel ou une attaque informatique.
Un rançongiciel peut infecter un système après le téléchargement d’un logiciel malveillant : les données d’une entreprise sont alors chiffrées et rendues inaccessibles, à moins qu’une importante somme d’argent ne soit versée au pirate pour les déchiffrer. Un pirate peut également menacer de publier ces données si la somme n’est pas payée, ce qui constitue une violation de confidentialité.
Comment une fuite de données peut se produire
Une violation de données n’est pas toujours perpétrée par un concurrent ou par quelqu’un qui cherche à nuire à une entreprise pour en tirer un bénéfice financier. Elle peut aussi être due à une erreur humaine. Selon le site GRC eLearning, 82 % des violations de données impliquent un facteur humain : une action manuelle est à l’origine de la violation. Même sans intention malveillante, une perte de données peut survenir si un employé perd un appareil physique, comme un ordinateur portable de l’entreprise. C’est pourquoi les formations destinées à l’ensemble des entreprises sont indispensables pour réduire ce type d’incident.
En vertu de la législation européenne, des amendes astronomiques pouvant atteindre 20 millions d’euros ou 4 % du chiffre d’affaires (le montant le plus élevé étant retenu) peuvent être infligées. Tessain a publié un article recensant les plus lourdes amendes infligées pour des violations de données cette année. Amazon arrive en tête avec la somme impressionnante de 746 millions d’euros (877 millions de dollars américains), suivi de WhatsApp, condamné à une amende de 225 millions d’euros (255 millions de dollars américains).
Sensibilité des données et gravité des pertes
La gravité d’une violation de données dépend également du type de données divulguées ou perdues. Il peut s’agir de données personnelles, notamment biométriques, médicales, génétiques, politiques ou religieuses. Par exemple, si une entreprise utilise des lecteurs d’empreintes digitales pour contrôler l’accès aux bureaux, ces empreintes sont stockées sur ses serveurs. Si l’entreprise est victime d’un piratage et qu’un tiers malveillant accède à toutes les données qui y sont hébergées, les données biométriques de tous les employés sont alors menacées. Plus les données divulguées sont sensibles, plus l’amende encourue est élevée.
Comment prévenir les pertes de données
Avec l’augmentation du volume de données et le durcissement des amendes infligées aux entreprises victimes de pertes de données, le sujet est de plus en plus préoccupant. Voyons comment prévenir les pertes et les fuites de données — ou, à tout le moins, en limiter la fréquence — lors du développement de logiciels.
Choisir la bonne architecture
Prévenir les fuites de données exige bien plus que de bonnes politiques de sécurité. Vous devez choisir la bonne architecture pour limiter les pertes de données. Les grandes entreprises peuvent opter pour une approche de conception pilotée par le domaine (DDD), qui permet de séparer correctement les composants du système.
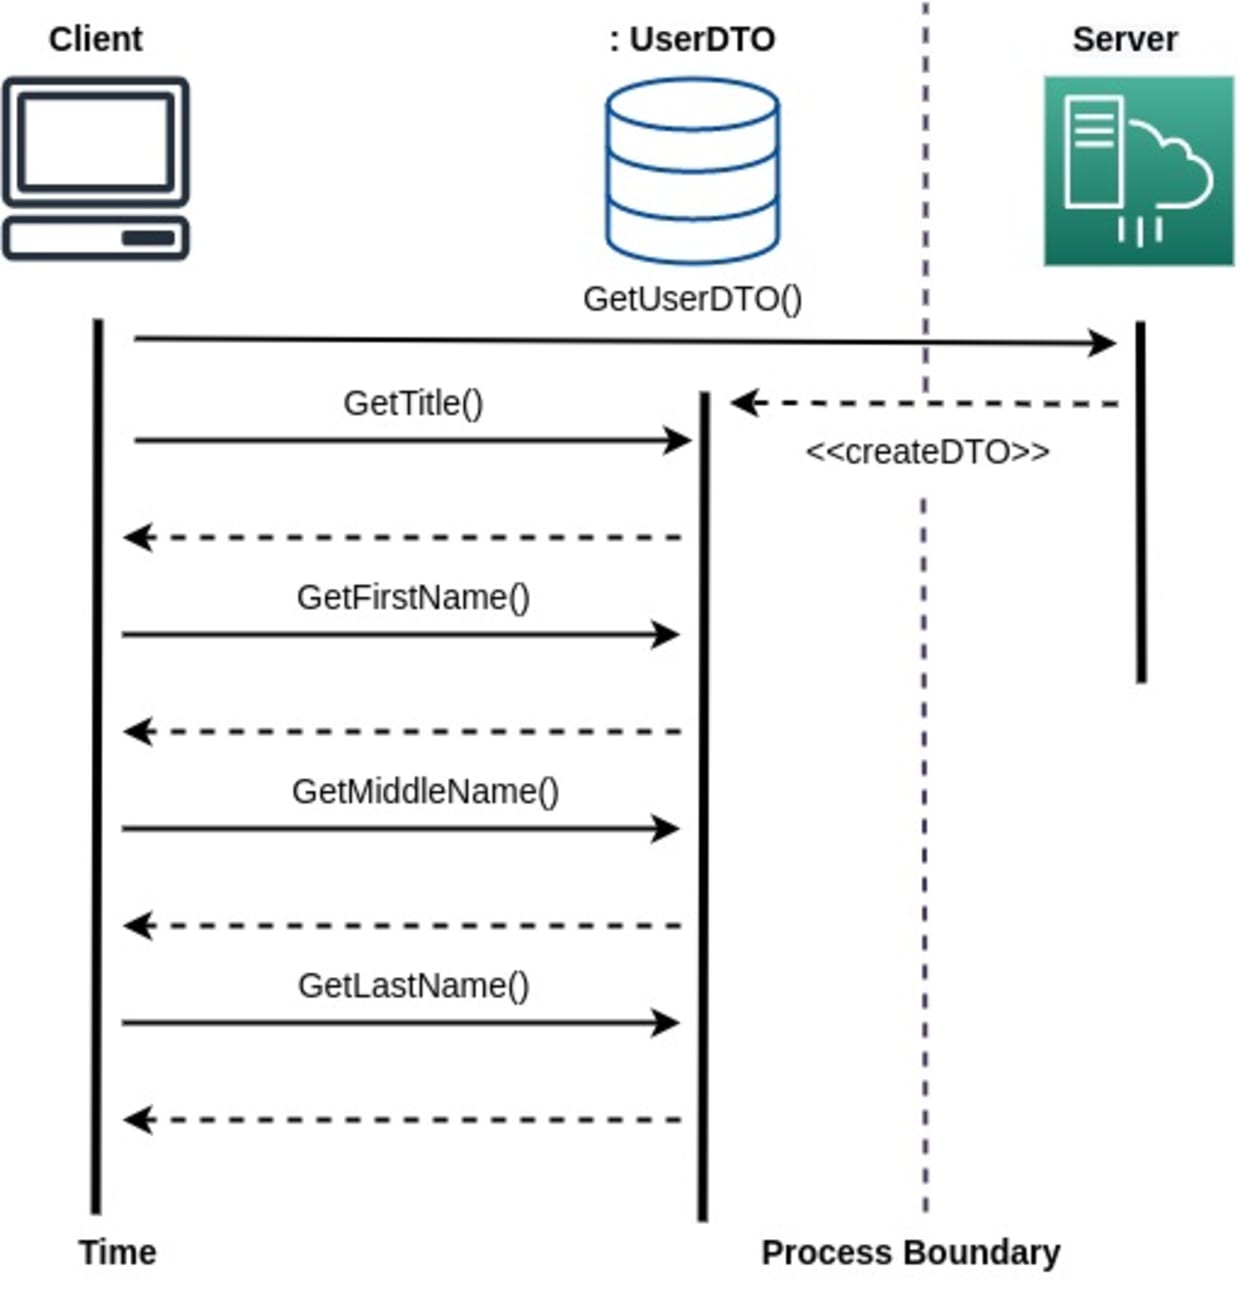
En séparant la couche de présentation de la logique métier et des entités du domaine, les développeurs peuvent obtenir un couplage faible et une forte cohésion. Pour cela, vous pouvez utiliser des objets de transfert de données (DTO). Ces objets transportent des données entre les processus tout en réduisant le nombre d’appels de méthodes entre le client et le serveur.
Comme la plupart des transferts de données impliquent des communications à distance, récupérer des informations nécessite souvent plusieurs requêtes. Par exemple, une application cliente peut effectuer les appels distants suivants au serveur pour récupérer le nom d’une personne :
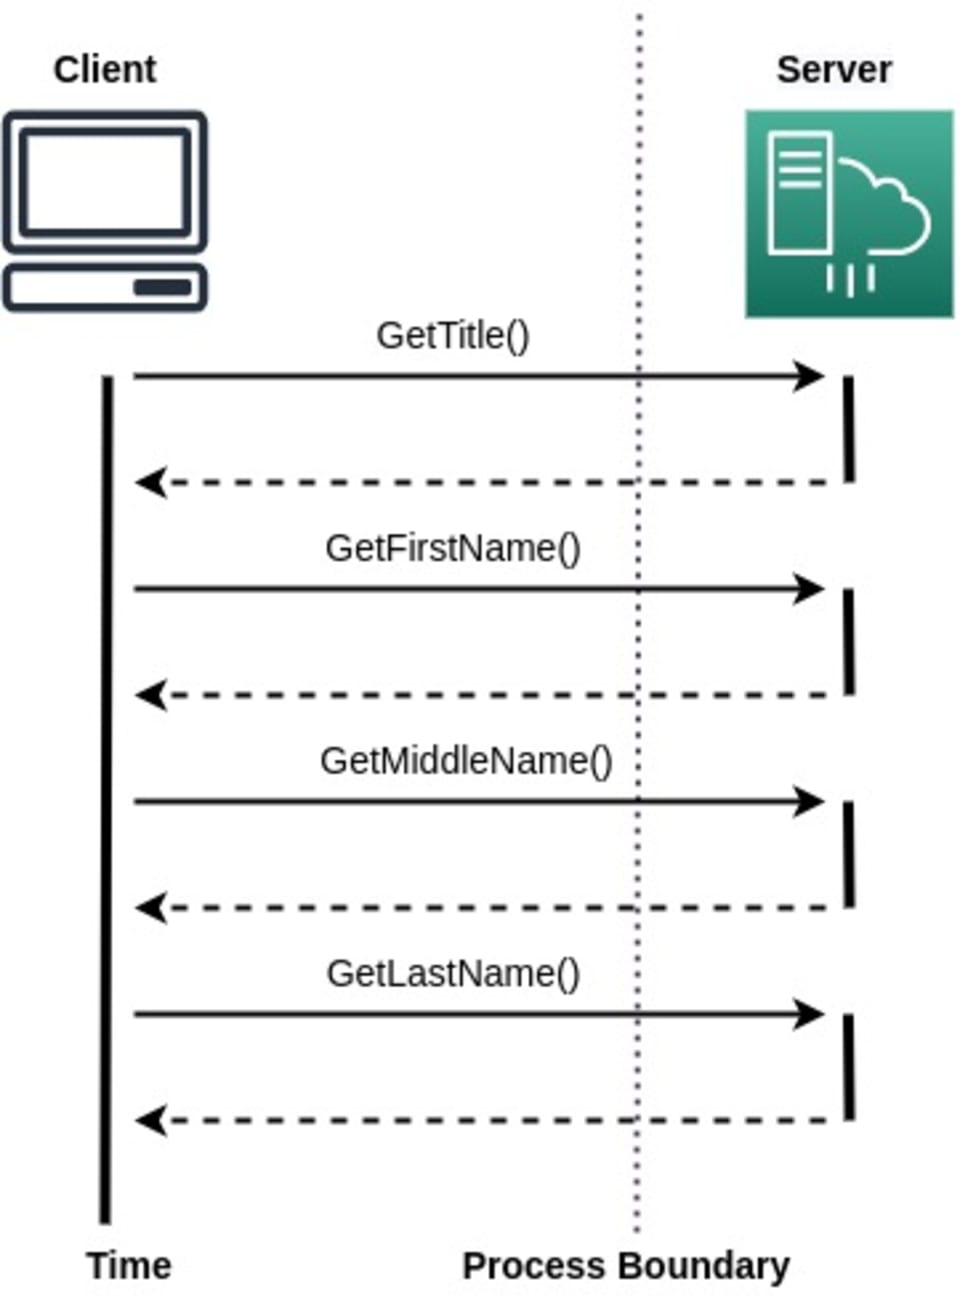
Comme vous pouvez le constater, plusieurs appels distants sont nécessaires pour obtenir toutes les informations voulues. Vous pouvez toutefois utiliser un DTO pour regrouper les différentes valeurs et le renvoyer en réponse à la requête du client. Celui-ci peut ensuite interagir localement avec le DTO et récupérer les valeurs au besoin. Cette méthode réduit le nombre d’appels distants et limite l’exposition des données sur le réseau :
Identifier les données sensibles
La sécurisation des données sensibles doit être une priorité dès le début du cycle de développement logiciel (SDLC). Vous devez prévoir soigneusement comment stocker les données financières, les objectifs commerciaux, les dossiers médicaux, etc.
Il est essentiel de savoir comment protéger les données à caractère personnel (PII). Toute donnée permettant d’identifier une personne de manière unique, au sein ou en dehors de l’entreprise, relève des PII. La législation sur leur stockage et leur utilisation varie selon les régions, mais toute perte ou fuite de ces données peut entraîner de lourdes sanctions financières et nuire à votre réputation.
Il est recommandé de collecter le moins de données possible. Si votre application n’a pas besoin de certaines données, ne les collectez pas. Moins de données signifie moins de temps consacré à leur sécurisation. À défaut, les conséquences des violations seront moins graves. Des techniques d’obfuscation, comme le masquage des données, peuvent également être utiles.
Chiffrer et hacher les données
Le chiffrement est l’une des méthodes les plus anciennes pour protéger les informations sensibles. Différentes techniques de chiffrement permettent de protéger les données en transit et au repos. Si vous utilisez des tables SQL pour stocker un grand volume de données, envisagez des méthodes de chiffrement transparent des données. Le gouvernement des États-Unis recommande l’algorithme Advanced Encryption Standard (AES) pour sécuriser toutes les données stockées.
Lors du développement de votre application, veillez à transférer les données par des canaux sécurisés. Les données en transit doivent utiliser le protocole Transport Layer Security (TLS) pour empêcher leur interception et leur altération. Vous devriez également limiter le recours aux services publics lors du transfert des données de l’entreprise.
Utiliser des outils de gestion des secrets
Les applications modernes utilisent de nombreux secrets de configuration, comme les accès aux bases de données, les clés de chiffrement des API et les variables d’environnement. Vous devez prévoir leur protection. Un outil robuste de gestion des secrets, comme HashiCorp Vault, permet de les stocker en toute sécurité.
Lorsque vous choisissez un tel outil, privilégiez toutefois une solution qui facilite au maximum la récupération des valeurs. Le stockage des données confidentielles de cette manière réduit la taille des fichiers de configuration et limite le risque de fuite par l’intermédiaire des dépôts.
Limiter les accès
La mise en place de restrictions d’accès peut contribuer à prévenir les fuites et les pertes de données. Ces restrictions consistent à n’accorder l’accès qu’aux personnes qui en ont besoin. Il va sans dire que les employés débutants ne devraient pas disposer des mêmes droits de visibilité que les dirigeants. On parle souvent de contrôle d’accès basé sur les rôles (RBAC) : les employés accèdent uniquement aux informations nécessaires à leurs tâches quotidiennes, tandis que tout autre accès au réseau est limité.
Principe du moindre privilège
Le principe du moindre privilège consiste à n’accorder que le niveau d’accès minimal nécessaire à l’accomplissement du travail. Il s’agit de l’un des moyens les plus efficaces de prévenir les fuites de données, car il permet de gérer de manière centralisée les accès de tous les employés. En limitant les accès des superutilisateurs et des administrateurs, vous réduisez le risque de fuite de données sensibles si les identifiants d’un employé sont divulgués ou consultés par une personne extérieure à l’entreprise, puisque ses accès sont limités.
Quelques étapes clés permettent d’appliquer efficacement le principe du moindre privilège. Il faut notamment créer et gérer un coffre-fort numérique recensant les accès et les droits de chaque utilisateur, ainsi qu’auditer tous les employés de l’entreprise, en particulier les comptes privilégiés. Il convient également de prendre des mesures de précaution pour protéger les mots de passe, les clés SSH et les terminaux.
Authentification à deux facteurs
L’authentification à deux facteurs est une autre pratique courante qui peut aider à prévenir les fuites de données. Elle permet de contrer les attaques par force brute et peut même protéger vos données lorsque des mots de passe faibles seraient autrement le seul obstacle entre un attaquant et un vaste volume de données.
Stockage des données (cloud ou sur site)
Les données peuvent être stockées dans le cloud à l’aide de différents services, comme Microsoft Azure et Amazon Web Services (AWS), ou sur les locaux de l’entreprise, sur des serveurs physiques. La mise en place de procédures adaptées, à la fois techniques et organisationnelles — chiffrement, définition de différentes autorisations utilisateur et absence de transfert de données confidentielles, par exemple — peut vous aider à prévenir les violations de données.
Toutefois, avant de mettre en œuvre ces procédures, vous devez garder à l’esprit le principe de protection de la vie privée dès la conception, que des entreprises comme Snyk appliquent au moyen de différentes normes à l’échelle de l’entreprise. Certaines entreprises choisissent néanmoins de stocker leurs données sur site, en conservant hors ligne les données les plus sensibles et en ne les rendant accessibles qu’en cas de besoin.
Protection de la vie privée dès la conception
L’expression protection de la vie privée dès la conception signifie qu’il faut tenir compte de la confidentialité dès le début du développement logiciel, que vous travailliez sur un correctif ou sur un tout nouveau projet. Plusieurs guides et certifications permettent aux entreprises de s’assurer qu’elles font tout leur possible pour prévenir les attaques et les fuites de données. Vous pouvez, par exemple, demander la certification ISO 27001, une norme qui protège toutes les informations présentes dans le cloud, sur des supports physiques ou numériques, ainsi que sur les machines virtuelles et les appareils de l’entreprise.
Logiciels de prévention des pertes de données
Plusieurs entreprises s’appuient sur des logiciels de sécurité pour prévenir les pertes et les fuites de données. La plupart des logiciels de protection contre les pertes de données, comme BetterCloud et Symantec, visent à bloquer certaines actions — notamment en empêchant les utilisateurs d’effectuer des actions via des périphériques de stockage USB ou de télécharger accidentellement des logiciels malveillants. D’autres entreprises utilisent des pare-feu pour protéger l’ensemble de leur environnement technologique, chiffrent tous leurs dépôts afin de prévenir les fuites malveillantes ou recourent à l’authentification à deux facteurs pour permettre aux employés de se connecter à leurs comptes professionnels. Toutes ces mesures limitent le risque que des données et des informations sensibles ou critiques soient partagées en dehors de l’entreprise.
Limiter la gravité d’une fuite de données
Les entreprises cherchent souvent à réduire le volume de données stockées afin de limiter la gravité des fuites. L’article 5, paragraphe 1, point c), du Règlement général sur la protection des données (RGPD) de l’Union européenne impose des procédures de minimisation des données, comme la suppression automatique des anciennes données. Par exemple, si l’entreprise XYZ Ltd. compte des clients qui n’ont pas été fidélisés et ne sont pas revenus depuis, disons, dix ans, toutes leurs données peuvent et doivent être effacées.
Comment Snyk lutte contre les pertes de données
Snyk est une plateforme sécurisée destinée aux développeurs, qui s’intègre directement à leurs outils et apporte à l’entreprise la sécurité nécessaire pour l’ensemble de sa pile technologique et du cycle de vie du développement, en appliquant le principe de protection de la vie privée dès la conception évoqué précédemment. Snyk adopte une approche axée sur les développeurs : la plateforme s’intègre directement au pipeline utilisé par les développeurs afin d’ajouter la sécurité dès les toutes premières étapes du développement, là où le code est créé et régulièrement mis à jour. Ainsi, le code est sécurisé dès le départ, tout comme l’ensemble de l’environnement grâce à Snyk Container, qui vous permet de conditionner vos applications et détecte les vulnérabilités qu’elles pourraient contenir.
Le transfert de tous les commits via Snyk Cloud apporte une couche de sécurité supplémentaire à celles évoquées précédemment. Grâce à l’intégration avec Amazon Web Services (AWS), Azure, Google Cloud, Terraform, AWS CloudFormation, Kubernetes, Docker et Open Policy Agent (OPA), des instantanés sont créés à intervalles réguliers pour prévenir les pertes de données et garantir que votre implémentation reste à jour avec les dernières politiques en vigueur, grâce à une synchronisation automatique avec les normes les plus récentes.
Pour le code open source, Snyk analyse et surveille les éventuelles vulnérabilités à chaque étape du pipeline et du processus de gestion des mises en production. Grâce à des rapports en temps réel et historiques, Snyk détecte les vulnérabilités et les risques de sécurité depuis l’installation initiale du code open source, pendant son exécution et jusqu’à son déploiement.
Réduire le risque de fuite de données
Les violations de données compromettent vos données et peuvent avoir de lourdes conséquences : pertes financières, usurpation d’identité, humiliation, atteinte à la réputation ou rupture de contrats. Les fuites peuvent même avoir des conséquences plus graves encore, jusqu’à entraîner la mort. Mettre en place les procédures adaptées, notamment les normes ISO 27000, le contrôle d’accès basé sur les rôles (RBAC) et la protection de la vie privée dès la conception, vous aide, vous et votre entreprise, à éviter une catastrophe.
Vous pouvez également utiliser les outils d’entreprises comme Snyk pour protéger votre entreprise, vos employés et leurs familles. Snyk propose plusieurs produits qui contribuent à prévenir les pertes de données, quels que soient le pipeline de données ou l’infrastructure que vous utilisez. Essayez Snyk gratuitement dès aujourd’hui !
Apprécié par les développeurs. Les équipes de sécurité lui font confiance.
Les outils Snyk, conçus pour les développeurs, offrent une sécurité intégrée et automatisée qui répond à vos exigences de gouvernance et de conformité.